MPC2026 · 明道云伙伴大会 · 伙伴路演
乾行博远:HAP 把应用建起来,智能运维让底座稳定在线。
内容摘要
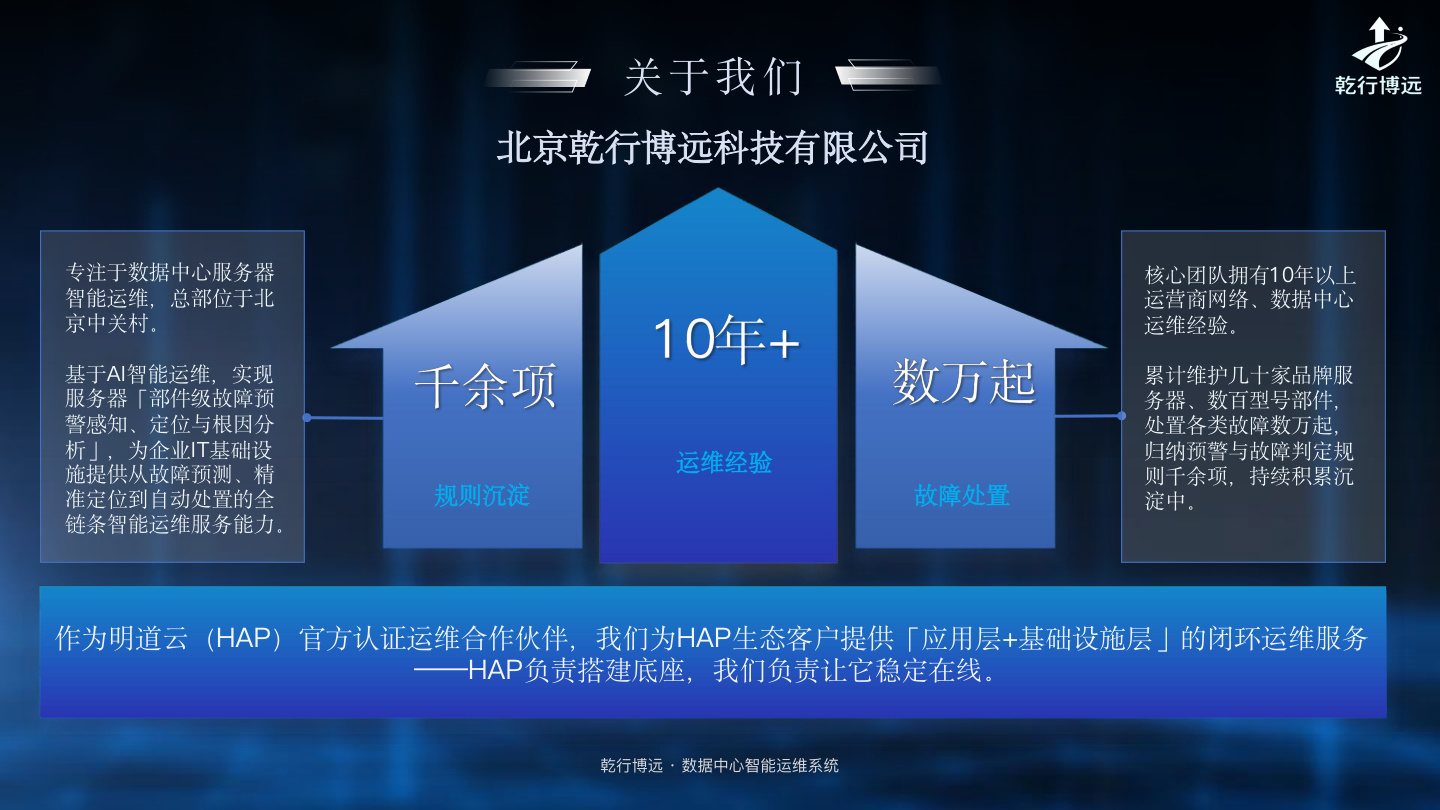
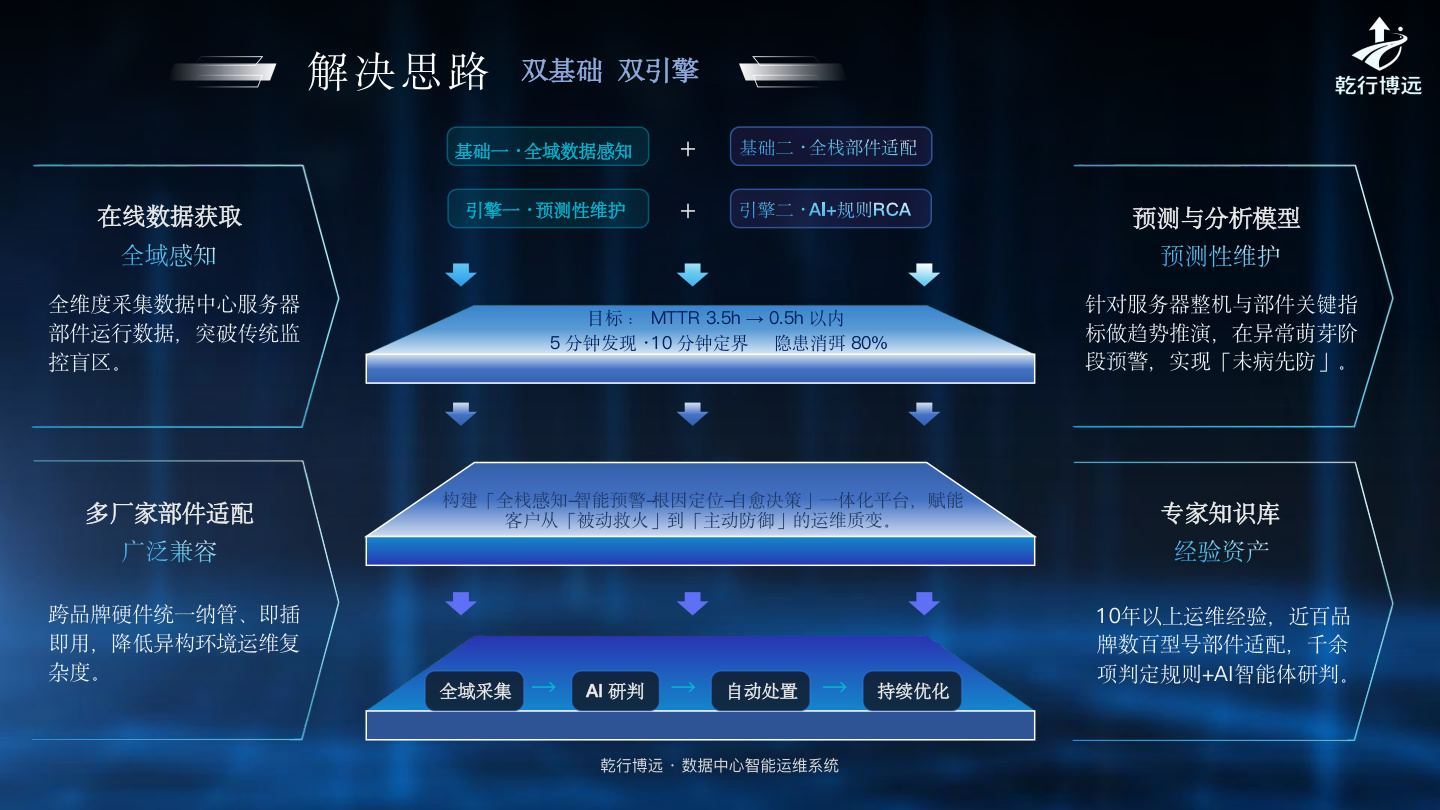
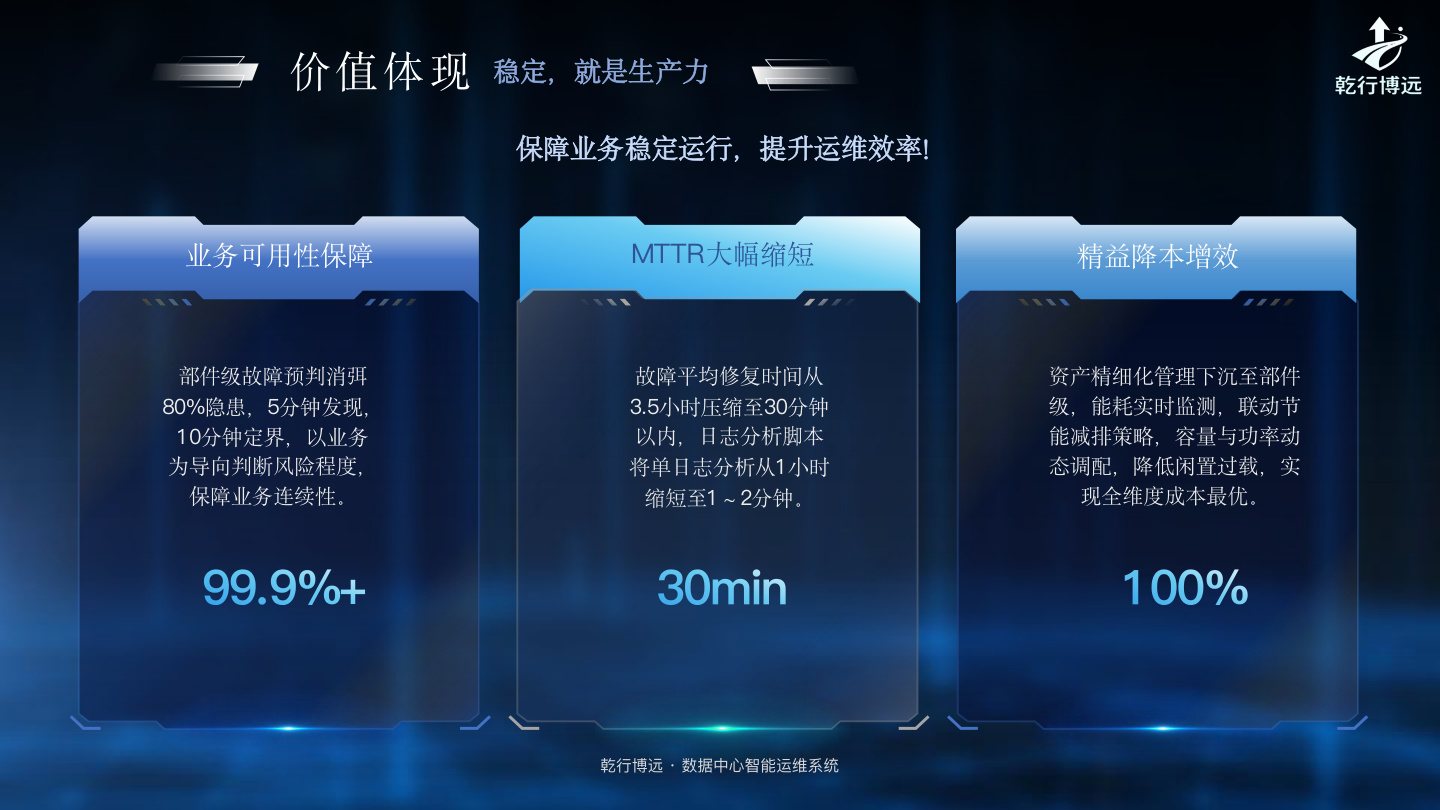
程亚琪介绍乾行博远作为明道云 HAP 官方认证运维合作伙伴,做数据中心服务器智能运维:部件级故障预警、定位与根因分析。核心团队 10 年以上运营商网络与数据中心经验,累计维护几十家品牌、数百型号部件,处置故障数万起,归纳判定规则千余项。行业痛点写成平均处置 3.5~5 小时、有效告警识别率不足 5%。目标页写 MTTR 从 3.5 小时压到 0.5 小时以内,5 分钟发现、10 分钟定界、隐患消弭 80%。价值页写 MTTR 压到 30 分钟以内、单日志分析从 1 小时到 1~2 分钟。本稿按公开幻灯片整理,机器转写未全文听校。
关键事实
- 定位HAP 官方认证运维合作伙伴;HAP 搭应用,乾行博远让基础设施稳定在线。总部北京中关村。
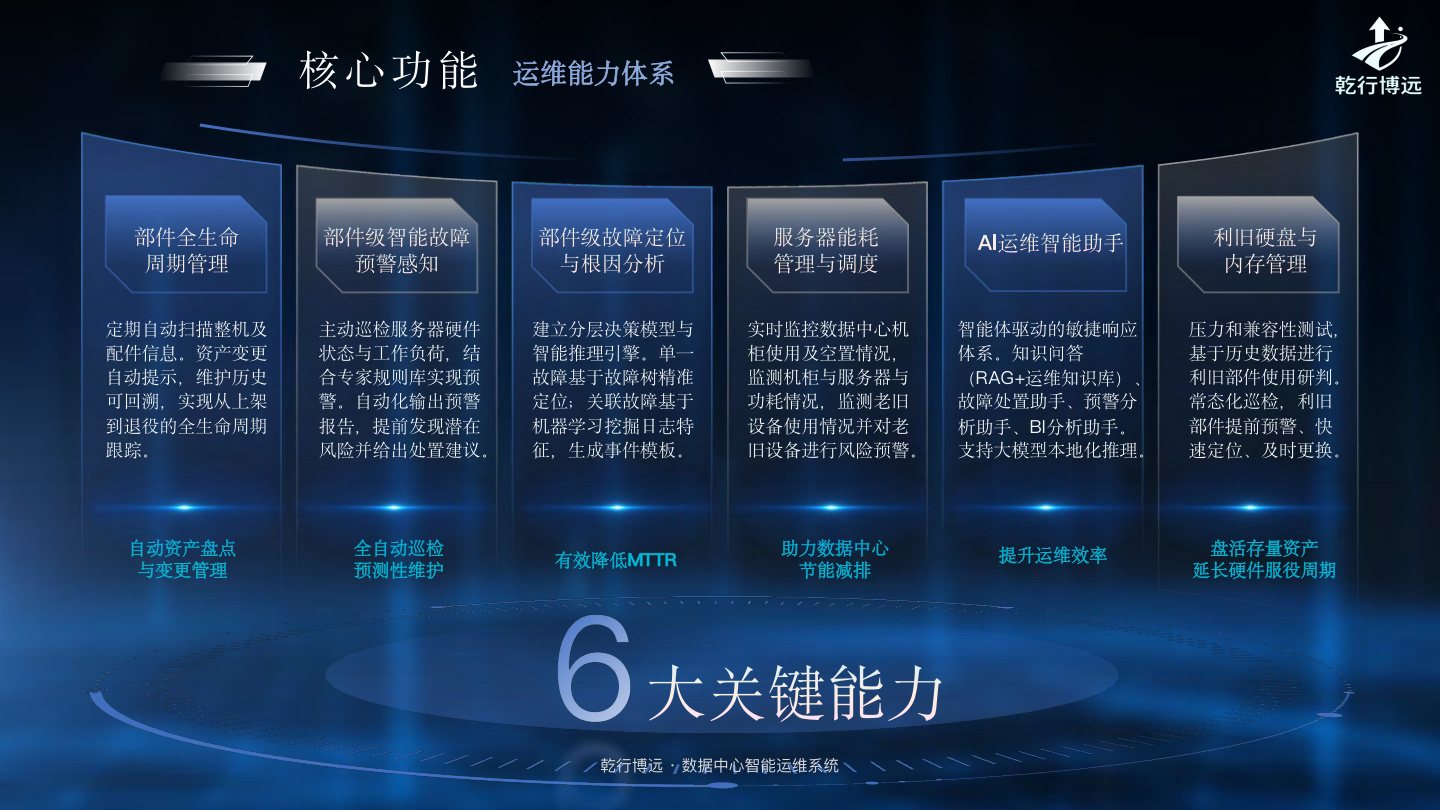
- 能力部件级故障预警感知、定位与 RCA;预测、定位到自动处置。团队 10 年以上运维经验;几十家品牌、数百型号;故障数万起;规则千余项。
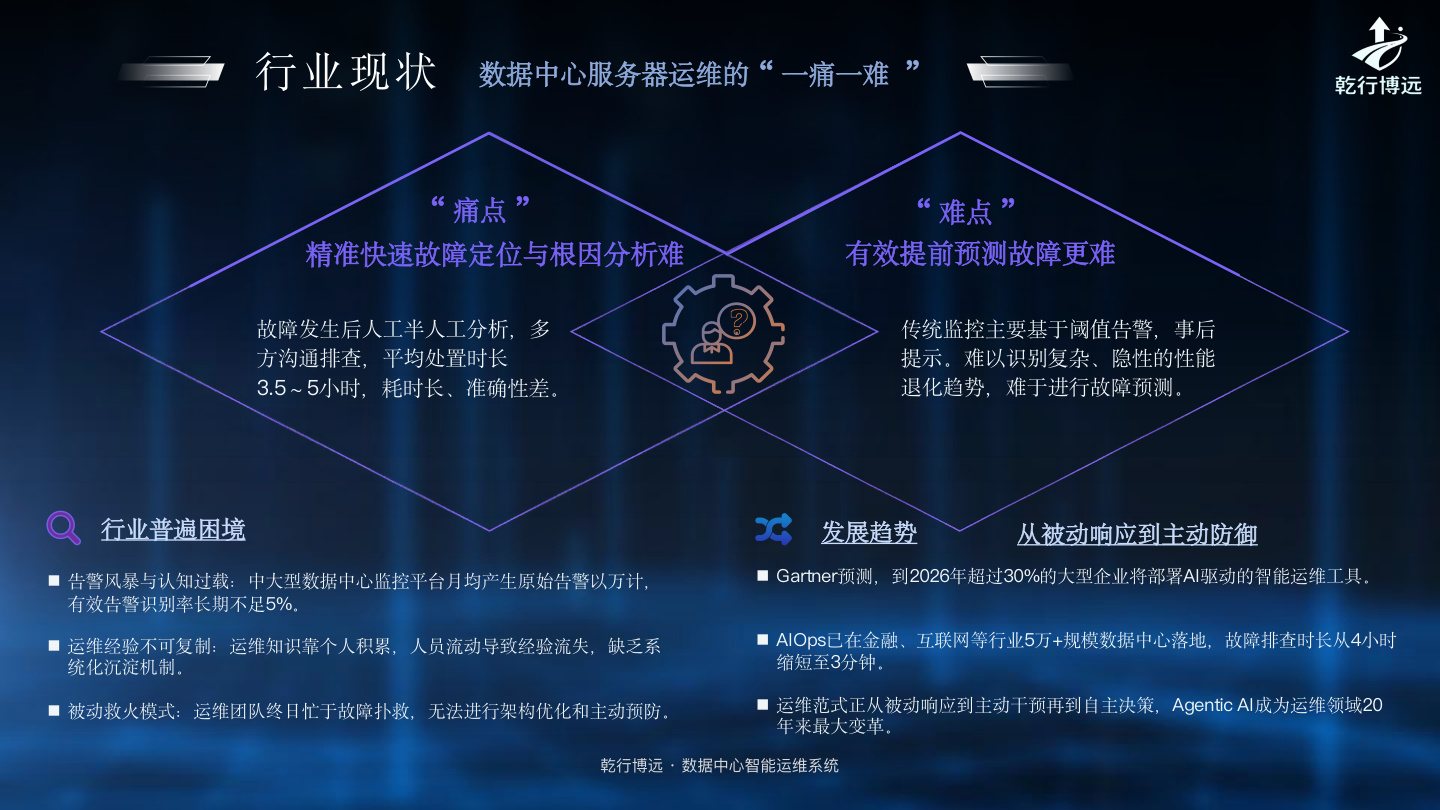
- 行业处置时长 3.5~5 小时;月均原始告警以万计,有效识别率长期不足 5%;经验靠个人;被动救火。幻灯片引 Gartner:到 2026 年超 30% 大型企业将部署 AI 驱动智能运维。
- 目标MTTR 3.5h → 0.5h 以内;5 分钟发现、10 分钟定界;隐患消弭 80%。
- 价值页部件级预判消弭 80% 隐患;MTTR 3.5 小时到 30 分钟以内;日志分析 1 小时到 1~2 分钟。
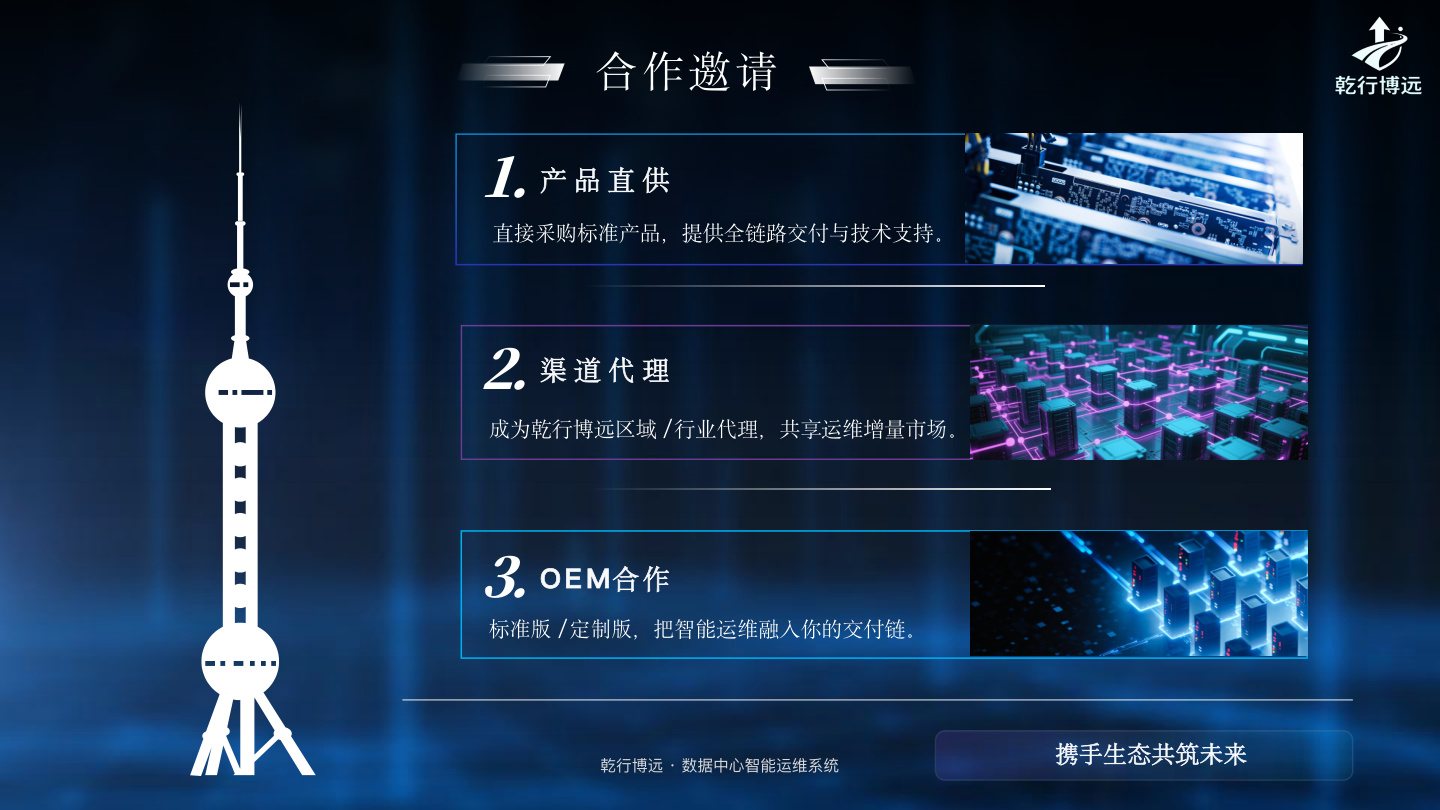
- 合作产品直供、渠道代理、OEM。
演讲资料
演讲视频
演讲文字整理稿
应用再快也要稳的底座
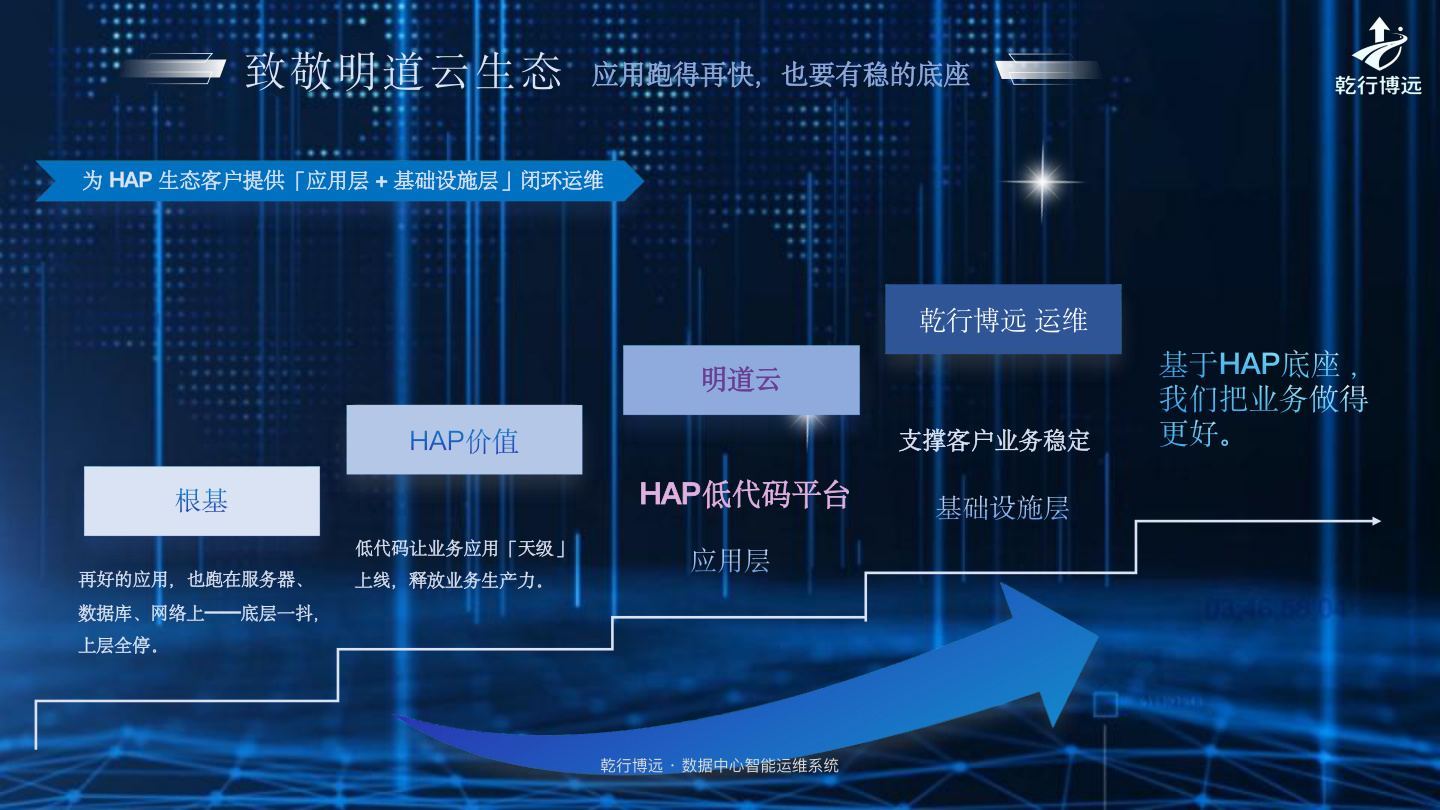
封面主题是预测性维护与 AI 规则 RCA 双引擎。低代码让应用天级上线,但应用仍跑在服务器、数据库和网络上,底层一抖上层全停。乾行博远把生态位置写成:大家把应用建起来,他们补基础设施层。
一痛一难
痛是故障后人工排查 3.5~5 小时;难是阈值告警看不出隐性退化。困境是告警风暴、经验不可复制、被动救火。思路是全域采集加专家规则与 AI 智能体,再加预测模型和跨品牌适配。
平台和案例类型
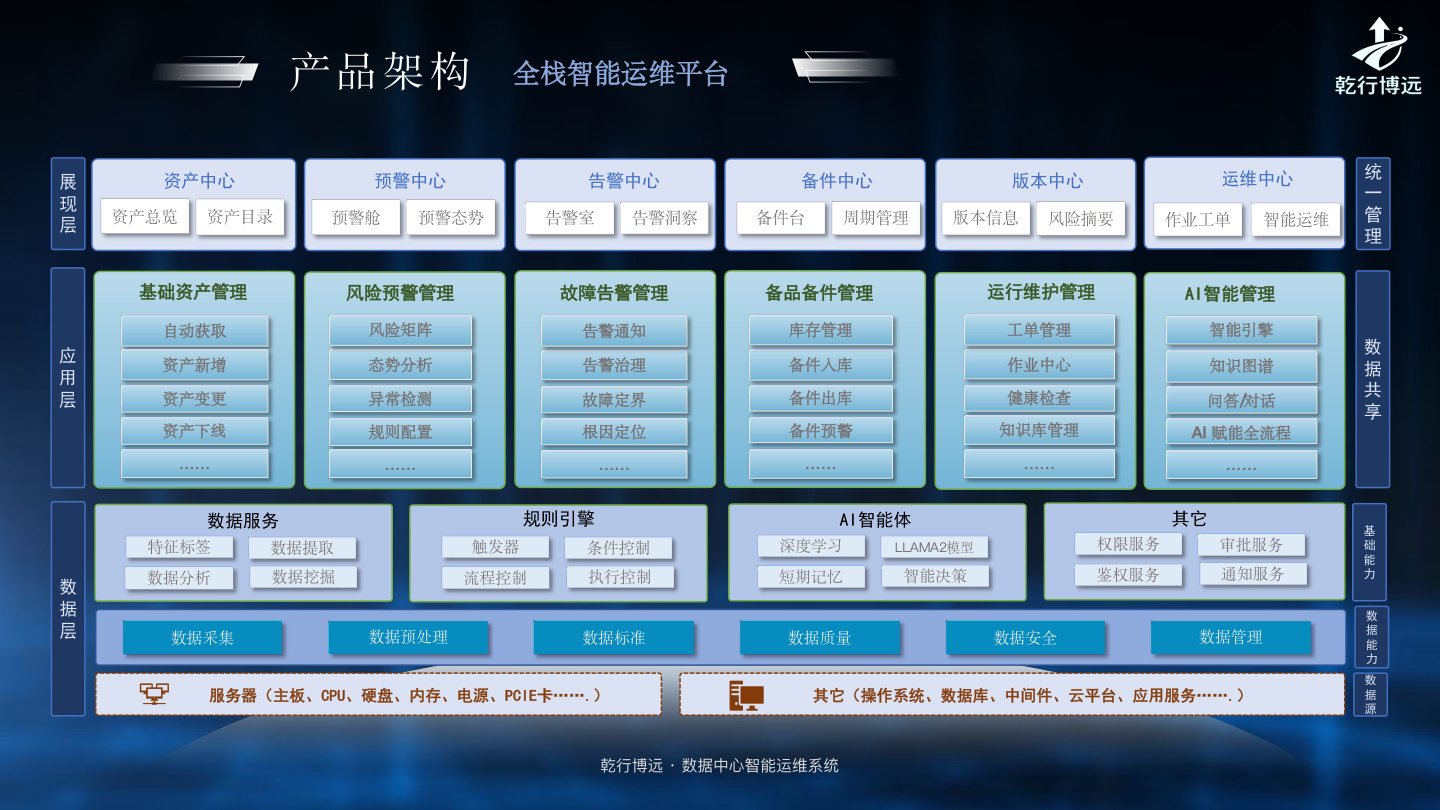
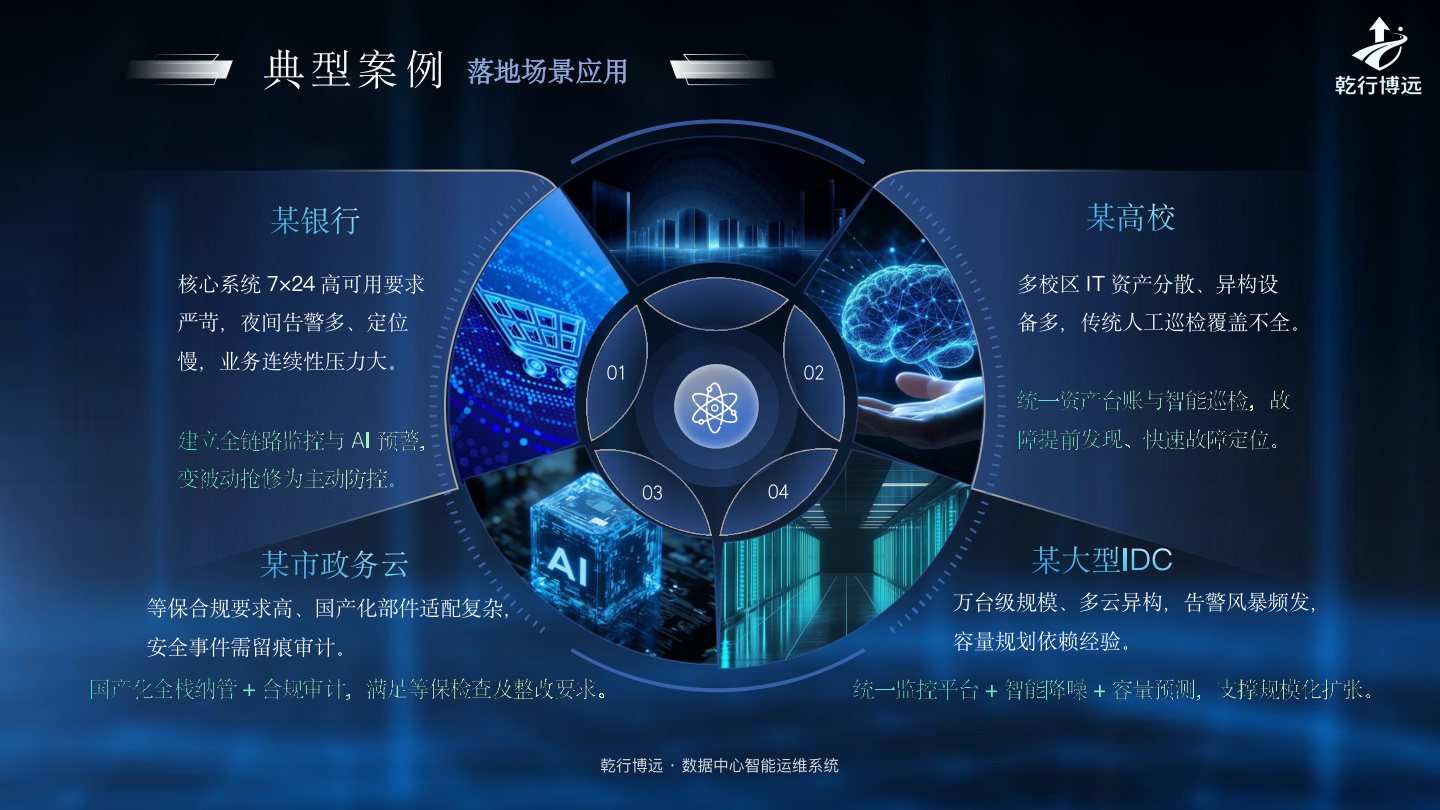
架构覆盖服务器部件到 OS、数据库、中间件和云平台,上面是巡检、资产、预警、告警、备件、工单和本地化大模型助手。案例类型写金融级 7×24、多校区异构、等保国产化、万台多云告警风暴四类场景,页面未写客户真名。合作三种:直供、代理、OEM。
重点问答
0.5 小时和 30 分钟为什么两处不一样?
根据不同页,0.5 小时是「目标」;30 分钟是「价值体现」里对 MTTR 的表述。不要合成一个已经普遍达成的数字。
乾行博远和 HAP 实施伙伴怎么分工?
根据致敬页,HAP 伙伴做应用层;乾行博远做服务器与基础设施智能运维,定位是互补而不是抢实施单。
80% 隐患指什么?
根据目标与价值页,是部件级故障预判「消弭隐患」的披露口径,页面未给出统计样本和统计期。