HDP V3.0:把 API 接入、看懂数据和 Pipe Studio 连成一条让数据流动的链路。
内容摘要
田然介绍 HDP V3.0,主线是先把外部 API 变成可同步的数据源,再在 Data Explorer 里看懂库表关系与数据,最后用 Pipe Studio 把取数、加工和写入连成可发布的同步任务。API 接入按导入文档、鉴权连接、数据对象验证、同步创建四步组织;浏览器提供关联下钻、ER 图、结构语义化、AI 查 SQL 和一句话出图并发布到 HAP;Pipe Studio 用无限画布和 16 种节点处理口径与链路,并可按手动、定时或实时发布。本稿按公开幻灯片整理,未经口播听校。
关键事实
- 产品HDP V3.0,标题为「看懂数据,让数据流动」。
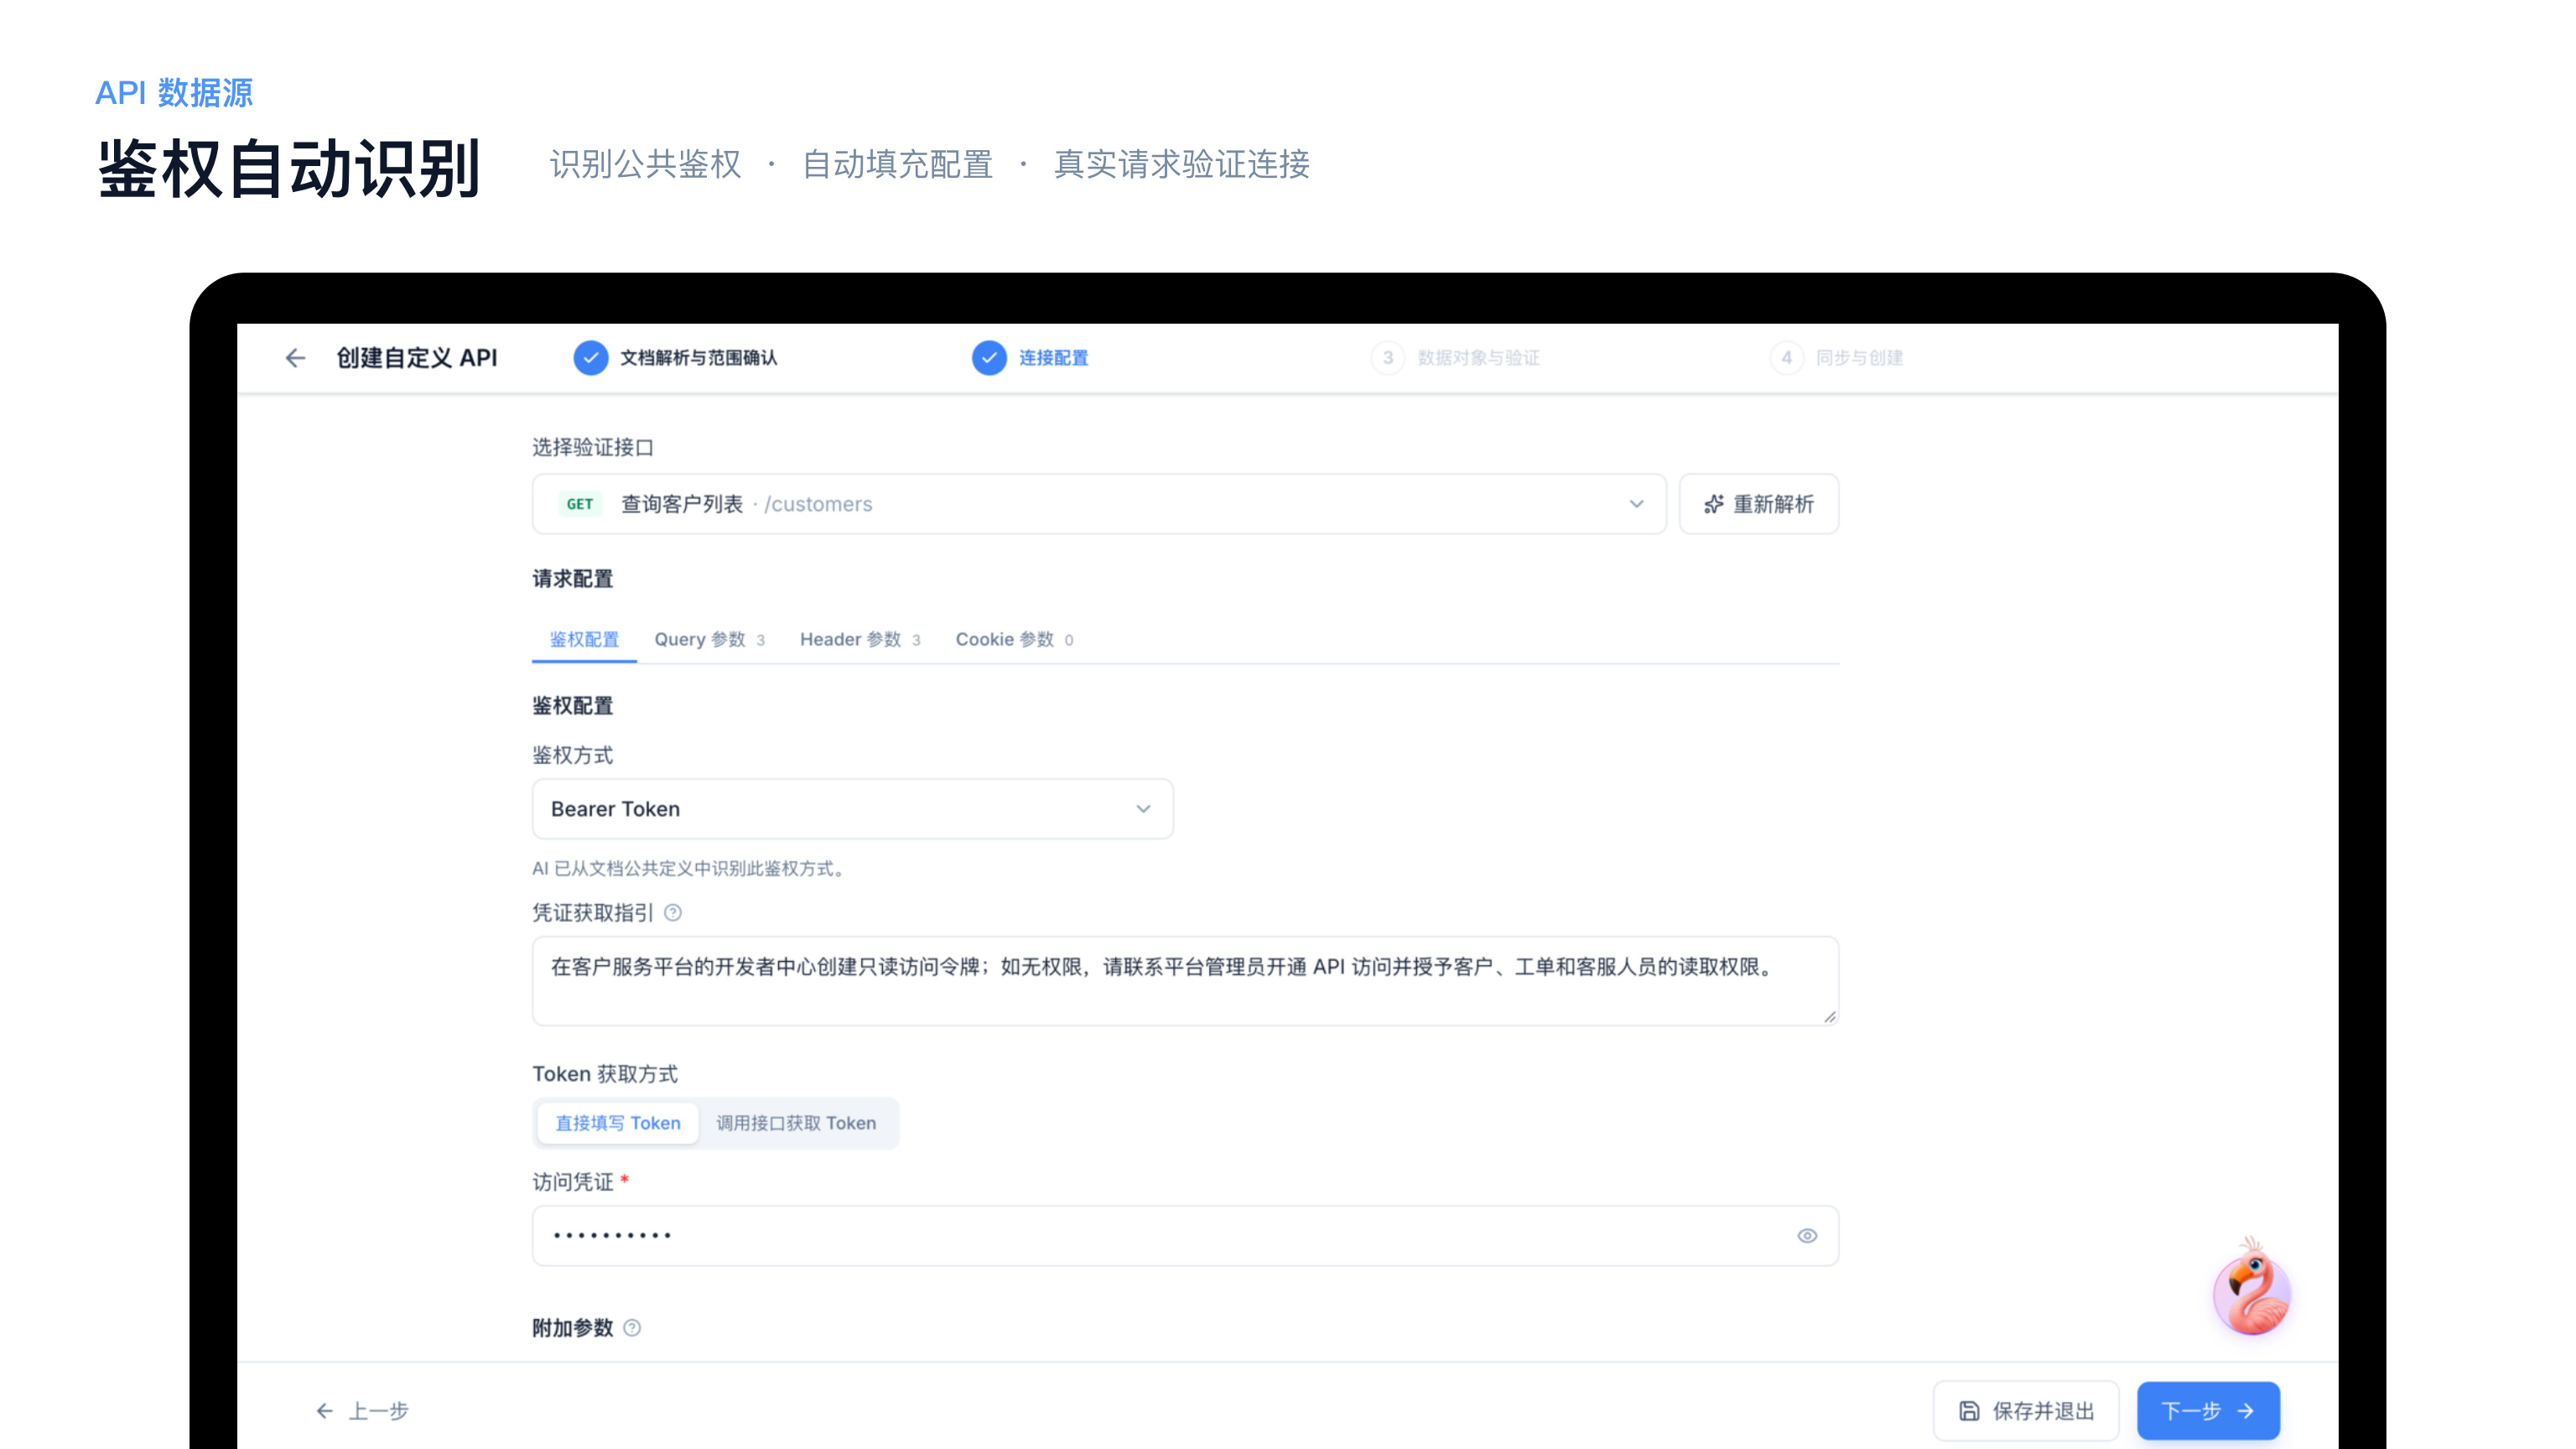
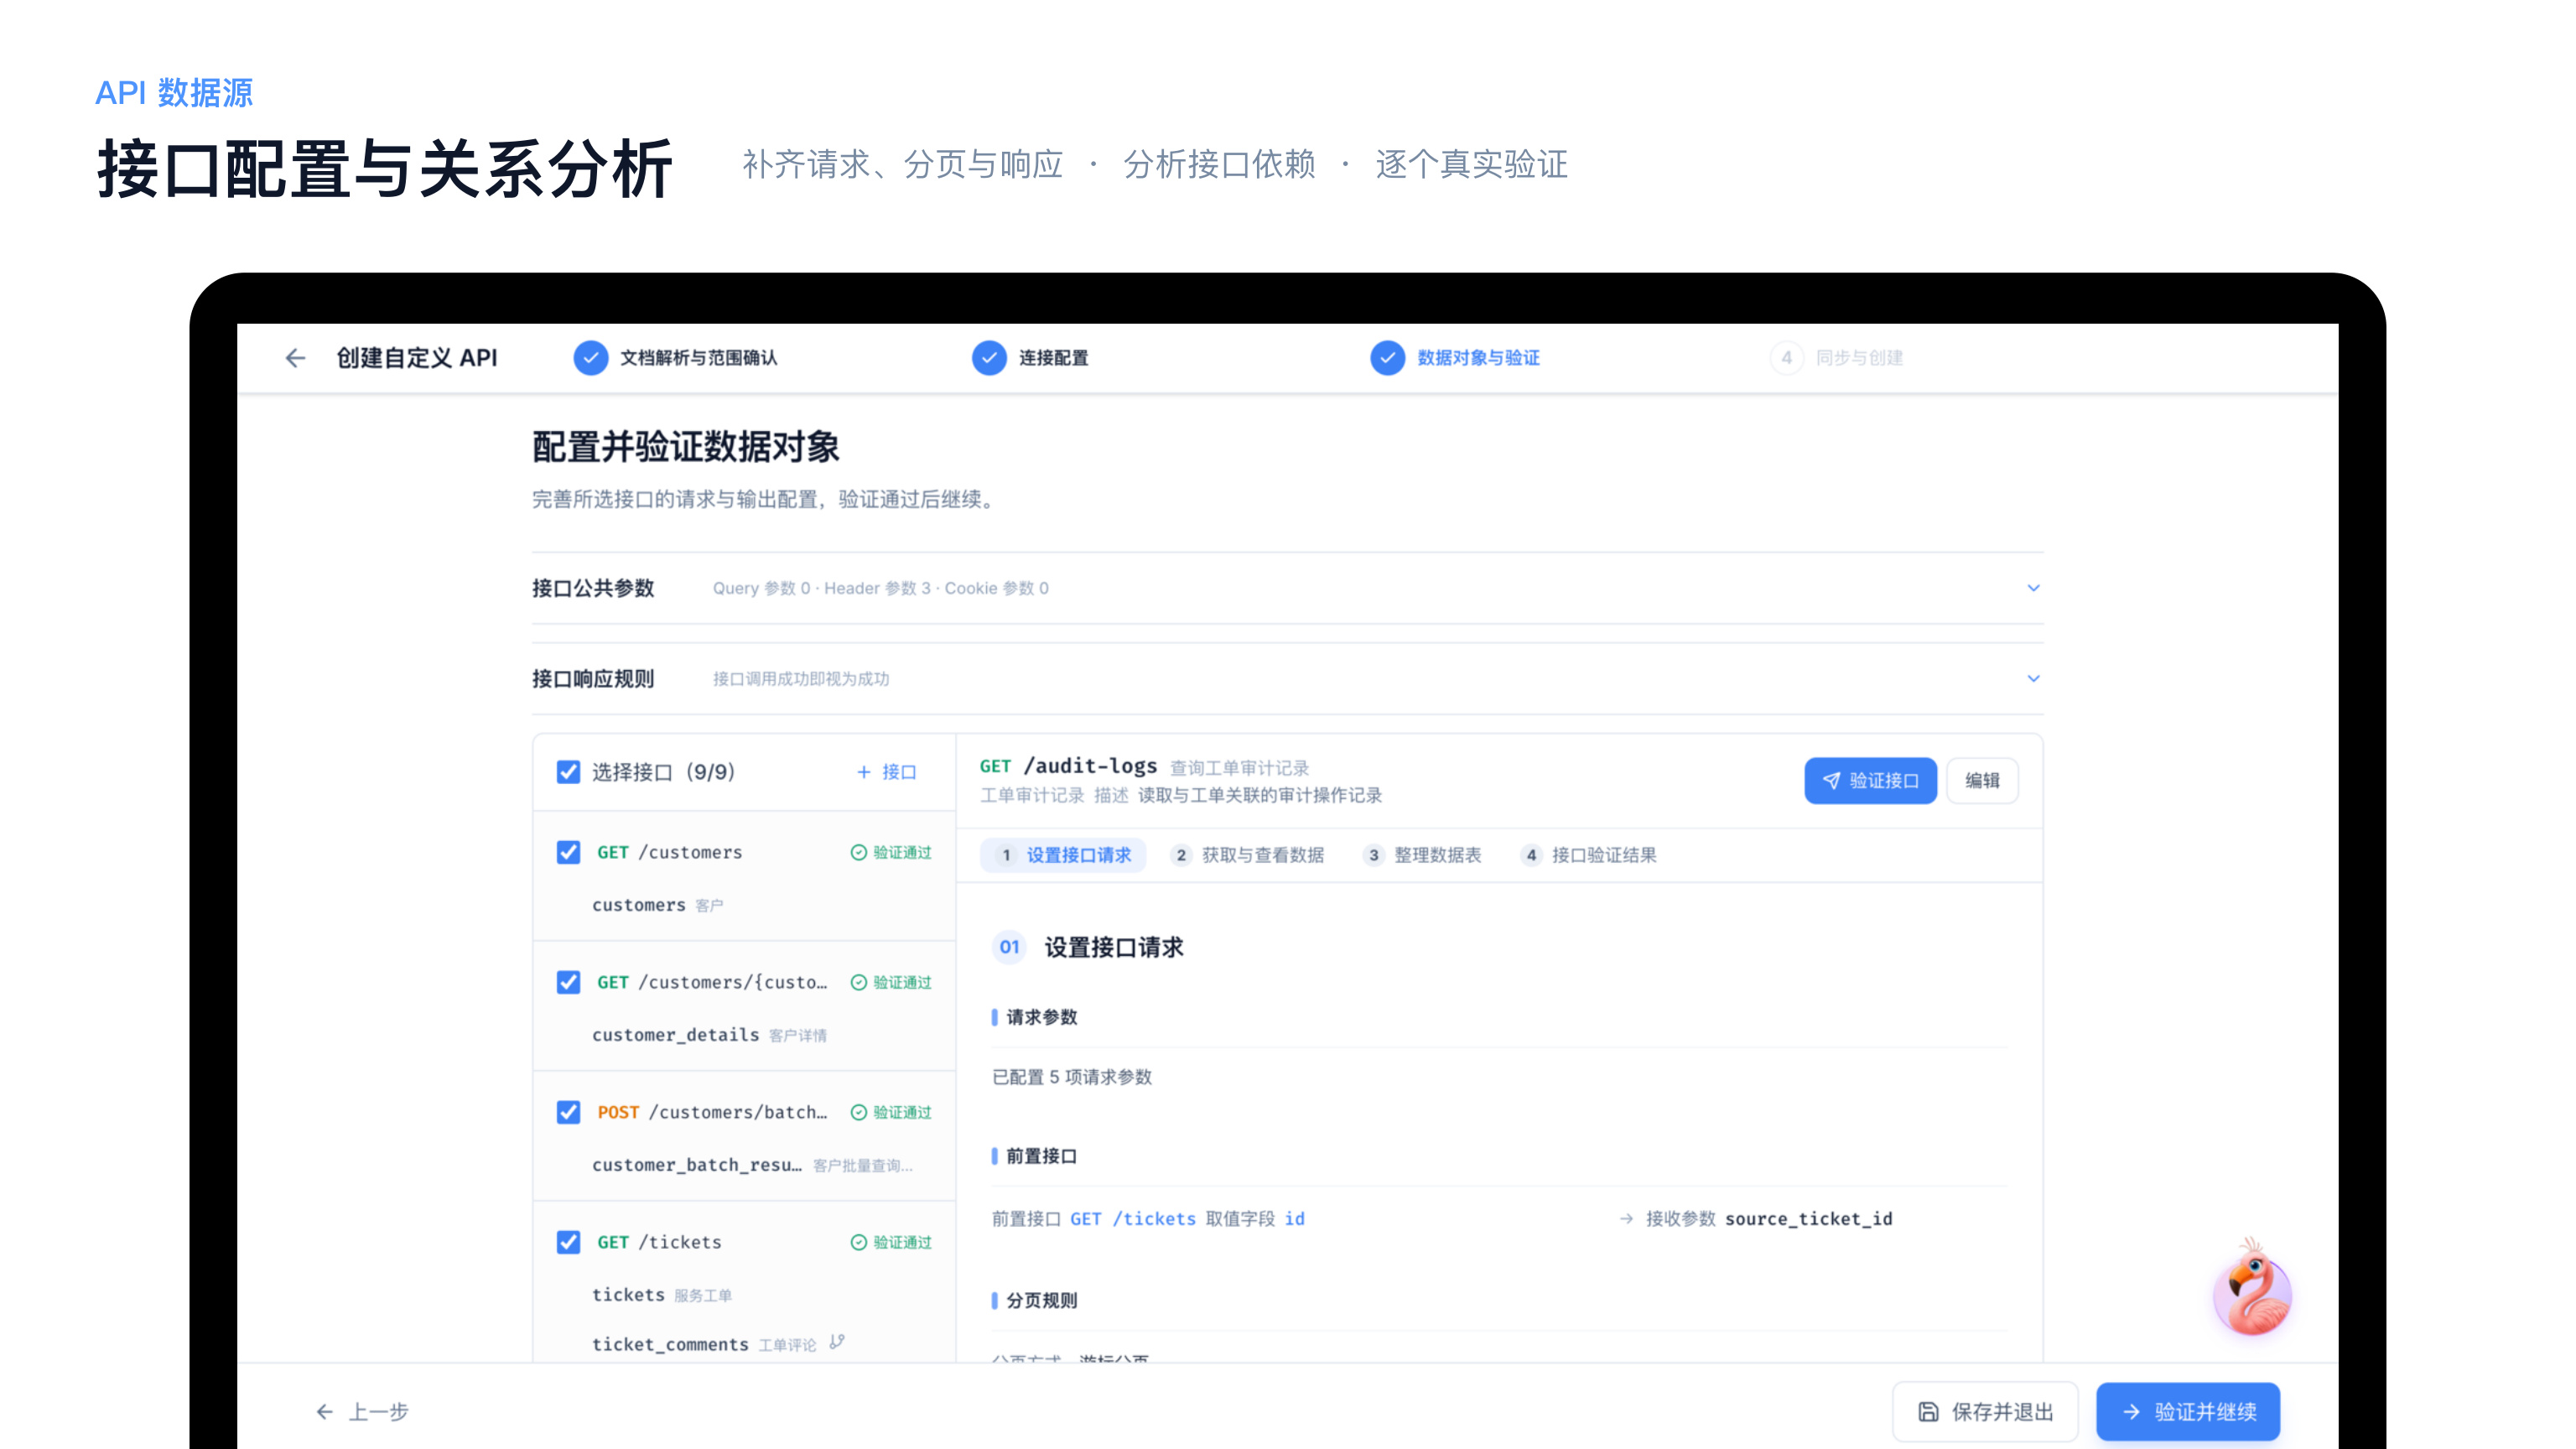
- API 四步接入导入文档并生成接口清单、识别公共鉴权并验证连接、补齐请求/分页/响应并逐个真实验证、全部验证通过后创建并自动首次同步。
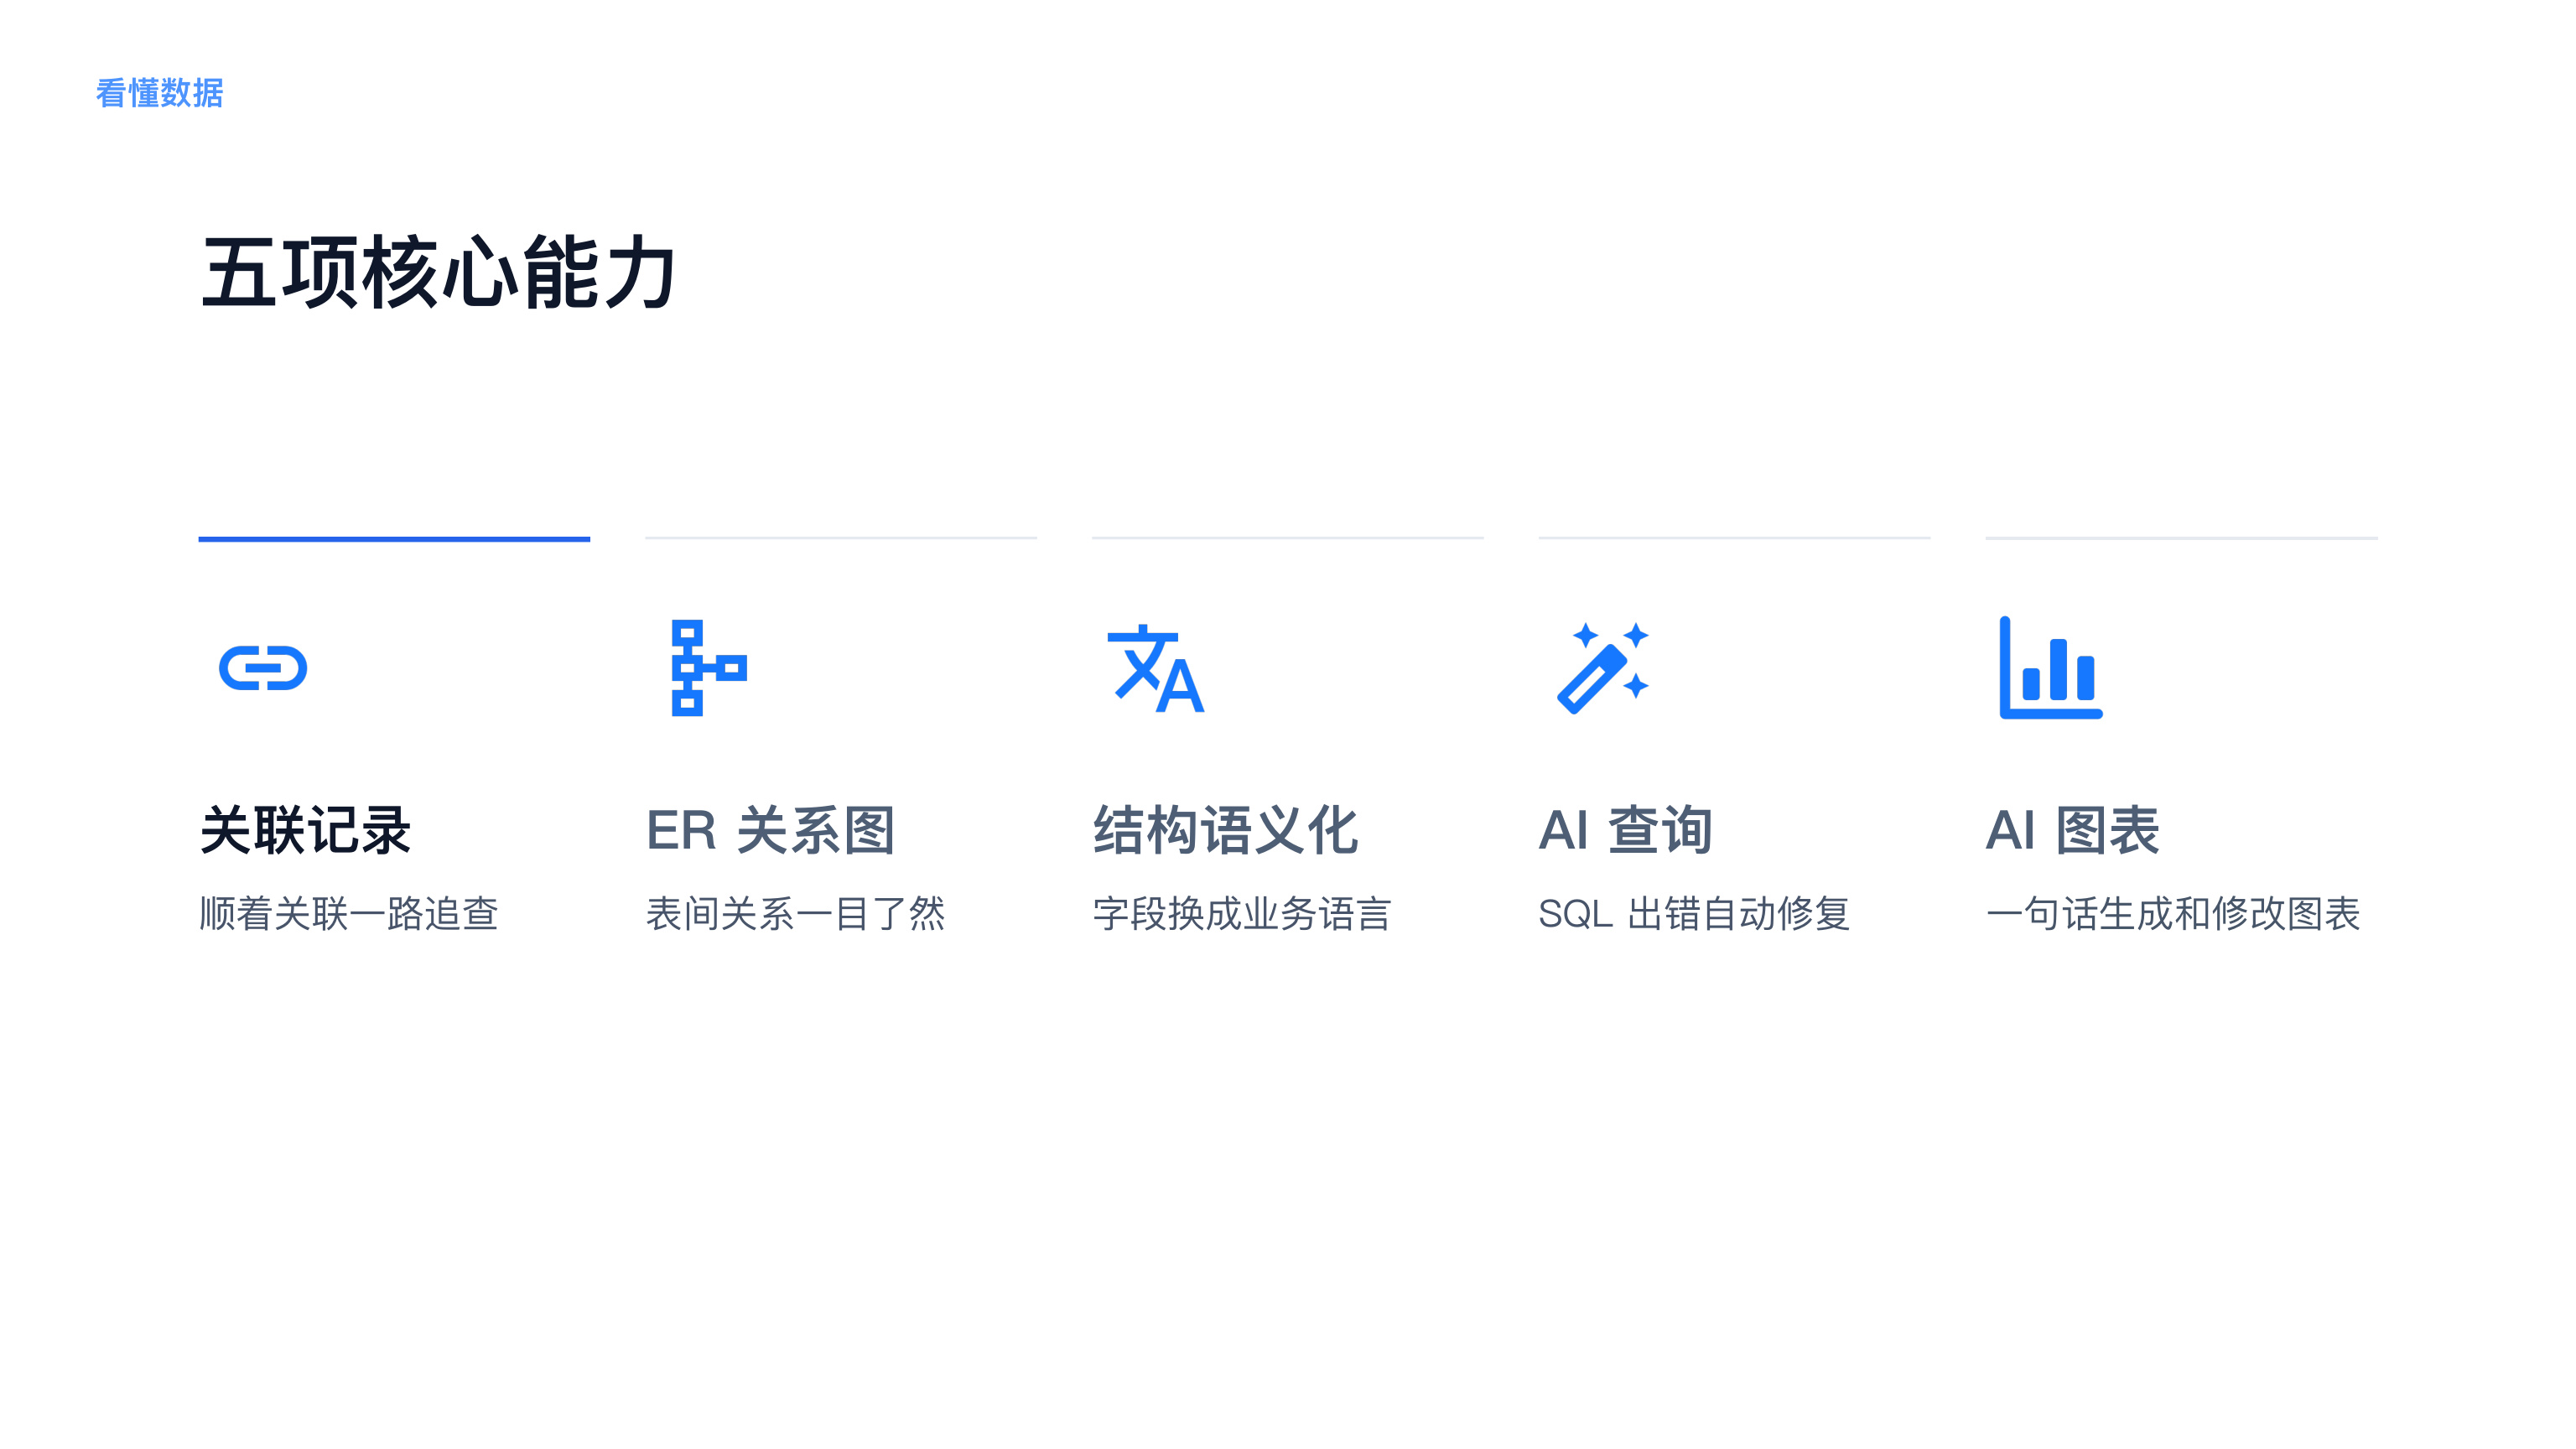
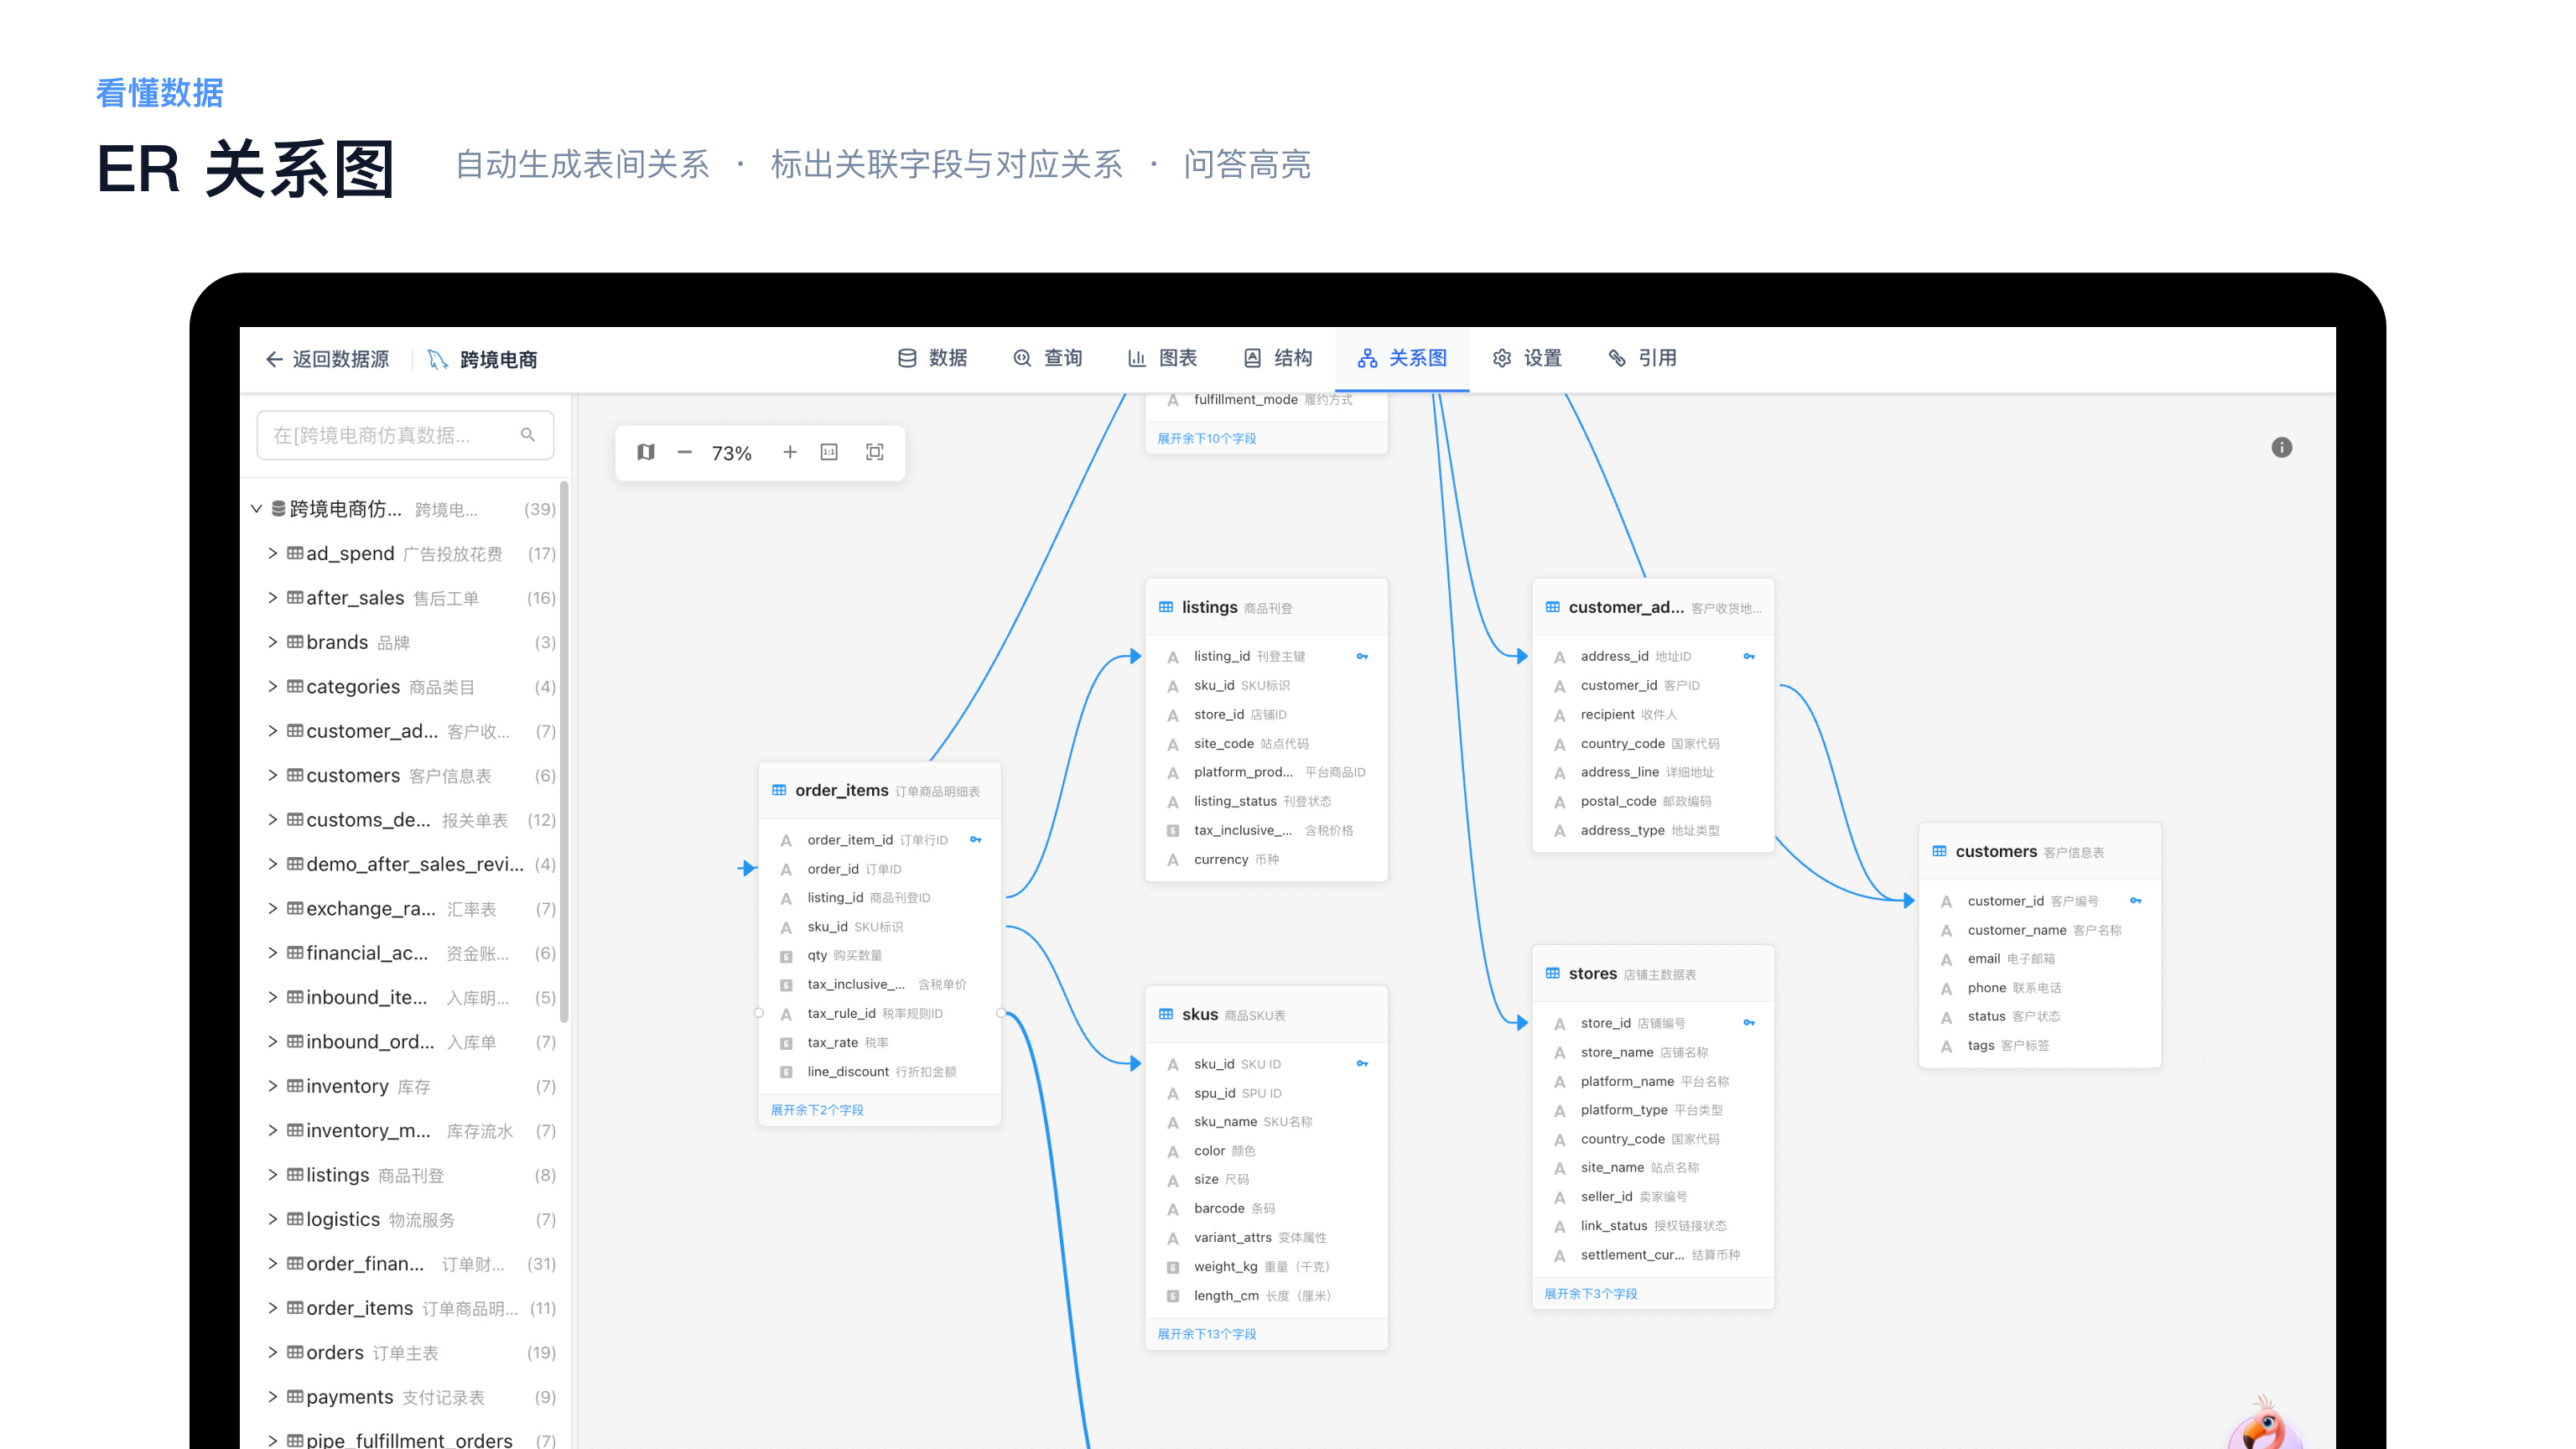
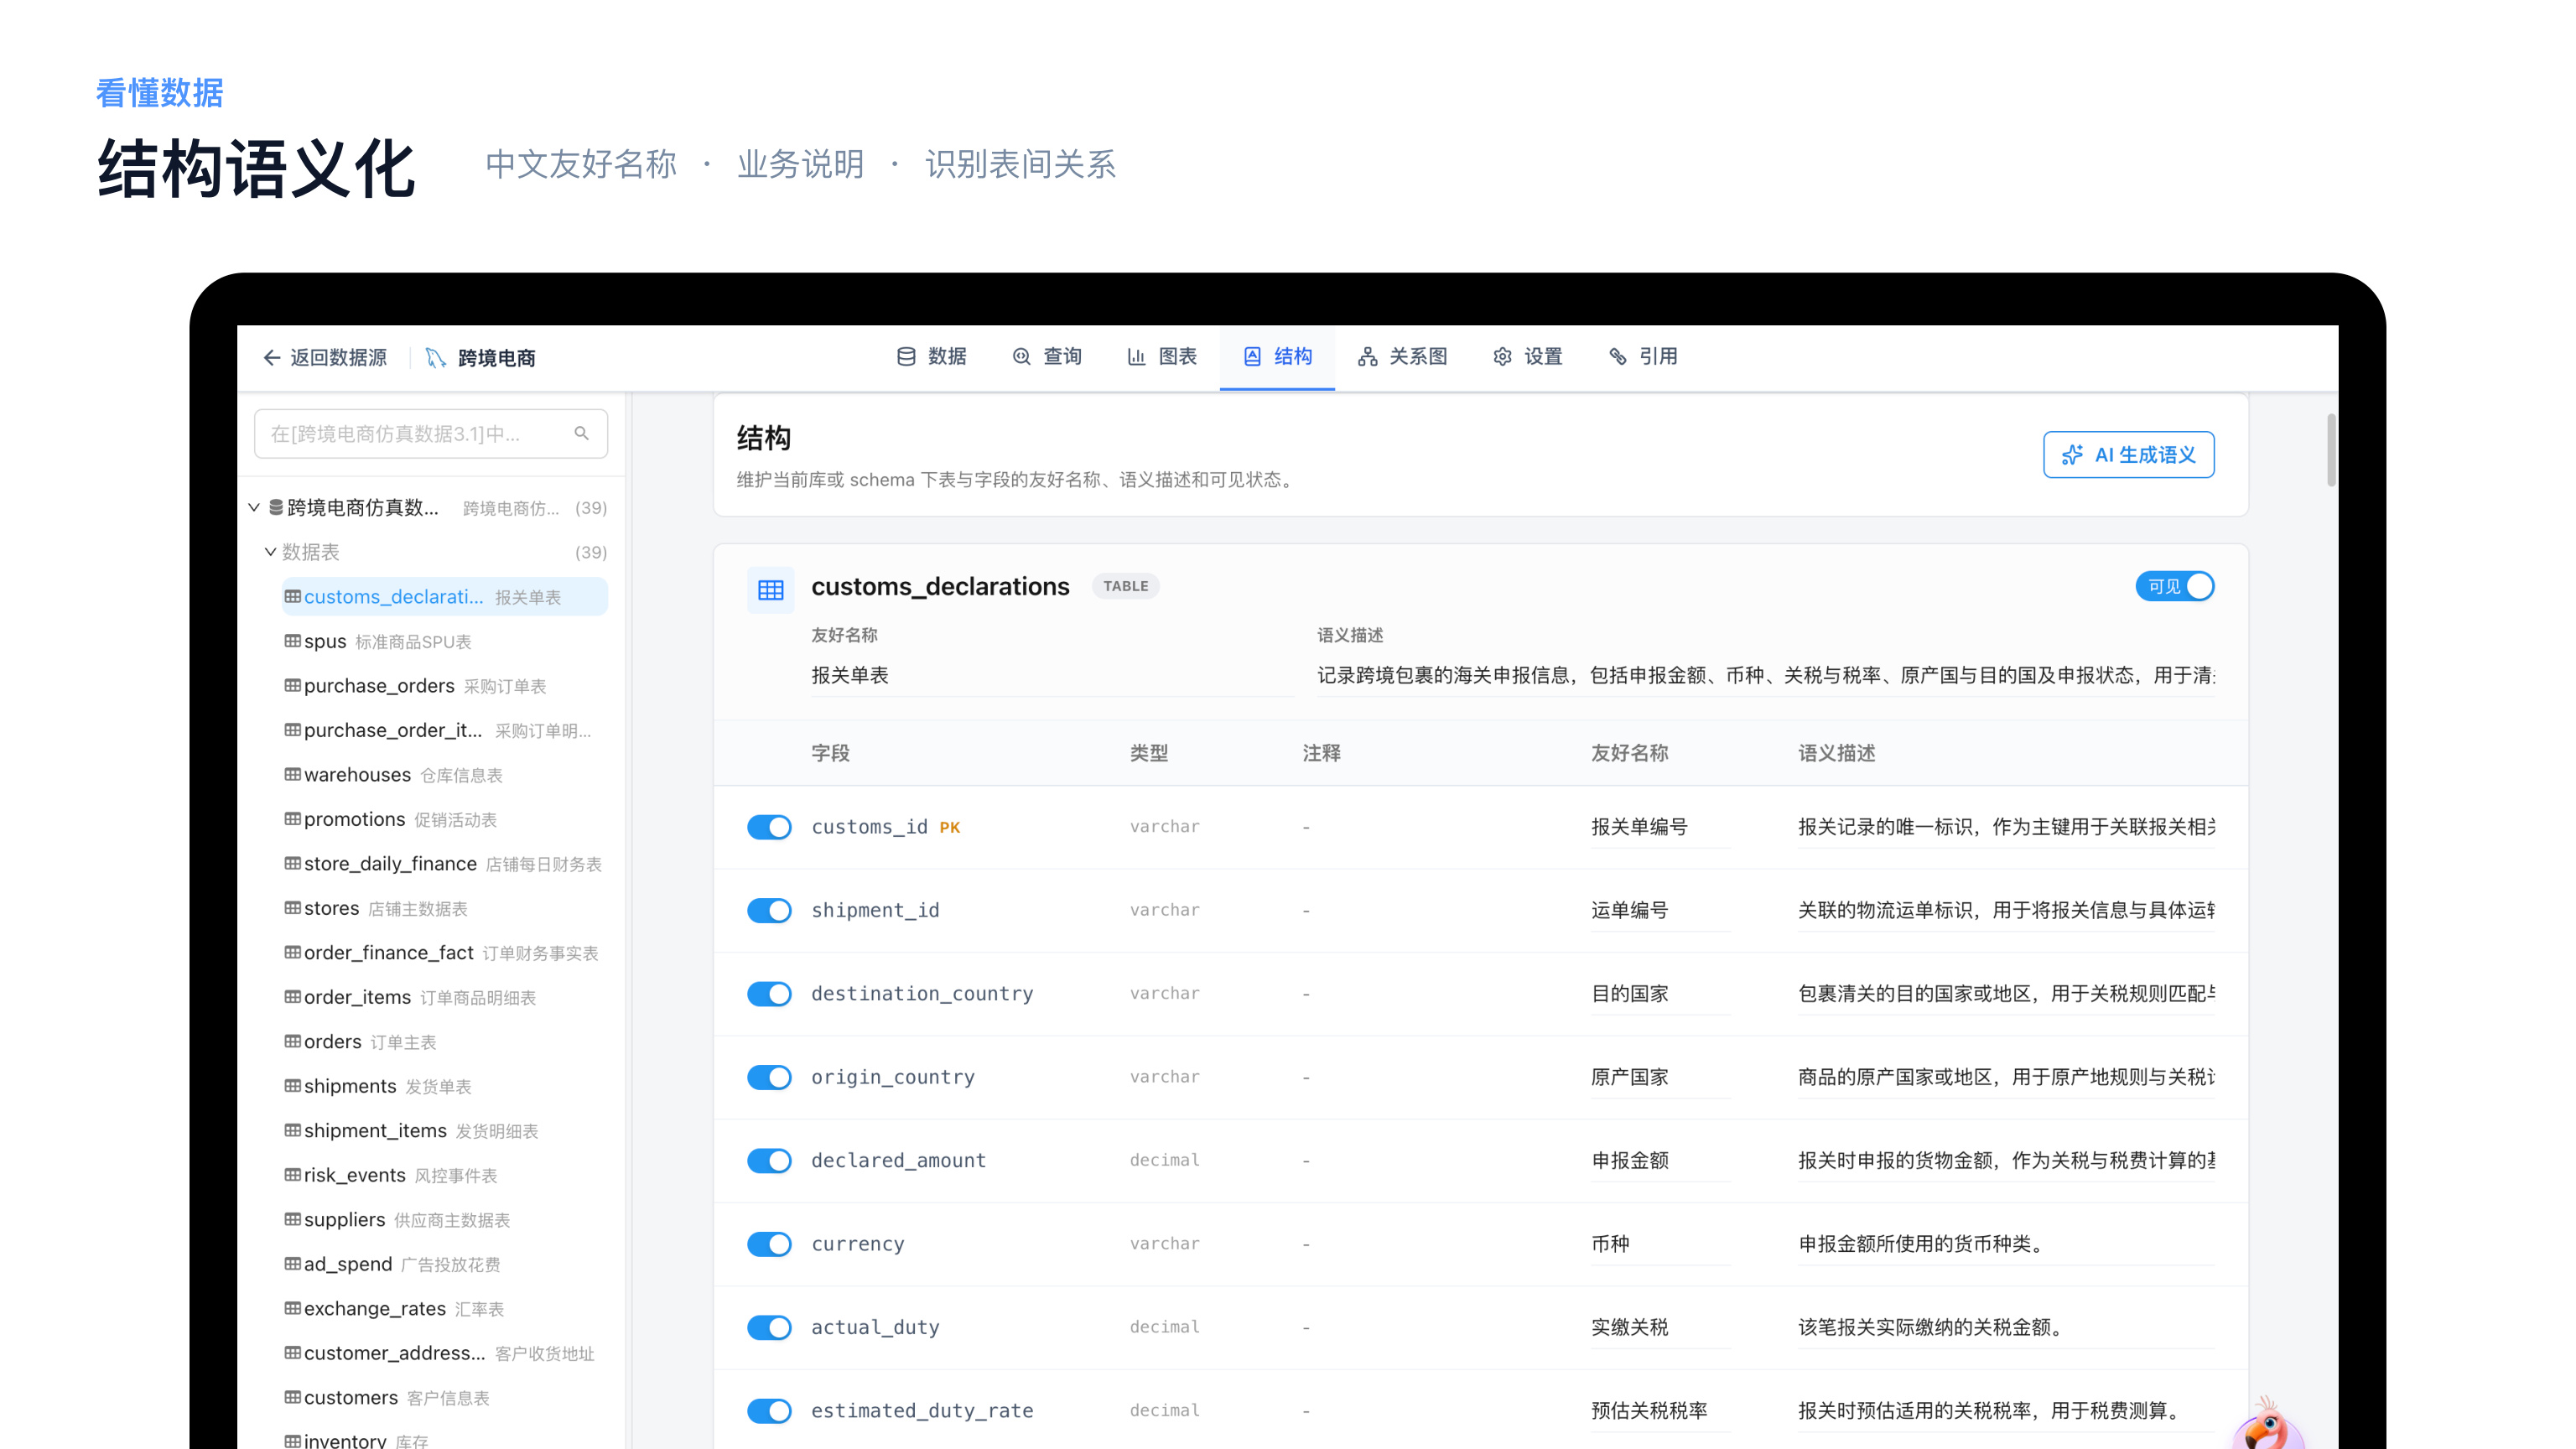
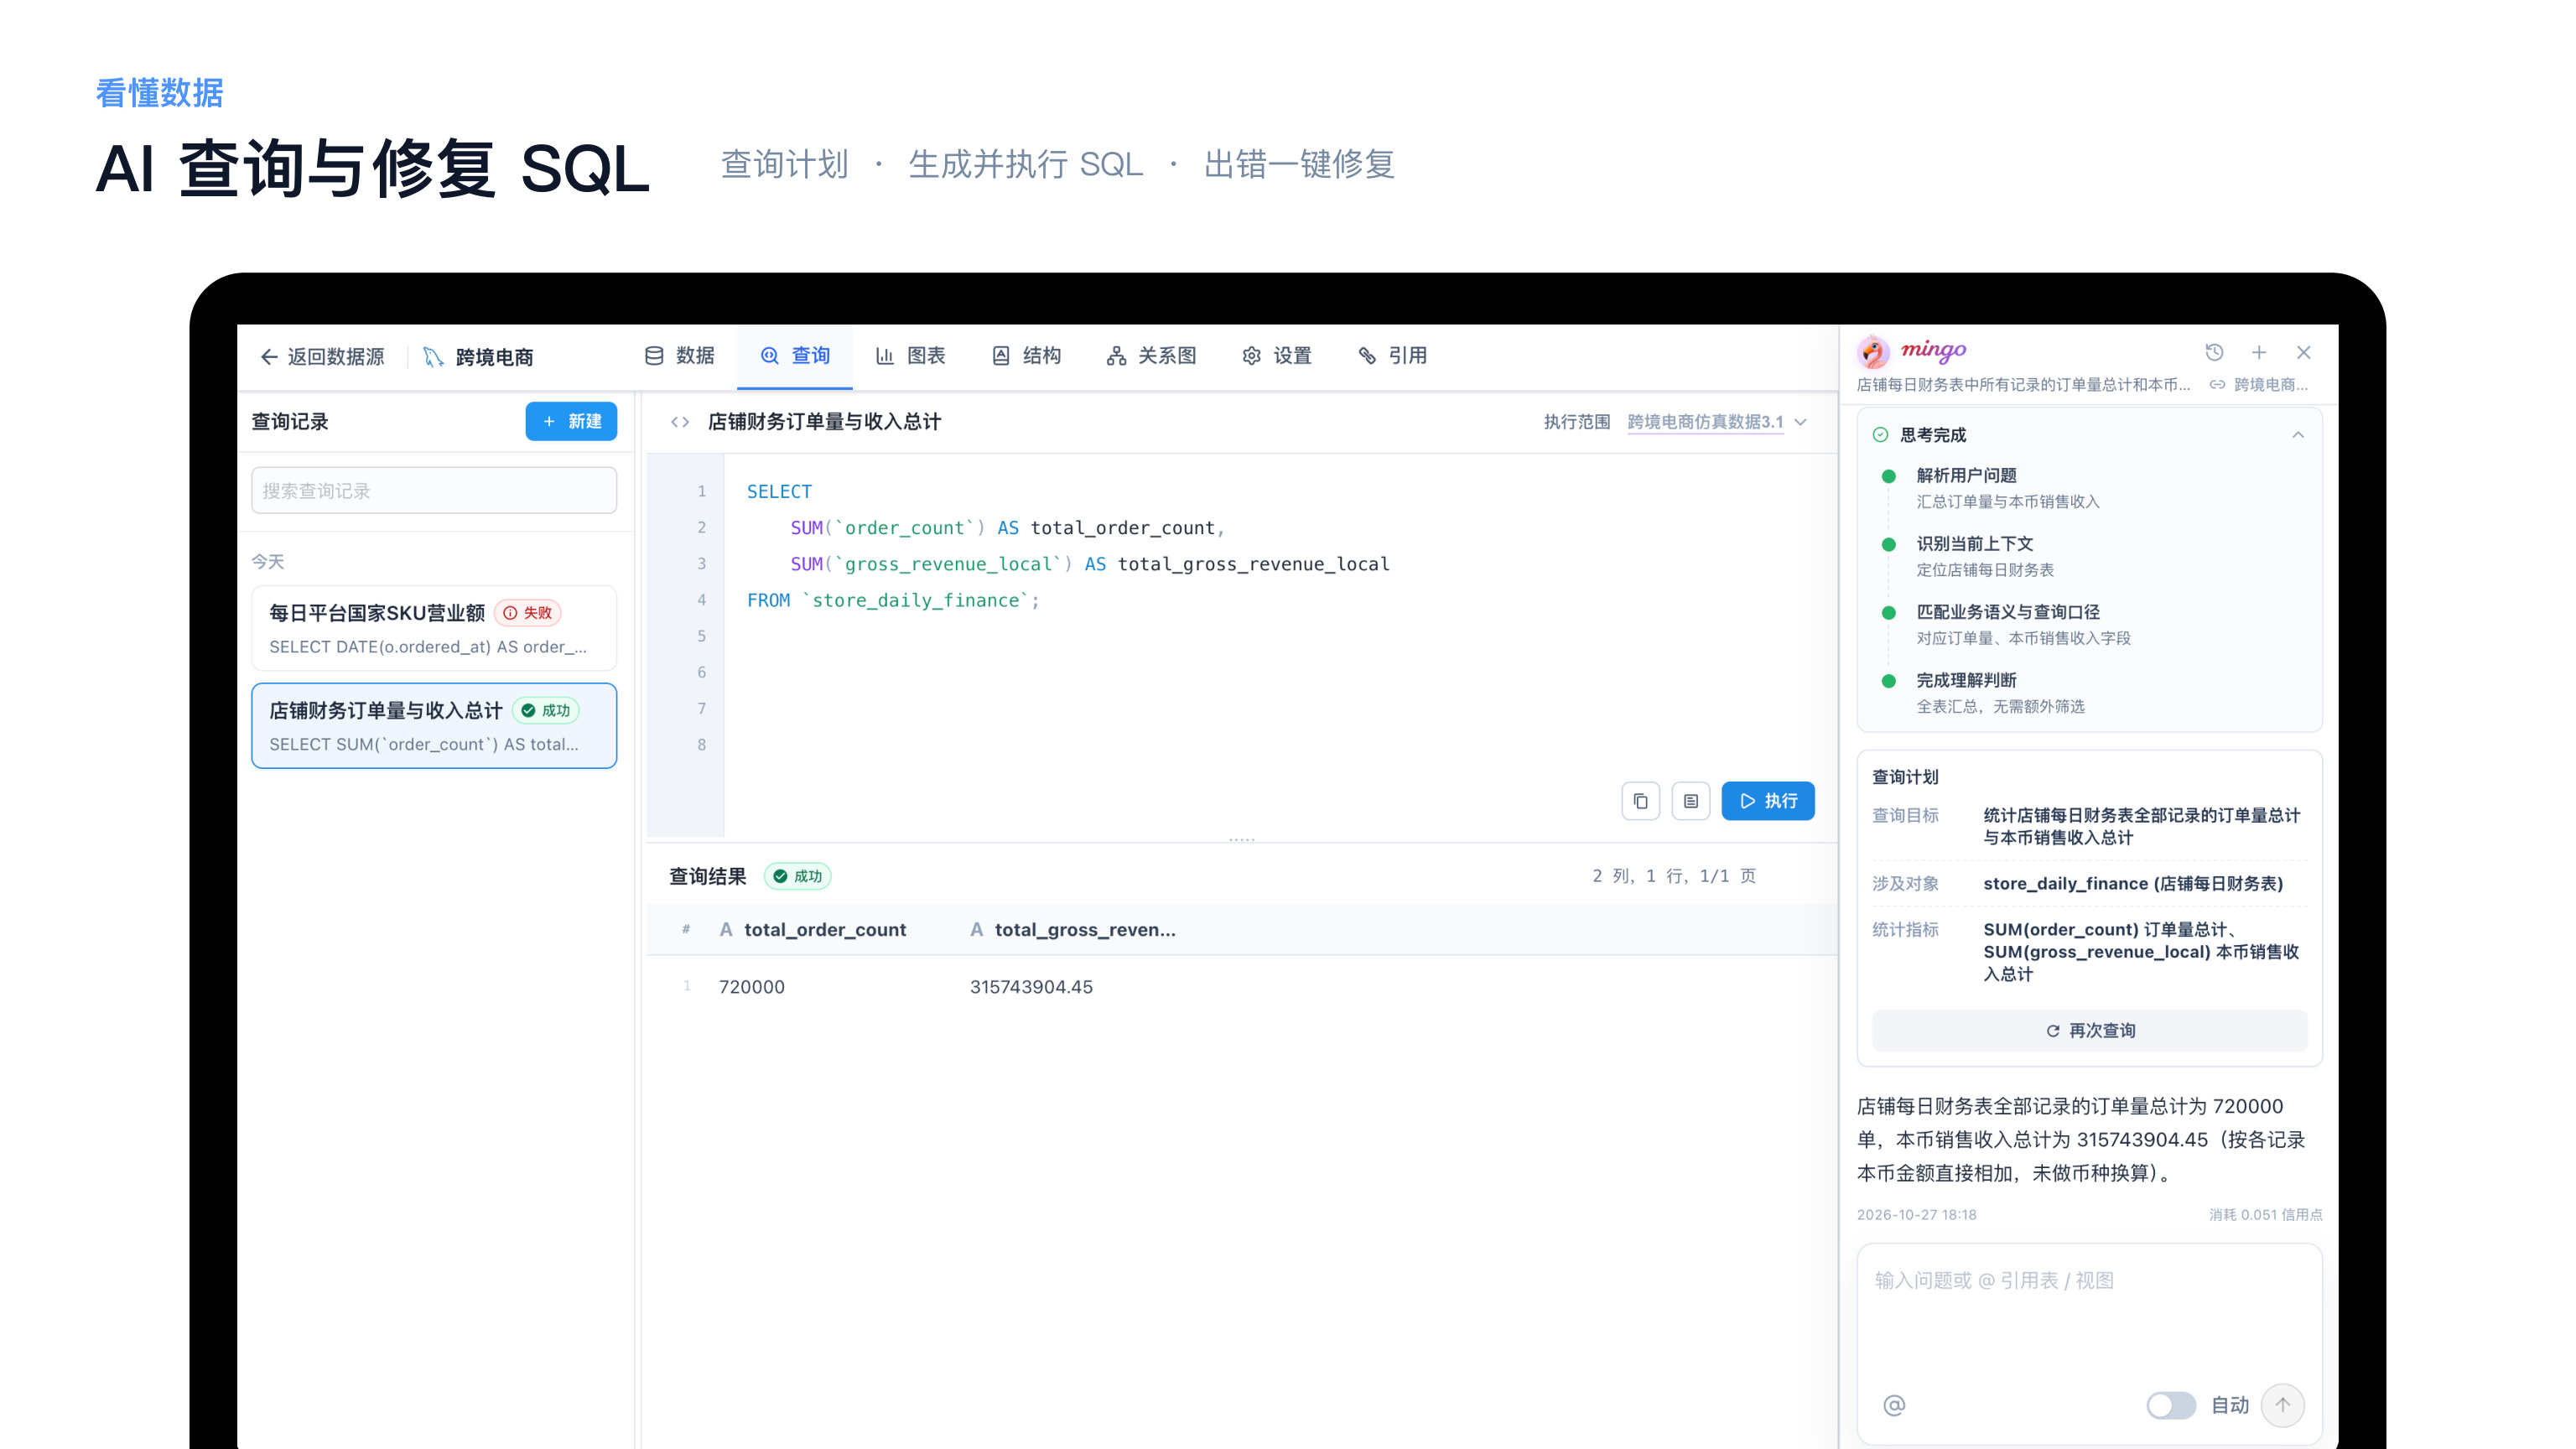
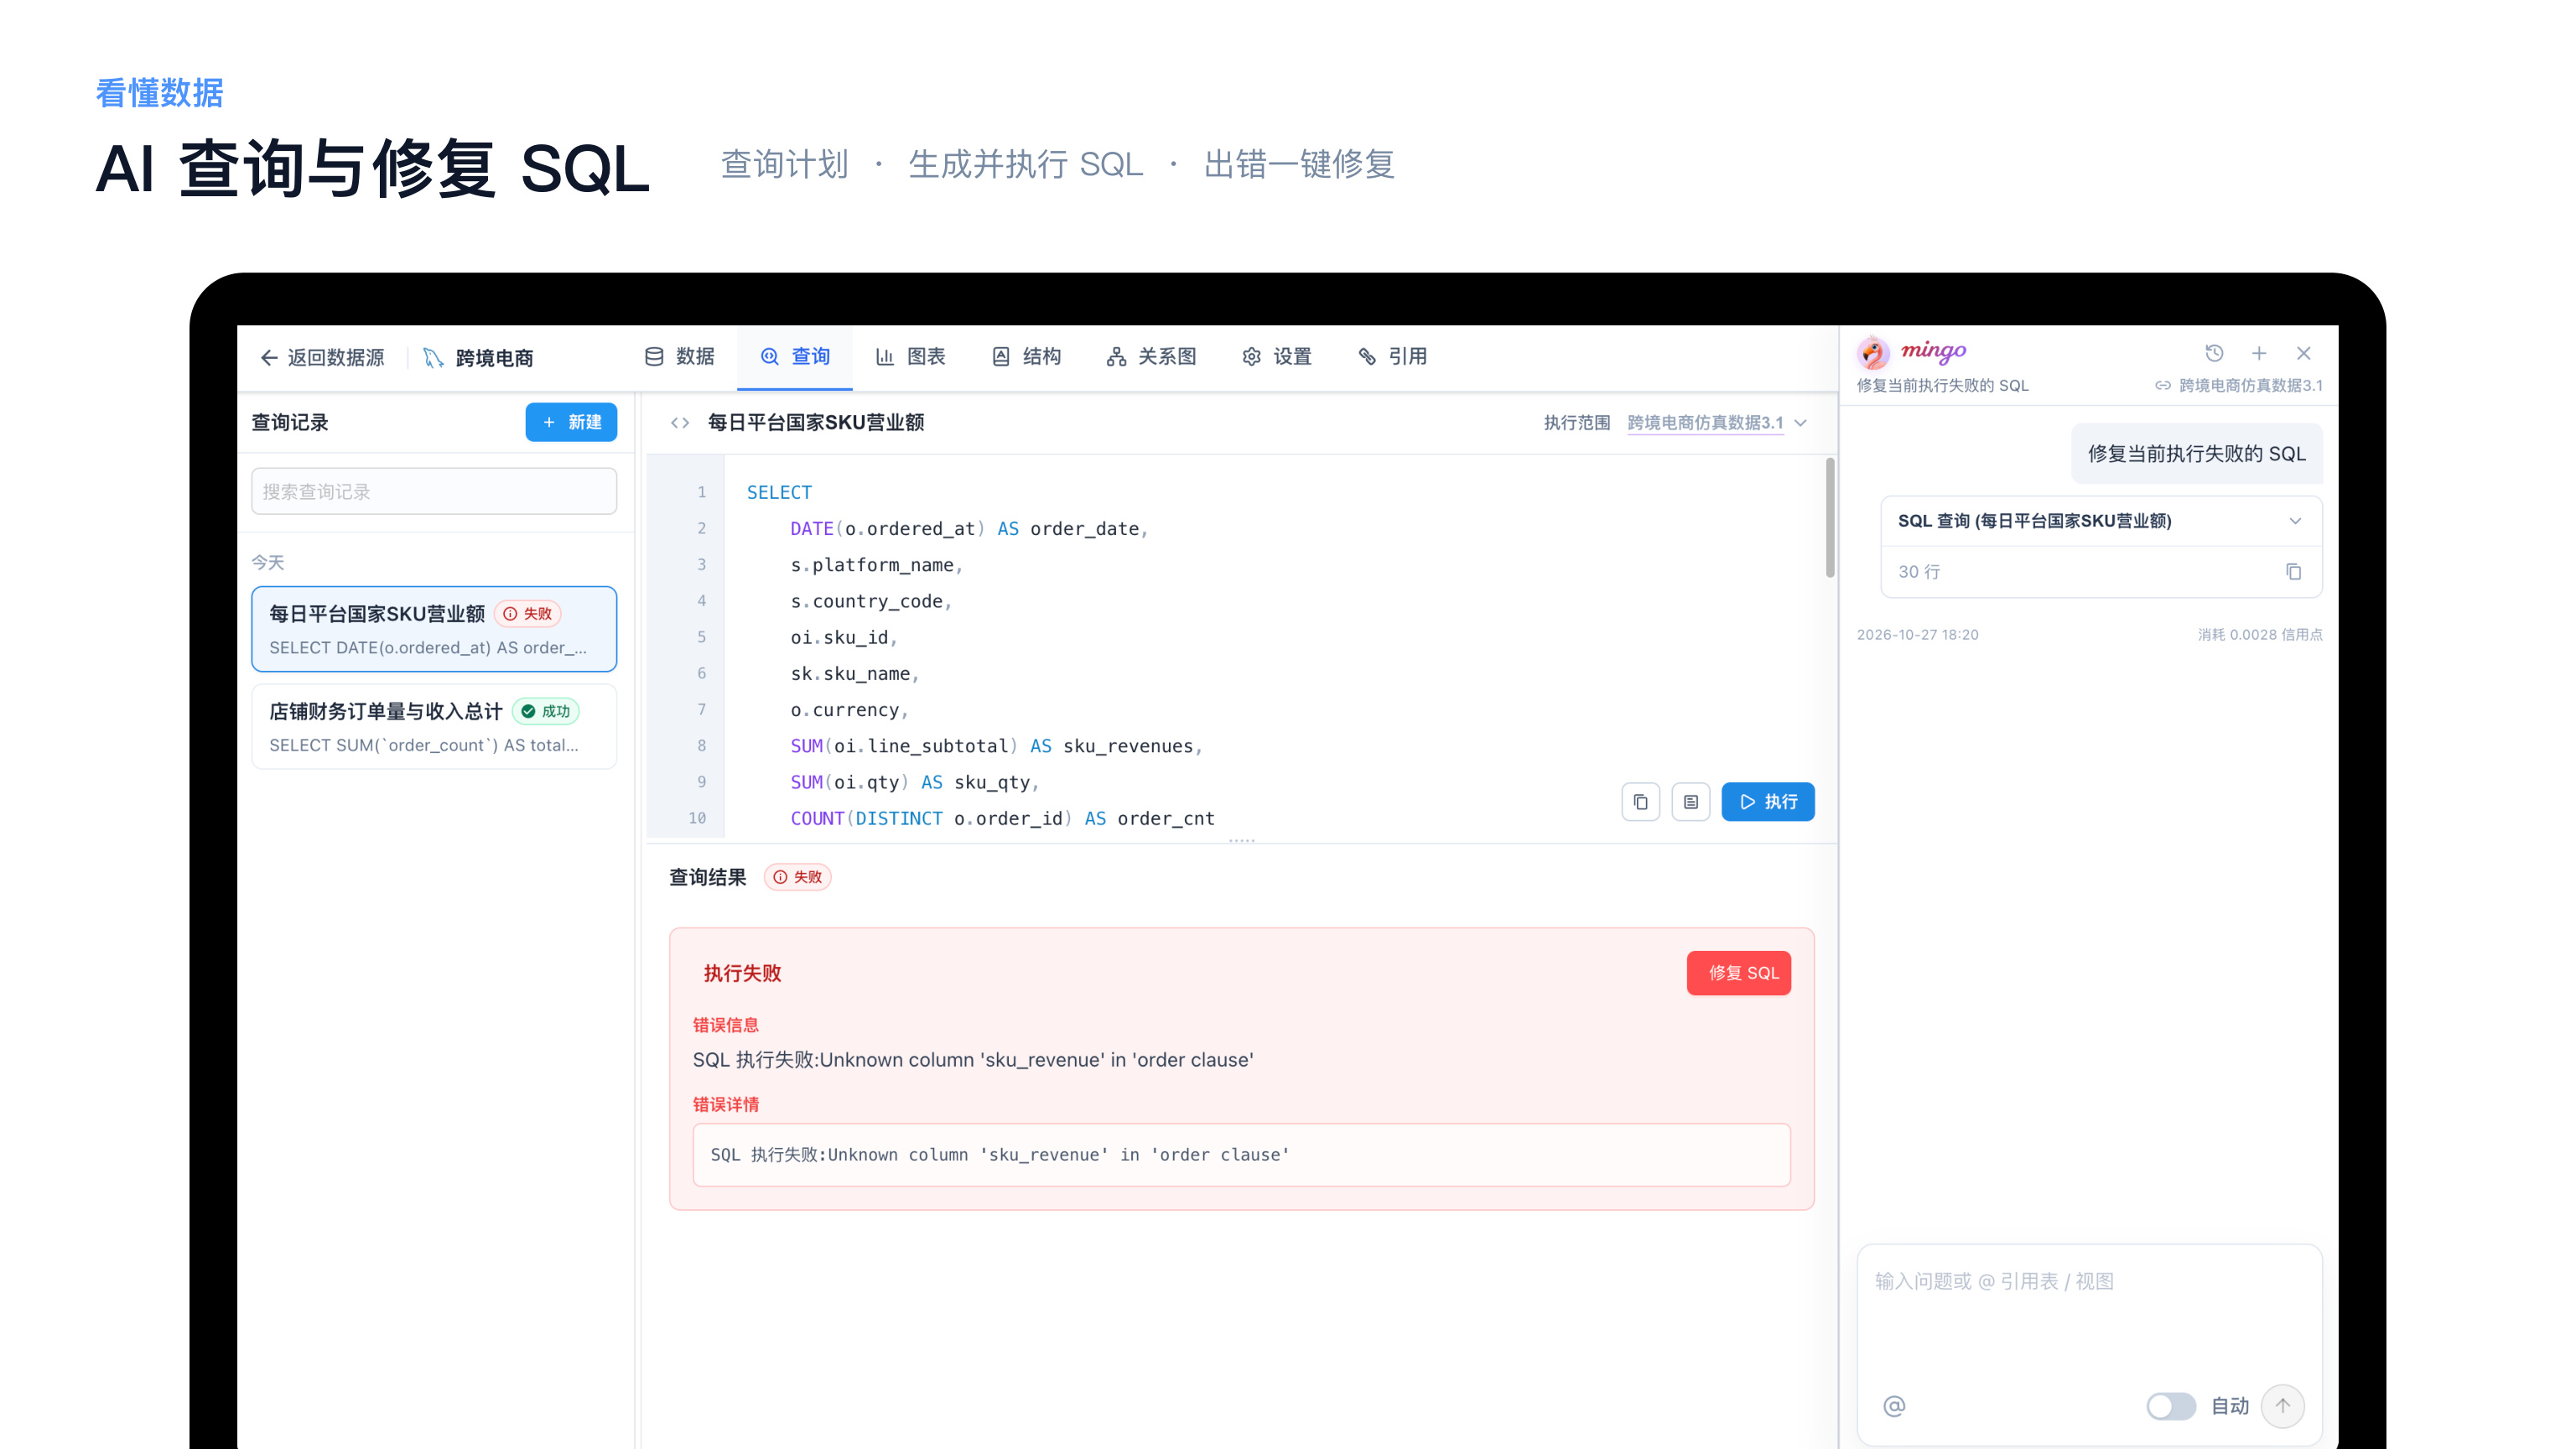
- Data Explorer 五项关联记录追查、ER 关系图、结构语义化、AI 查询(SQL 出错自动修复)、AI 图表。
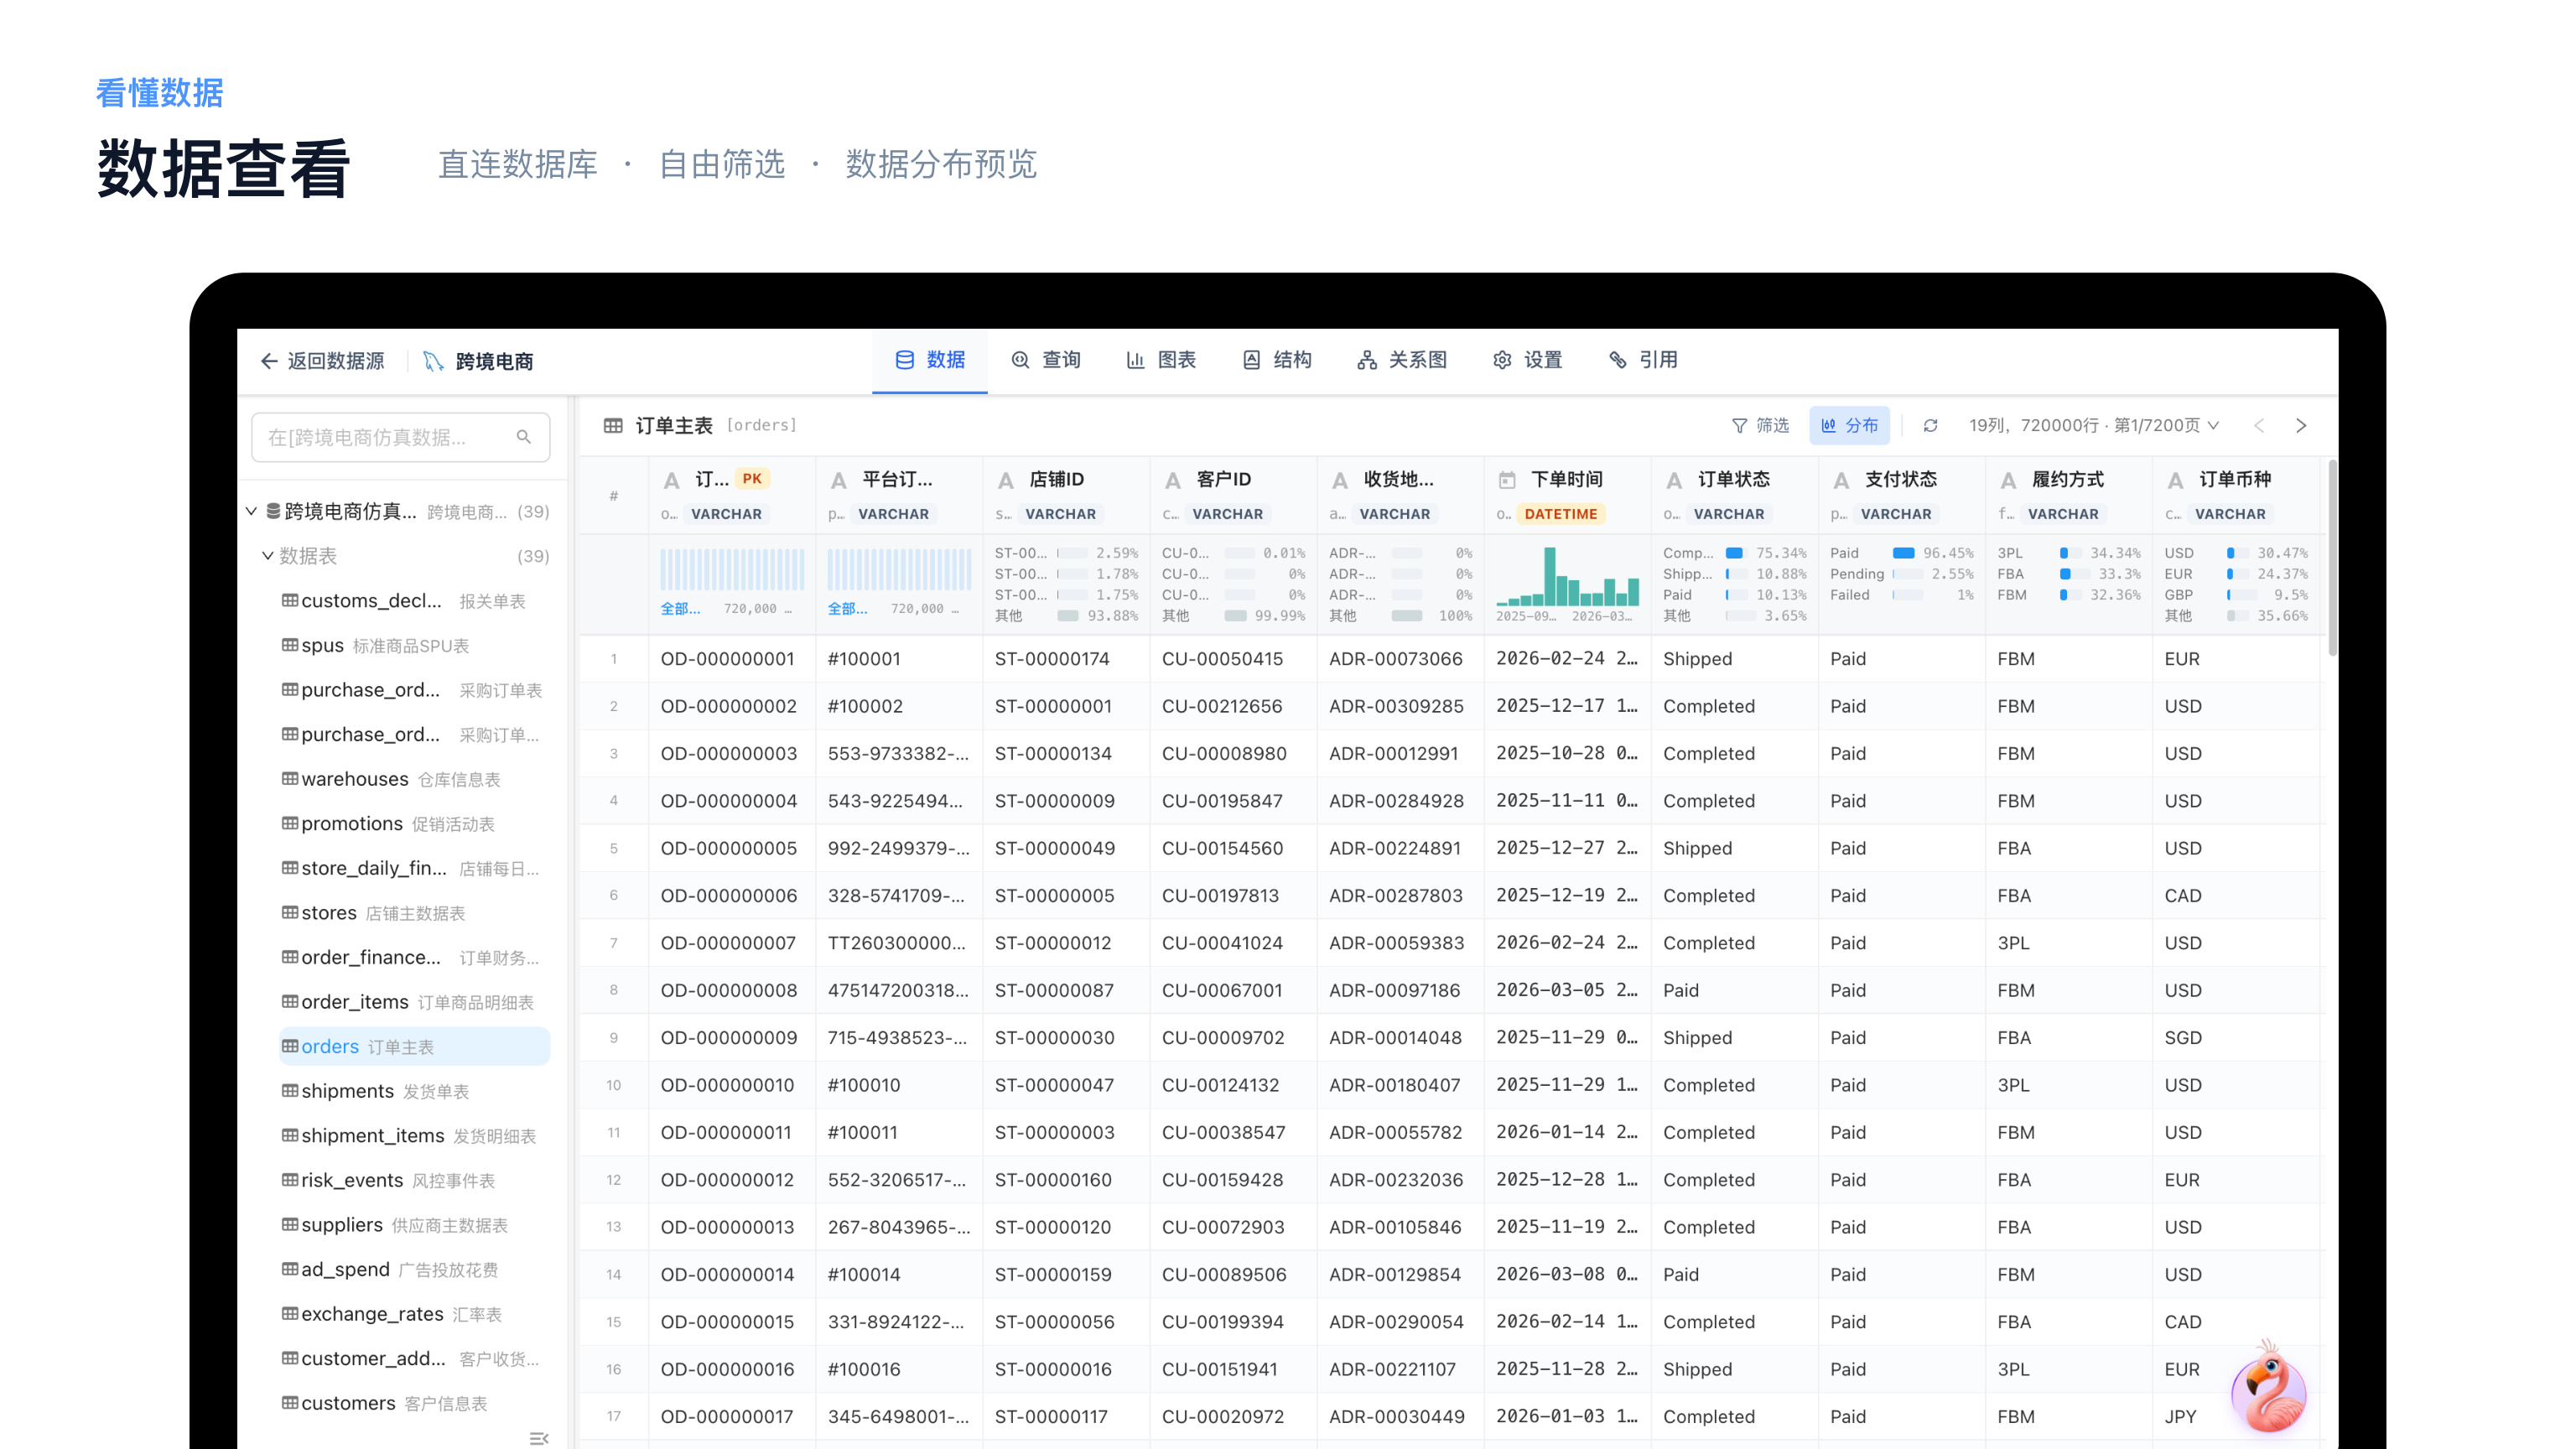
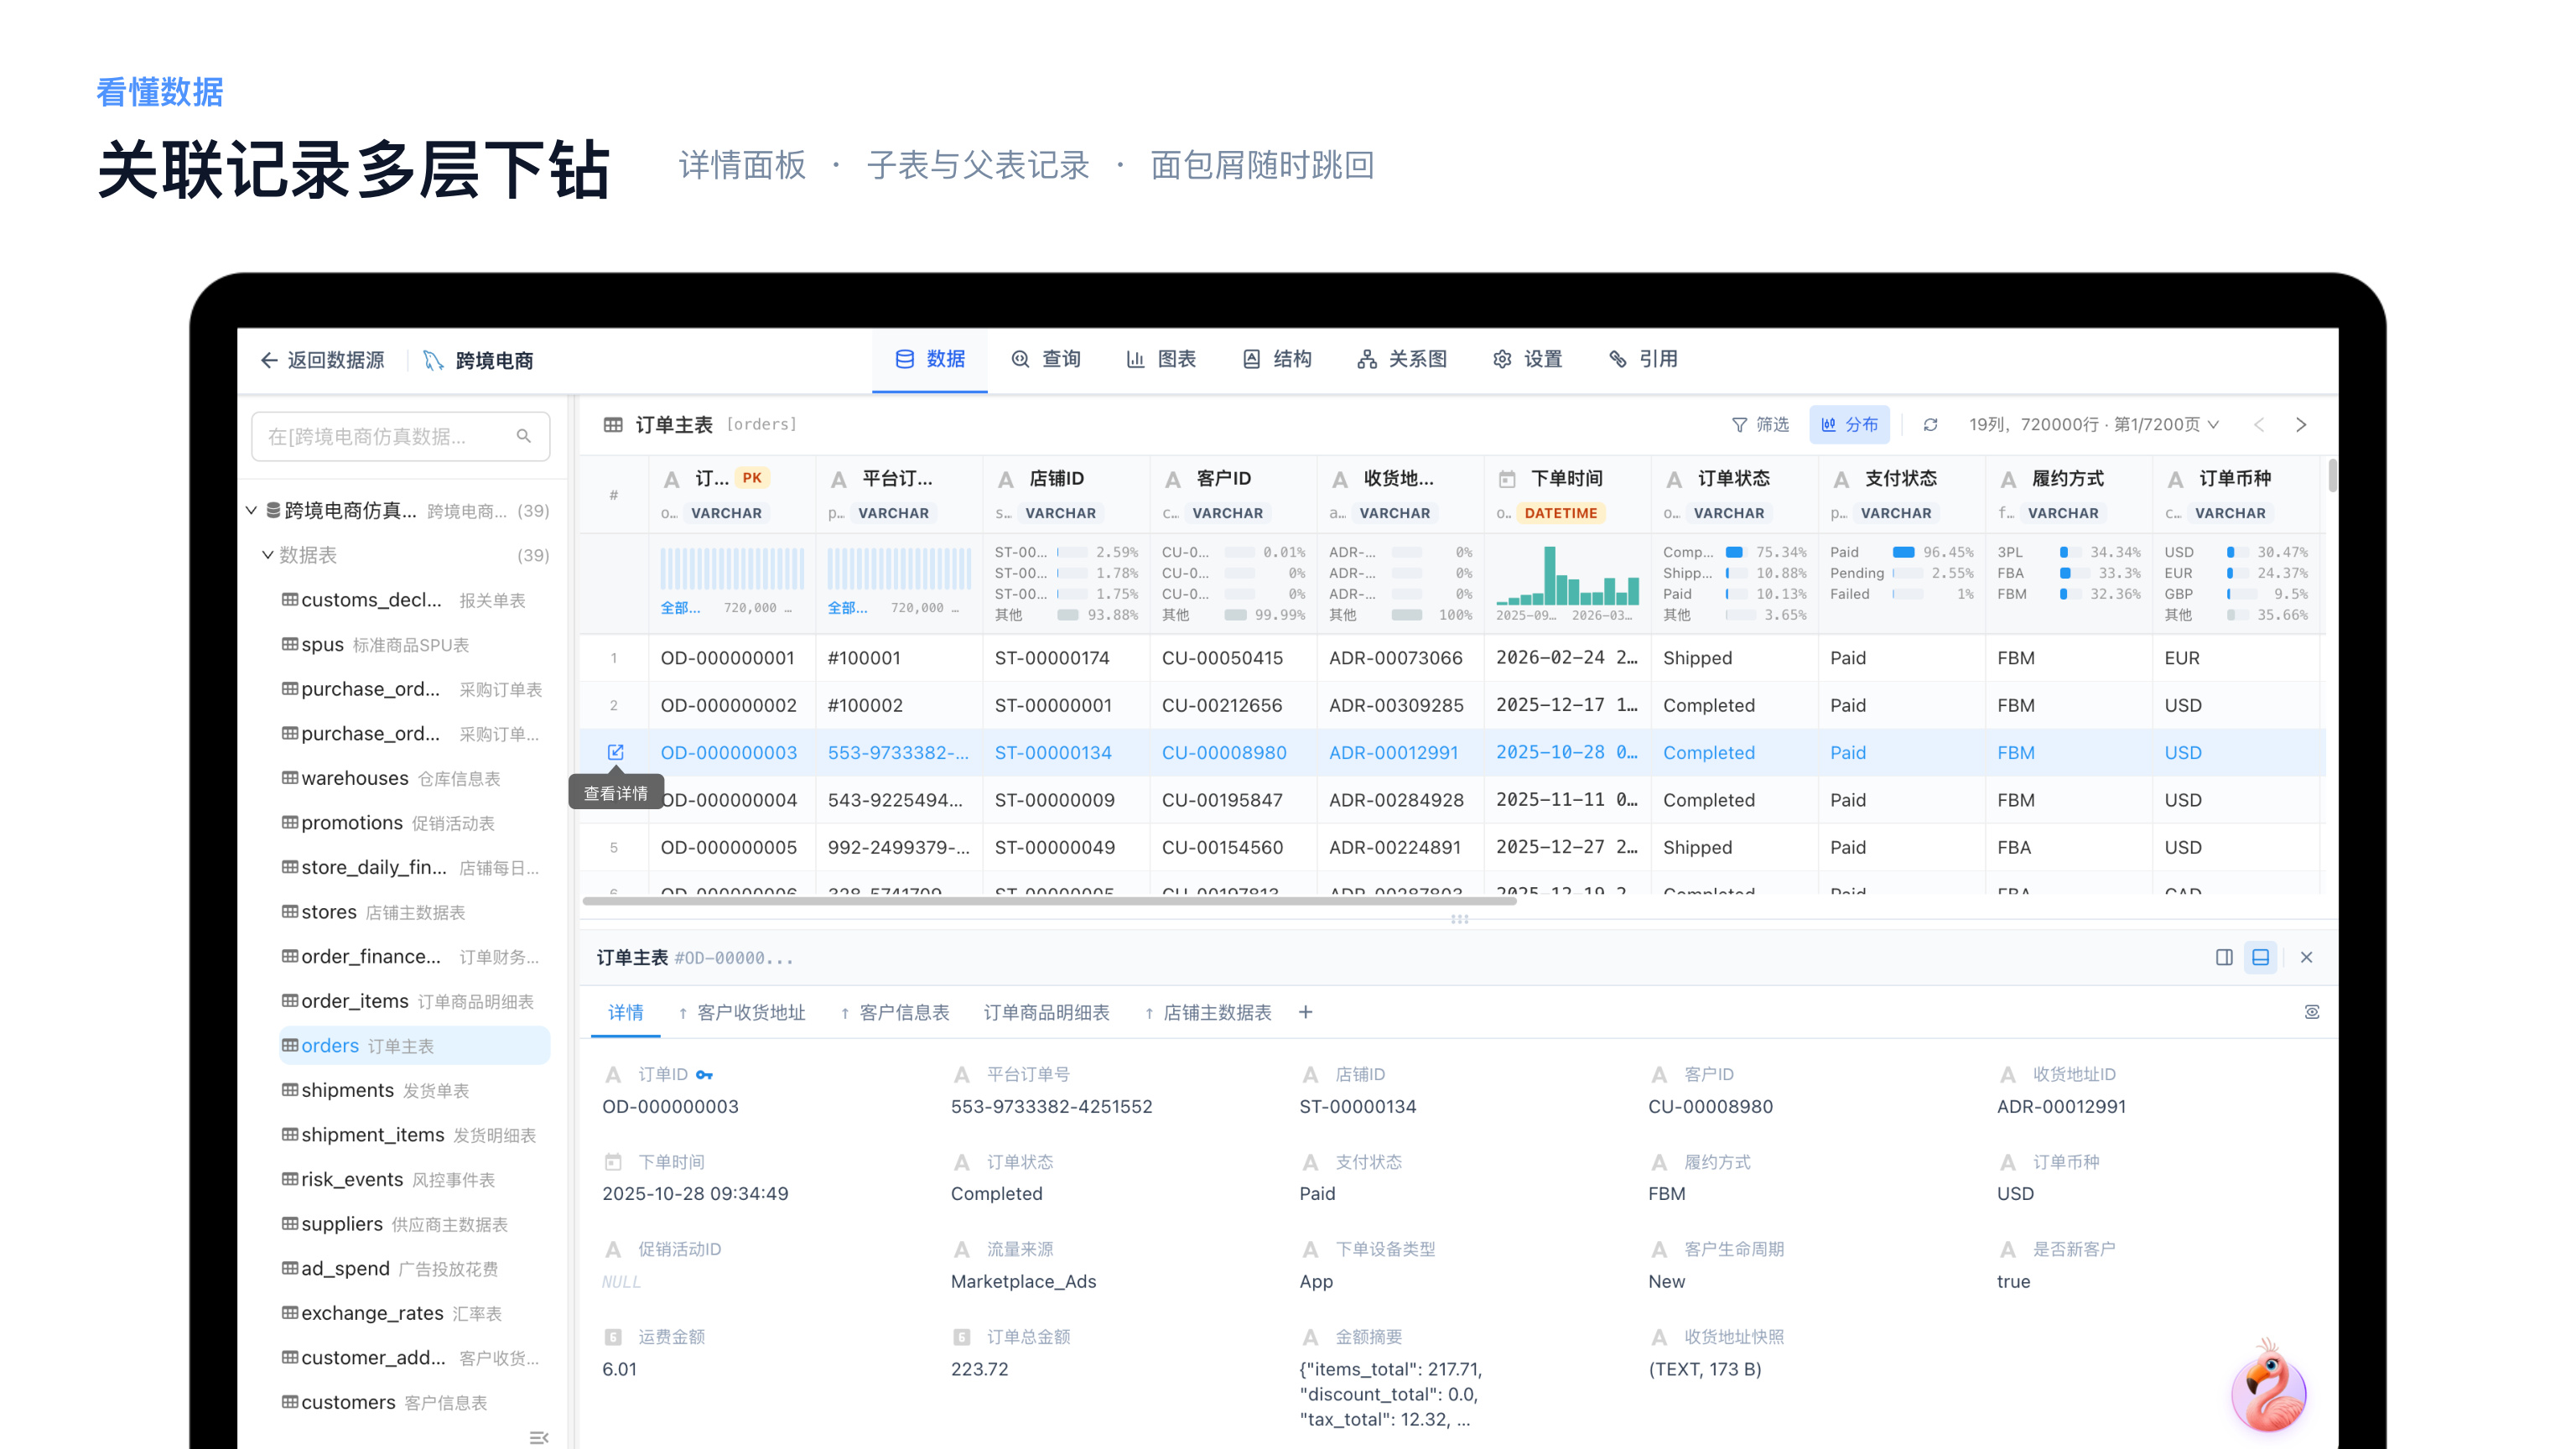
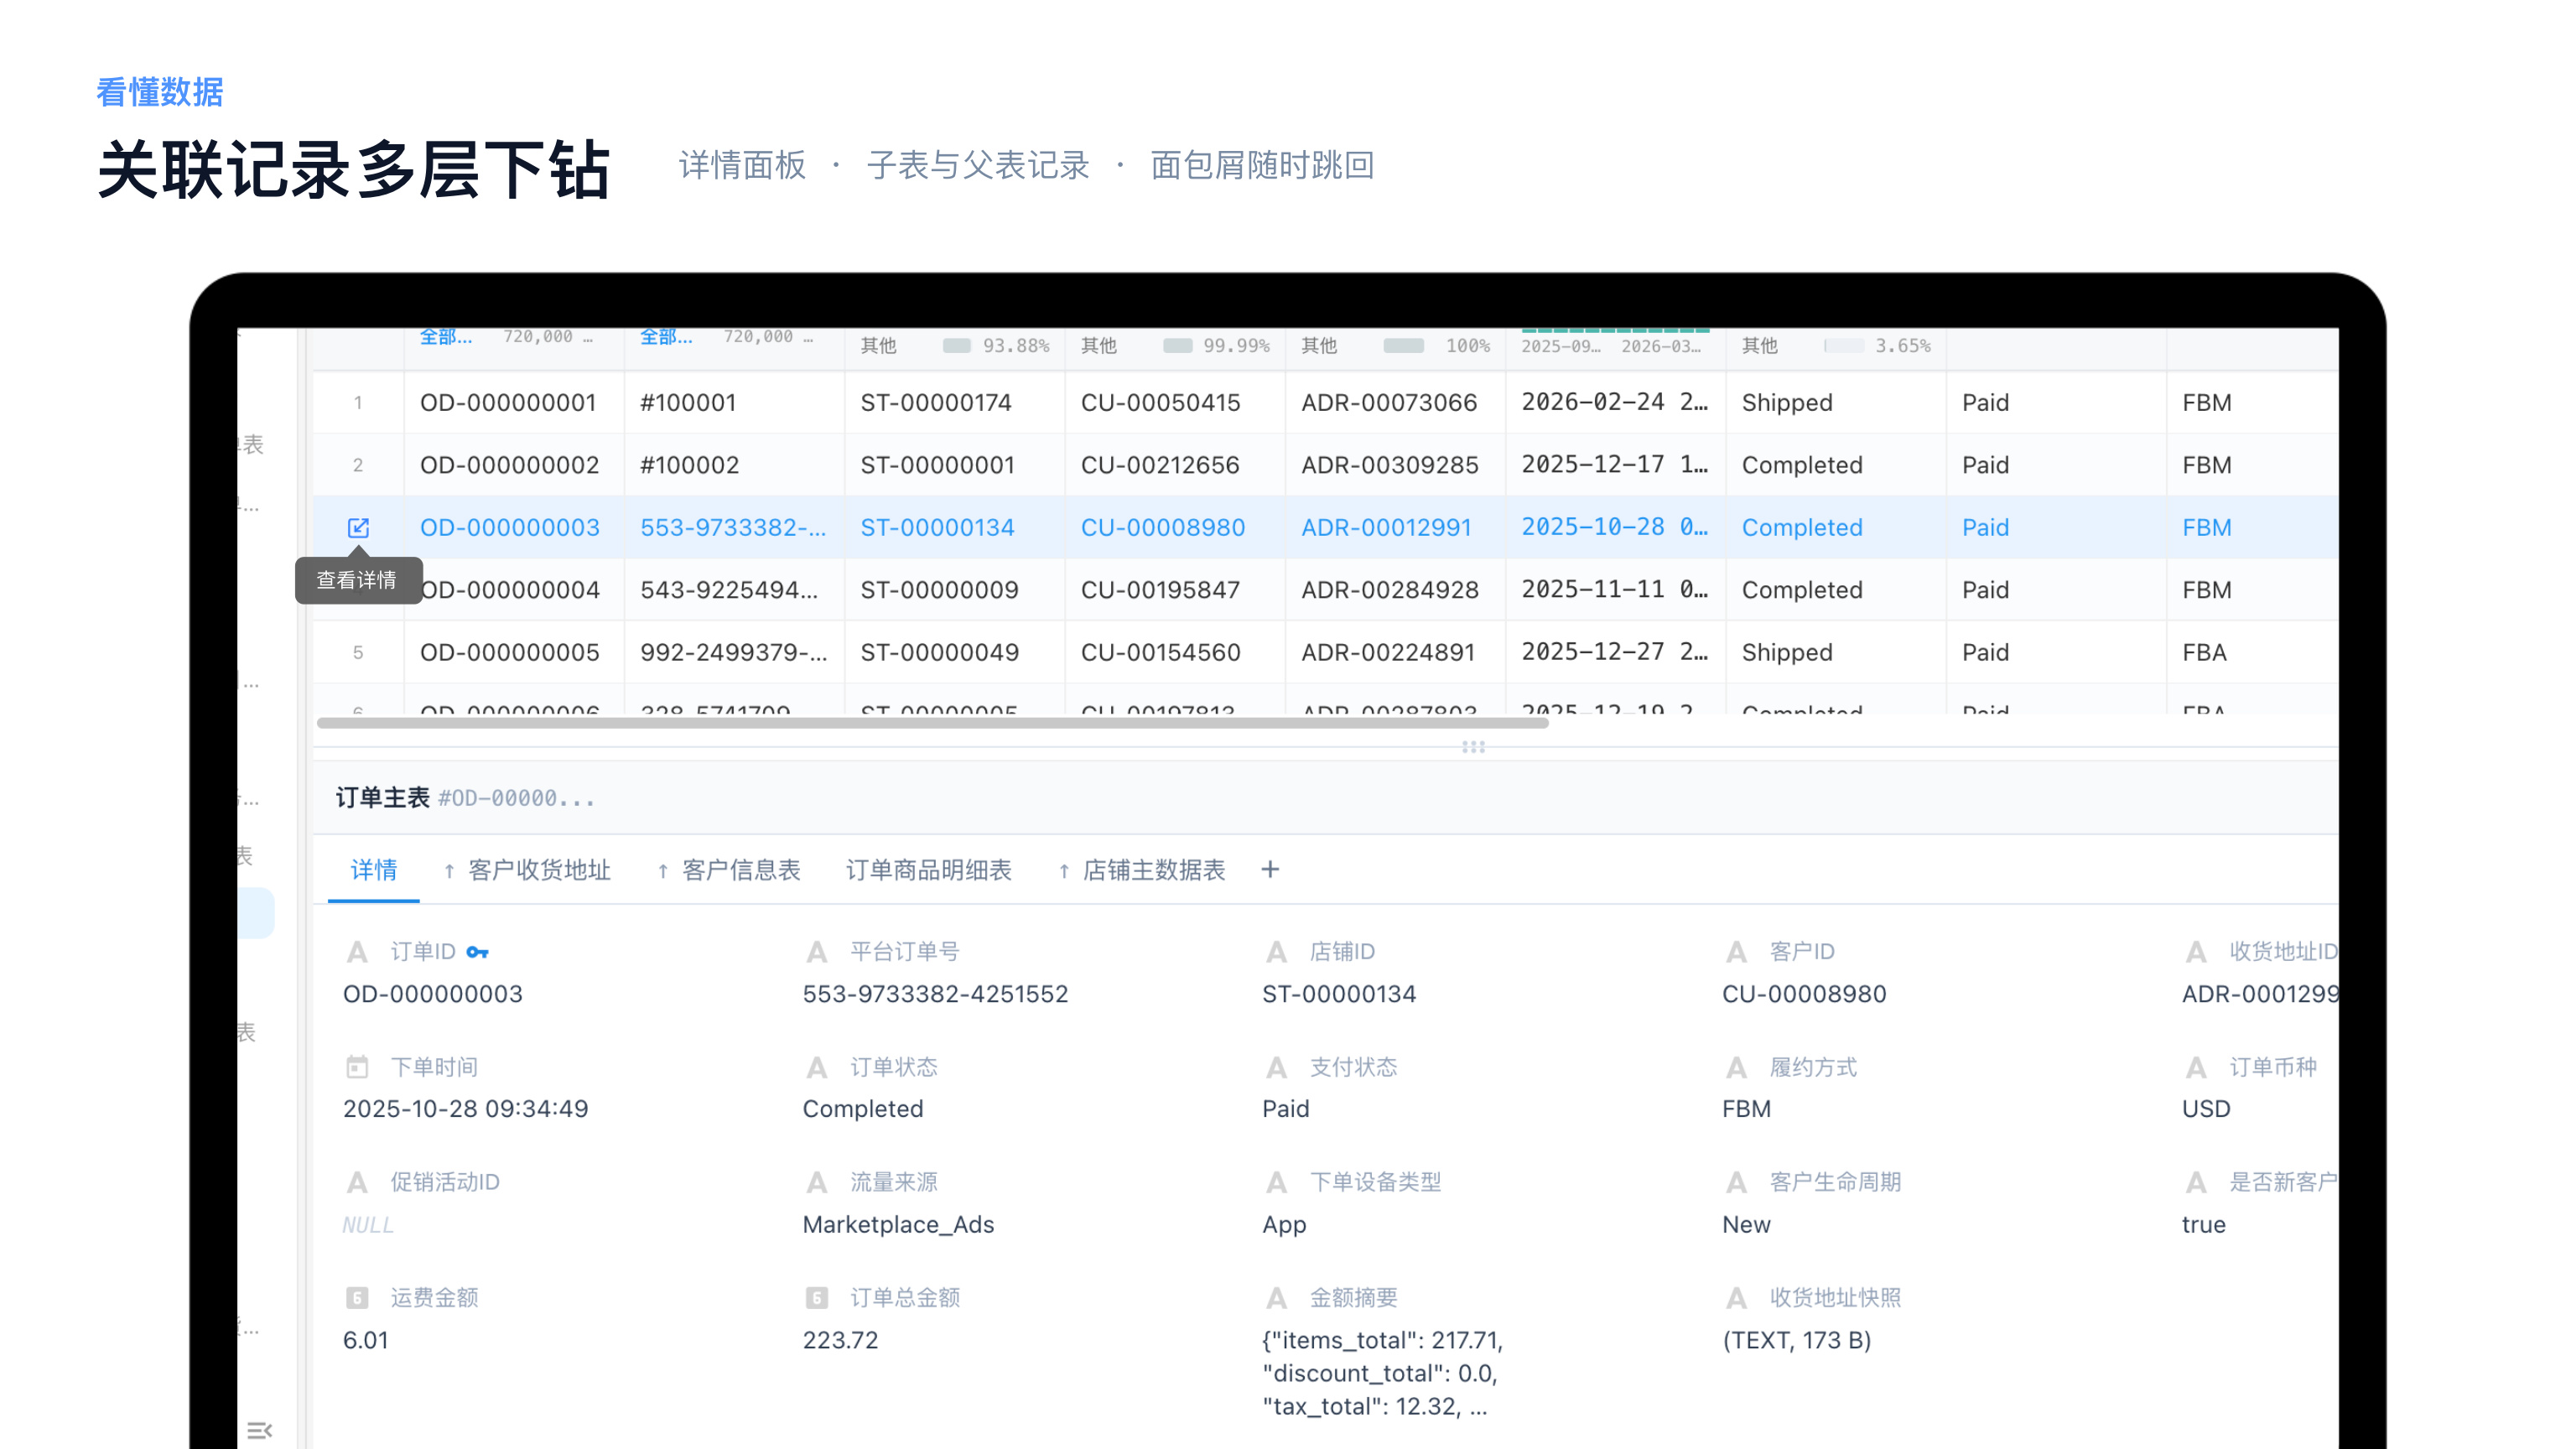
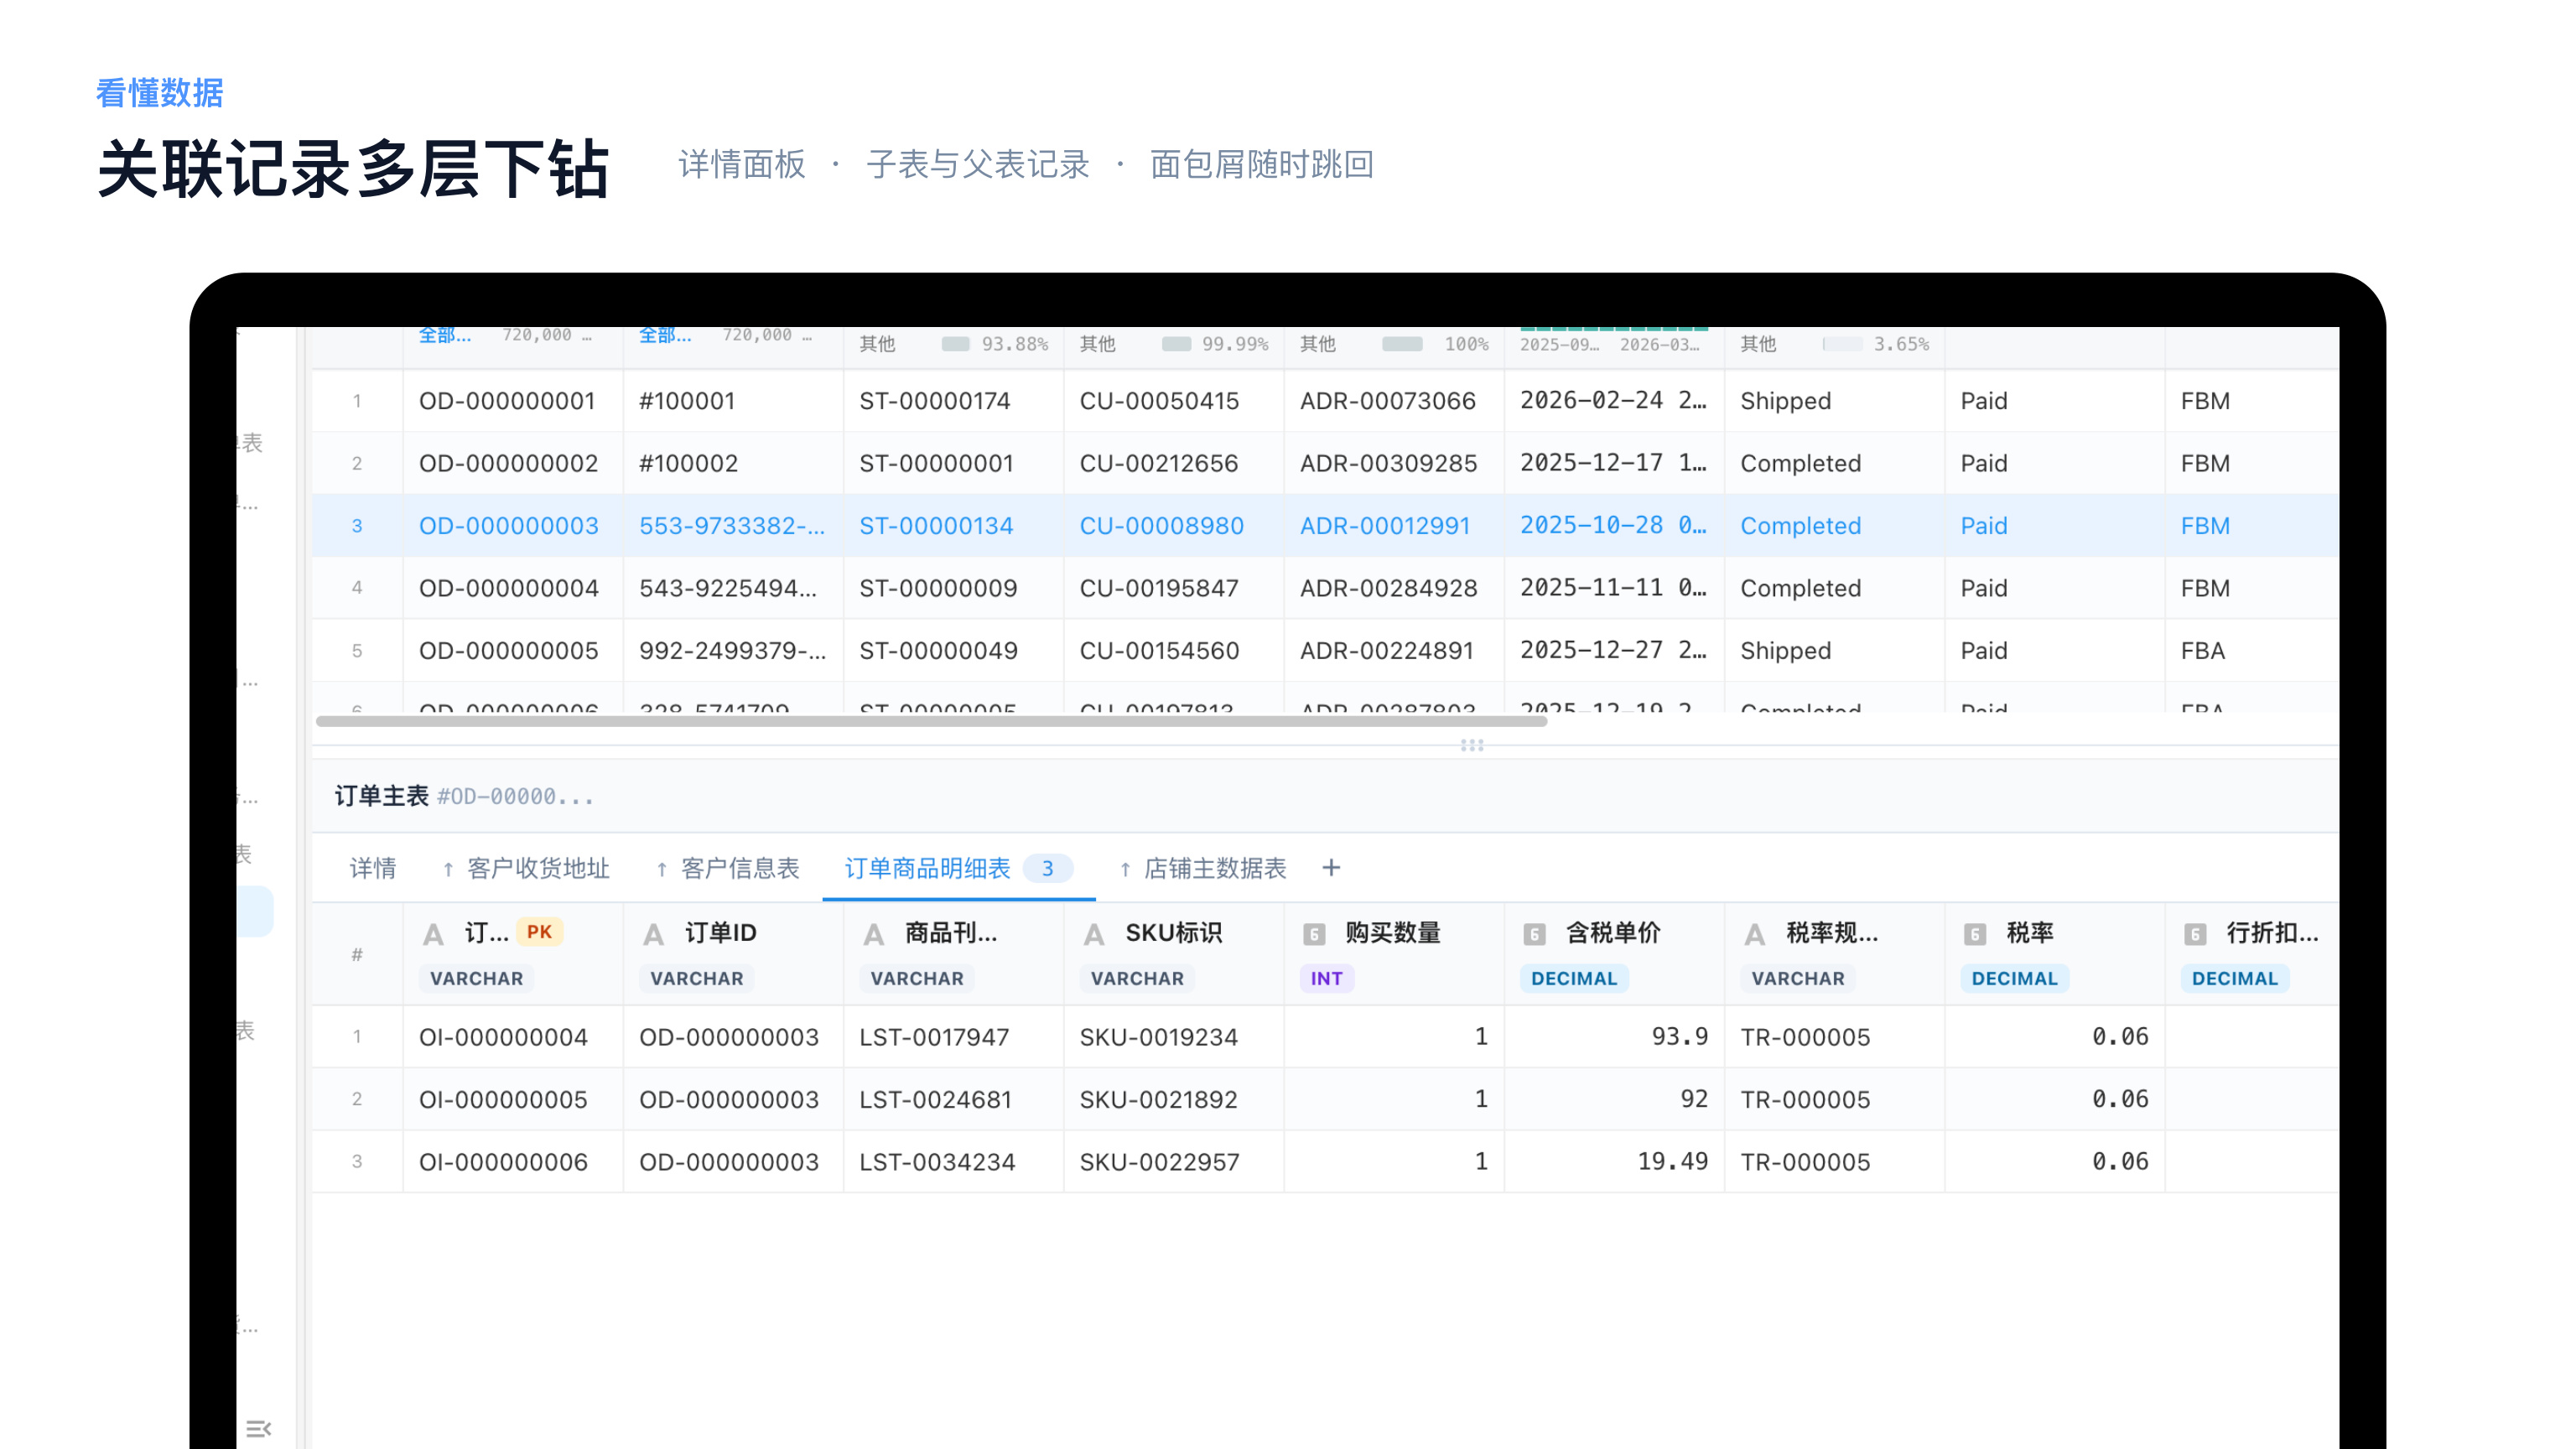
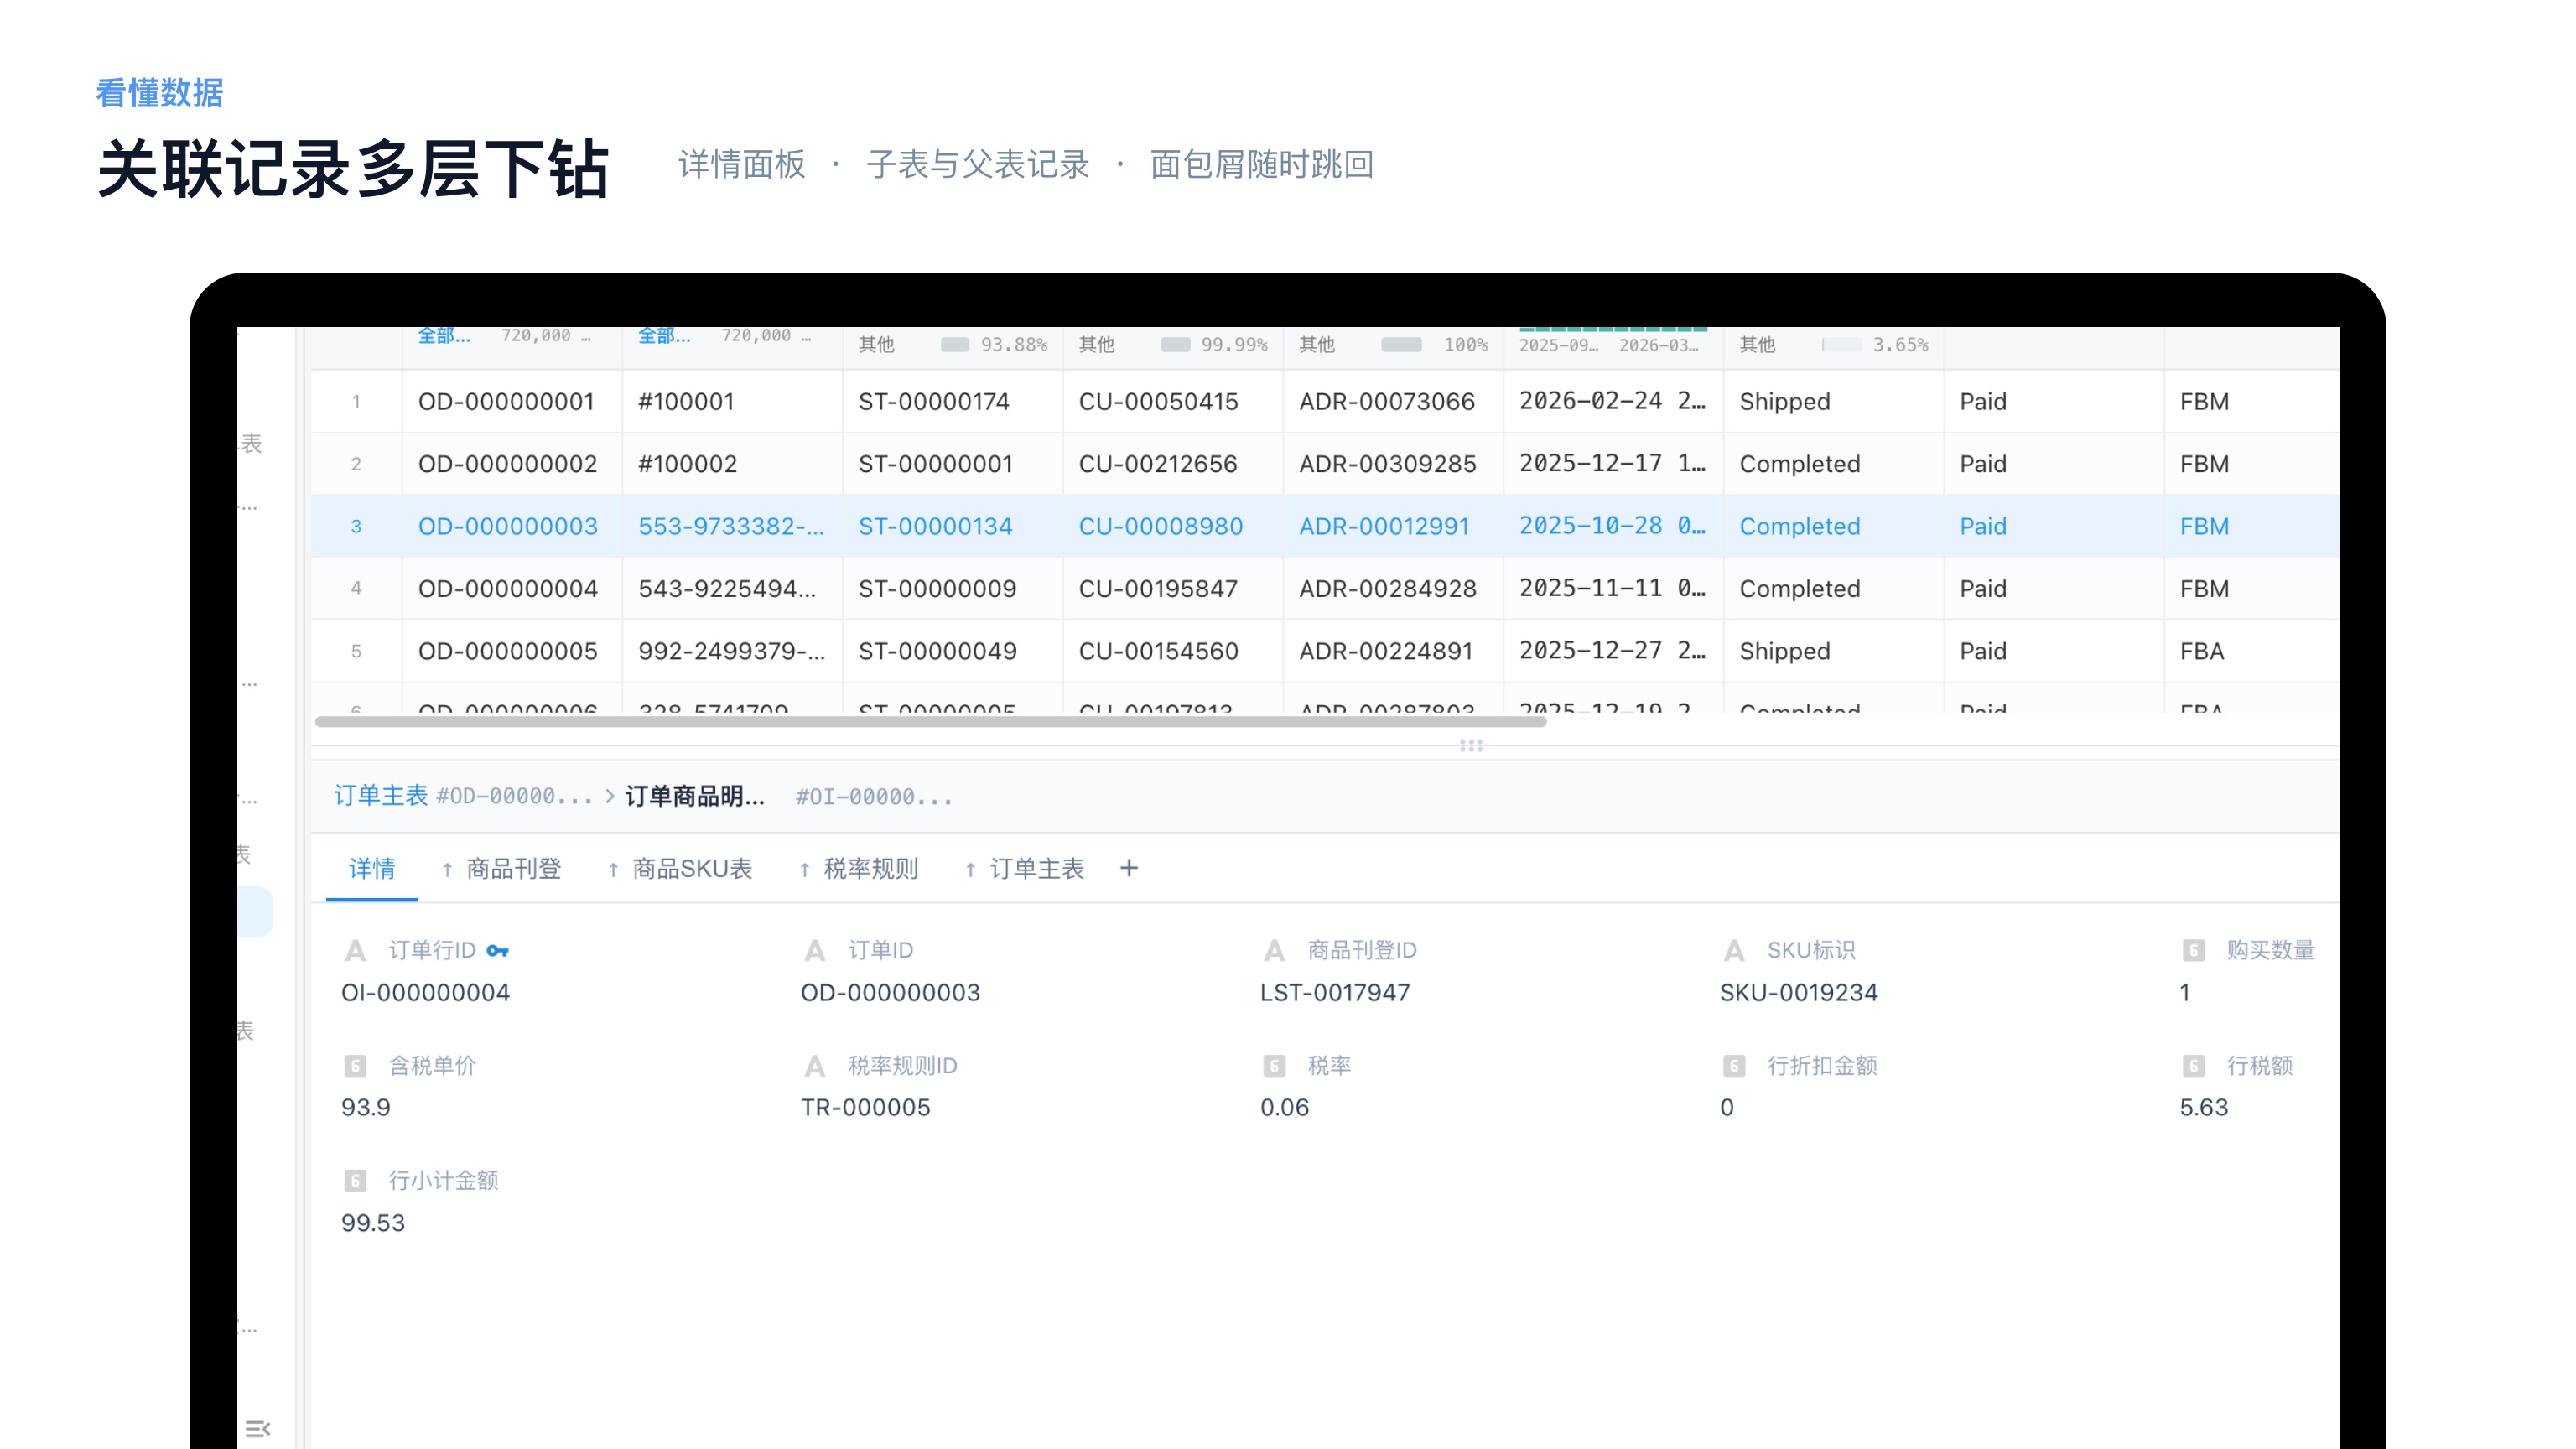
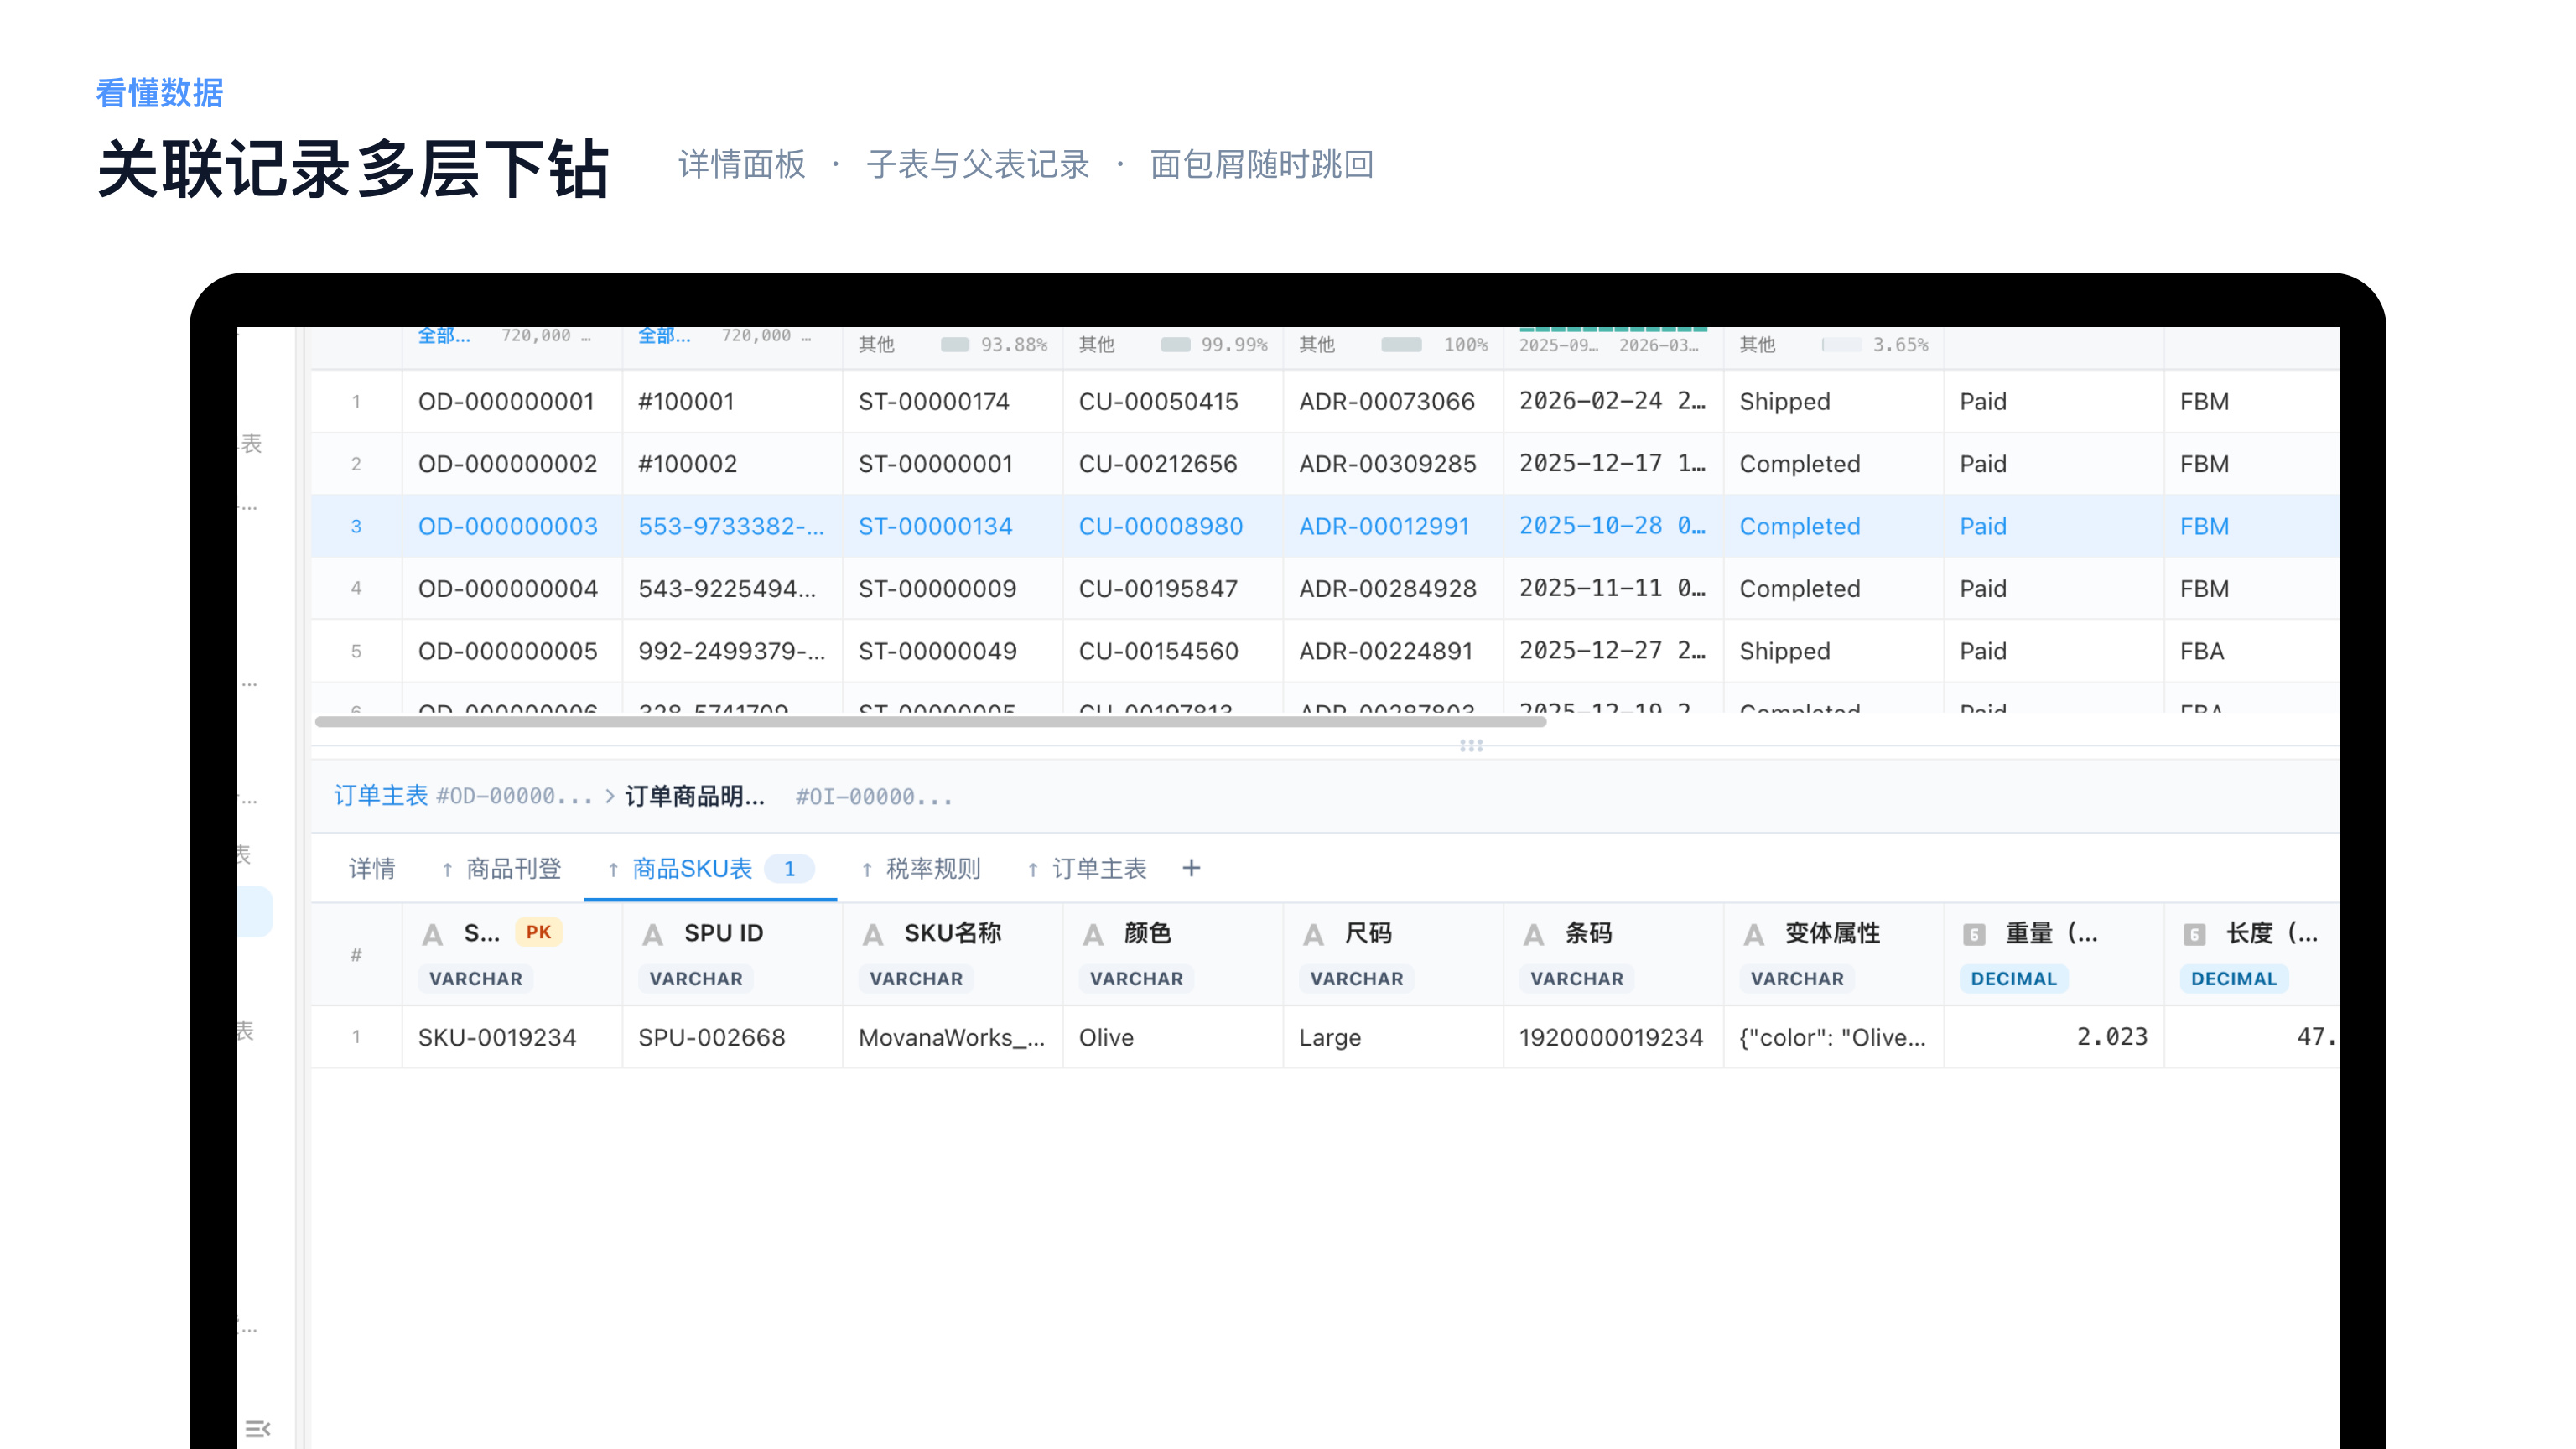
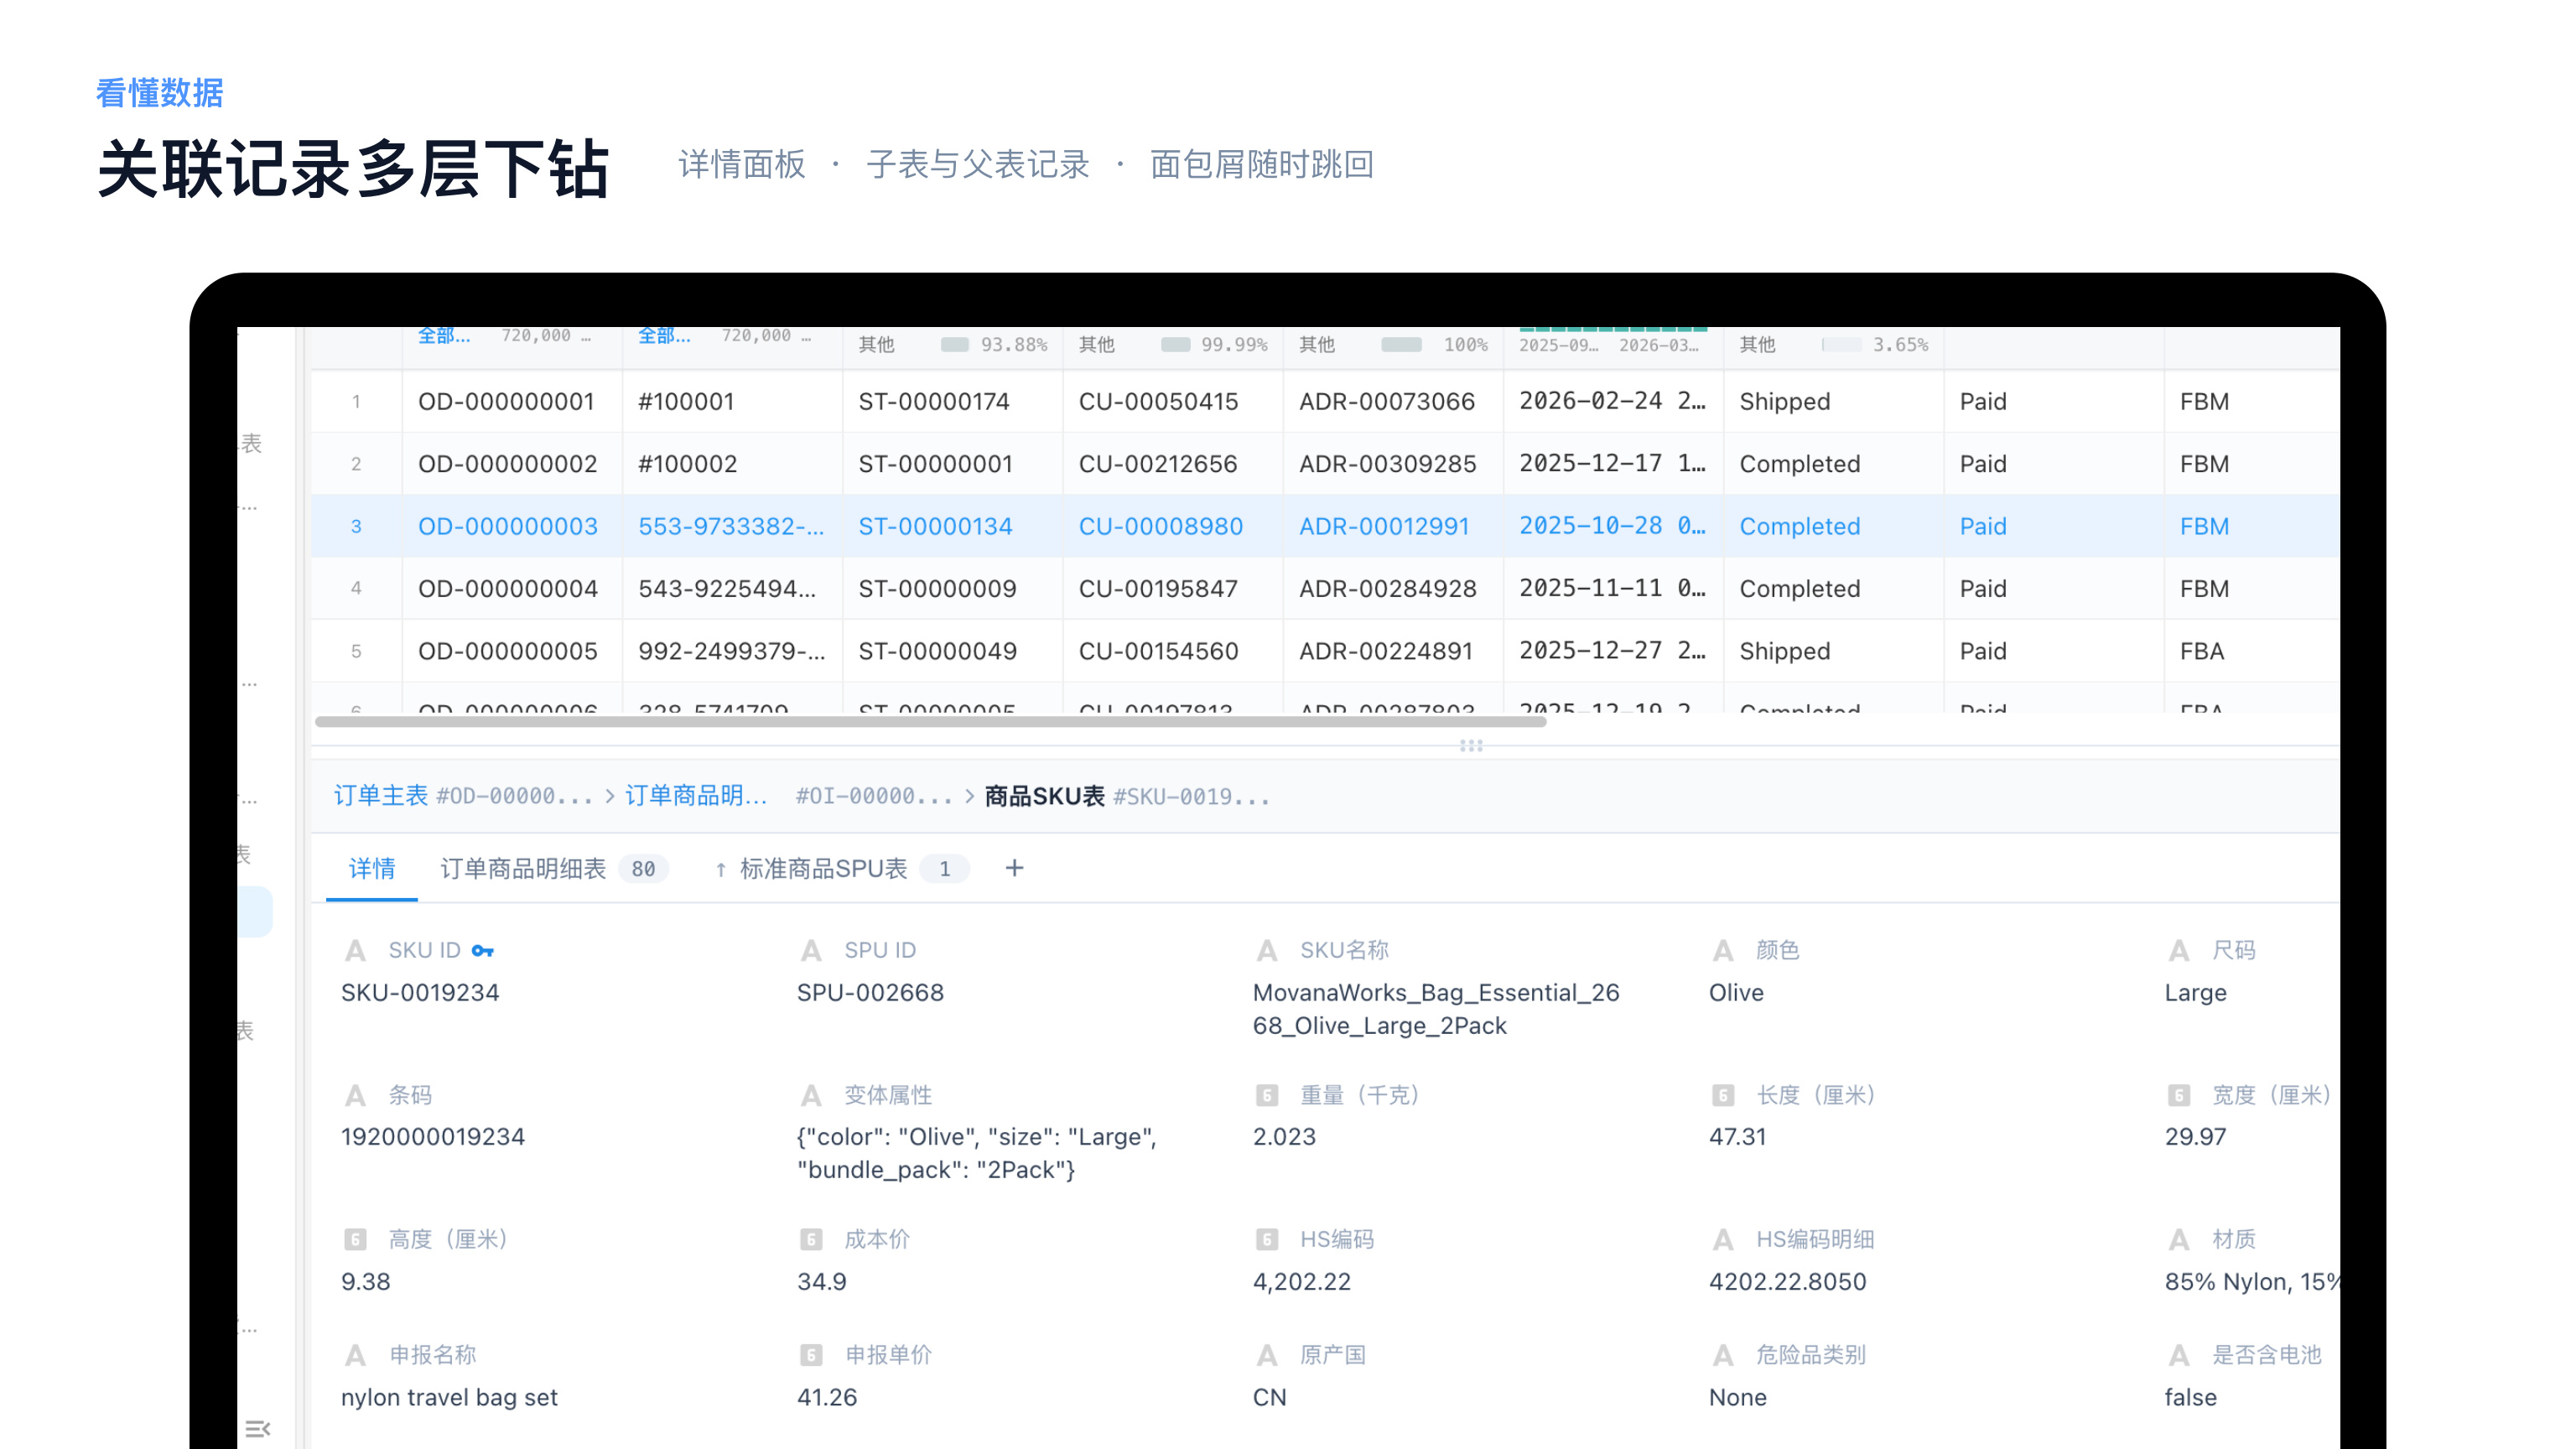
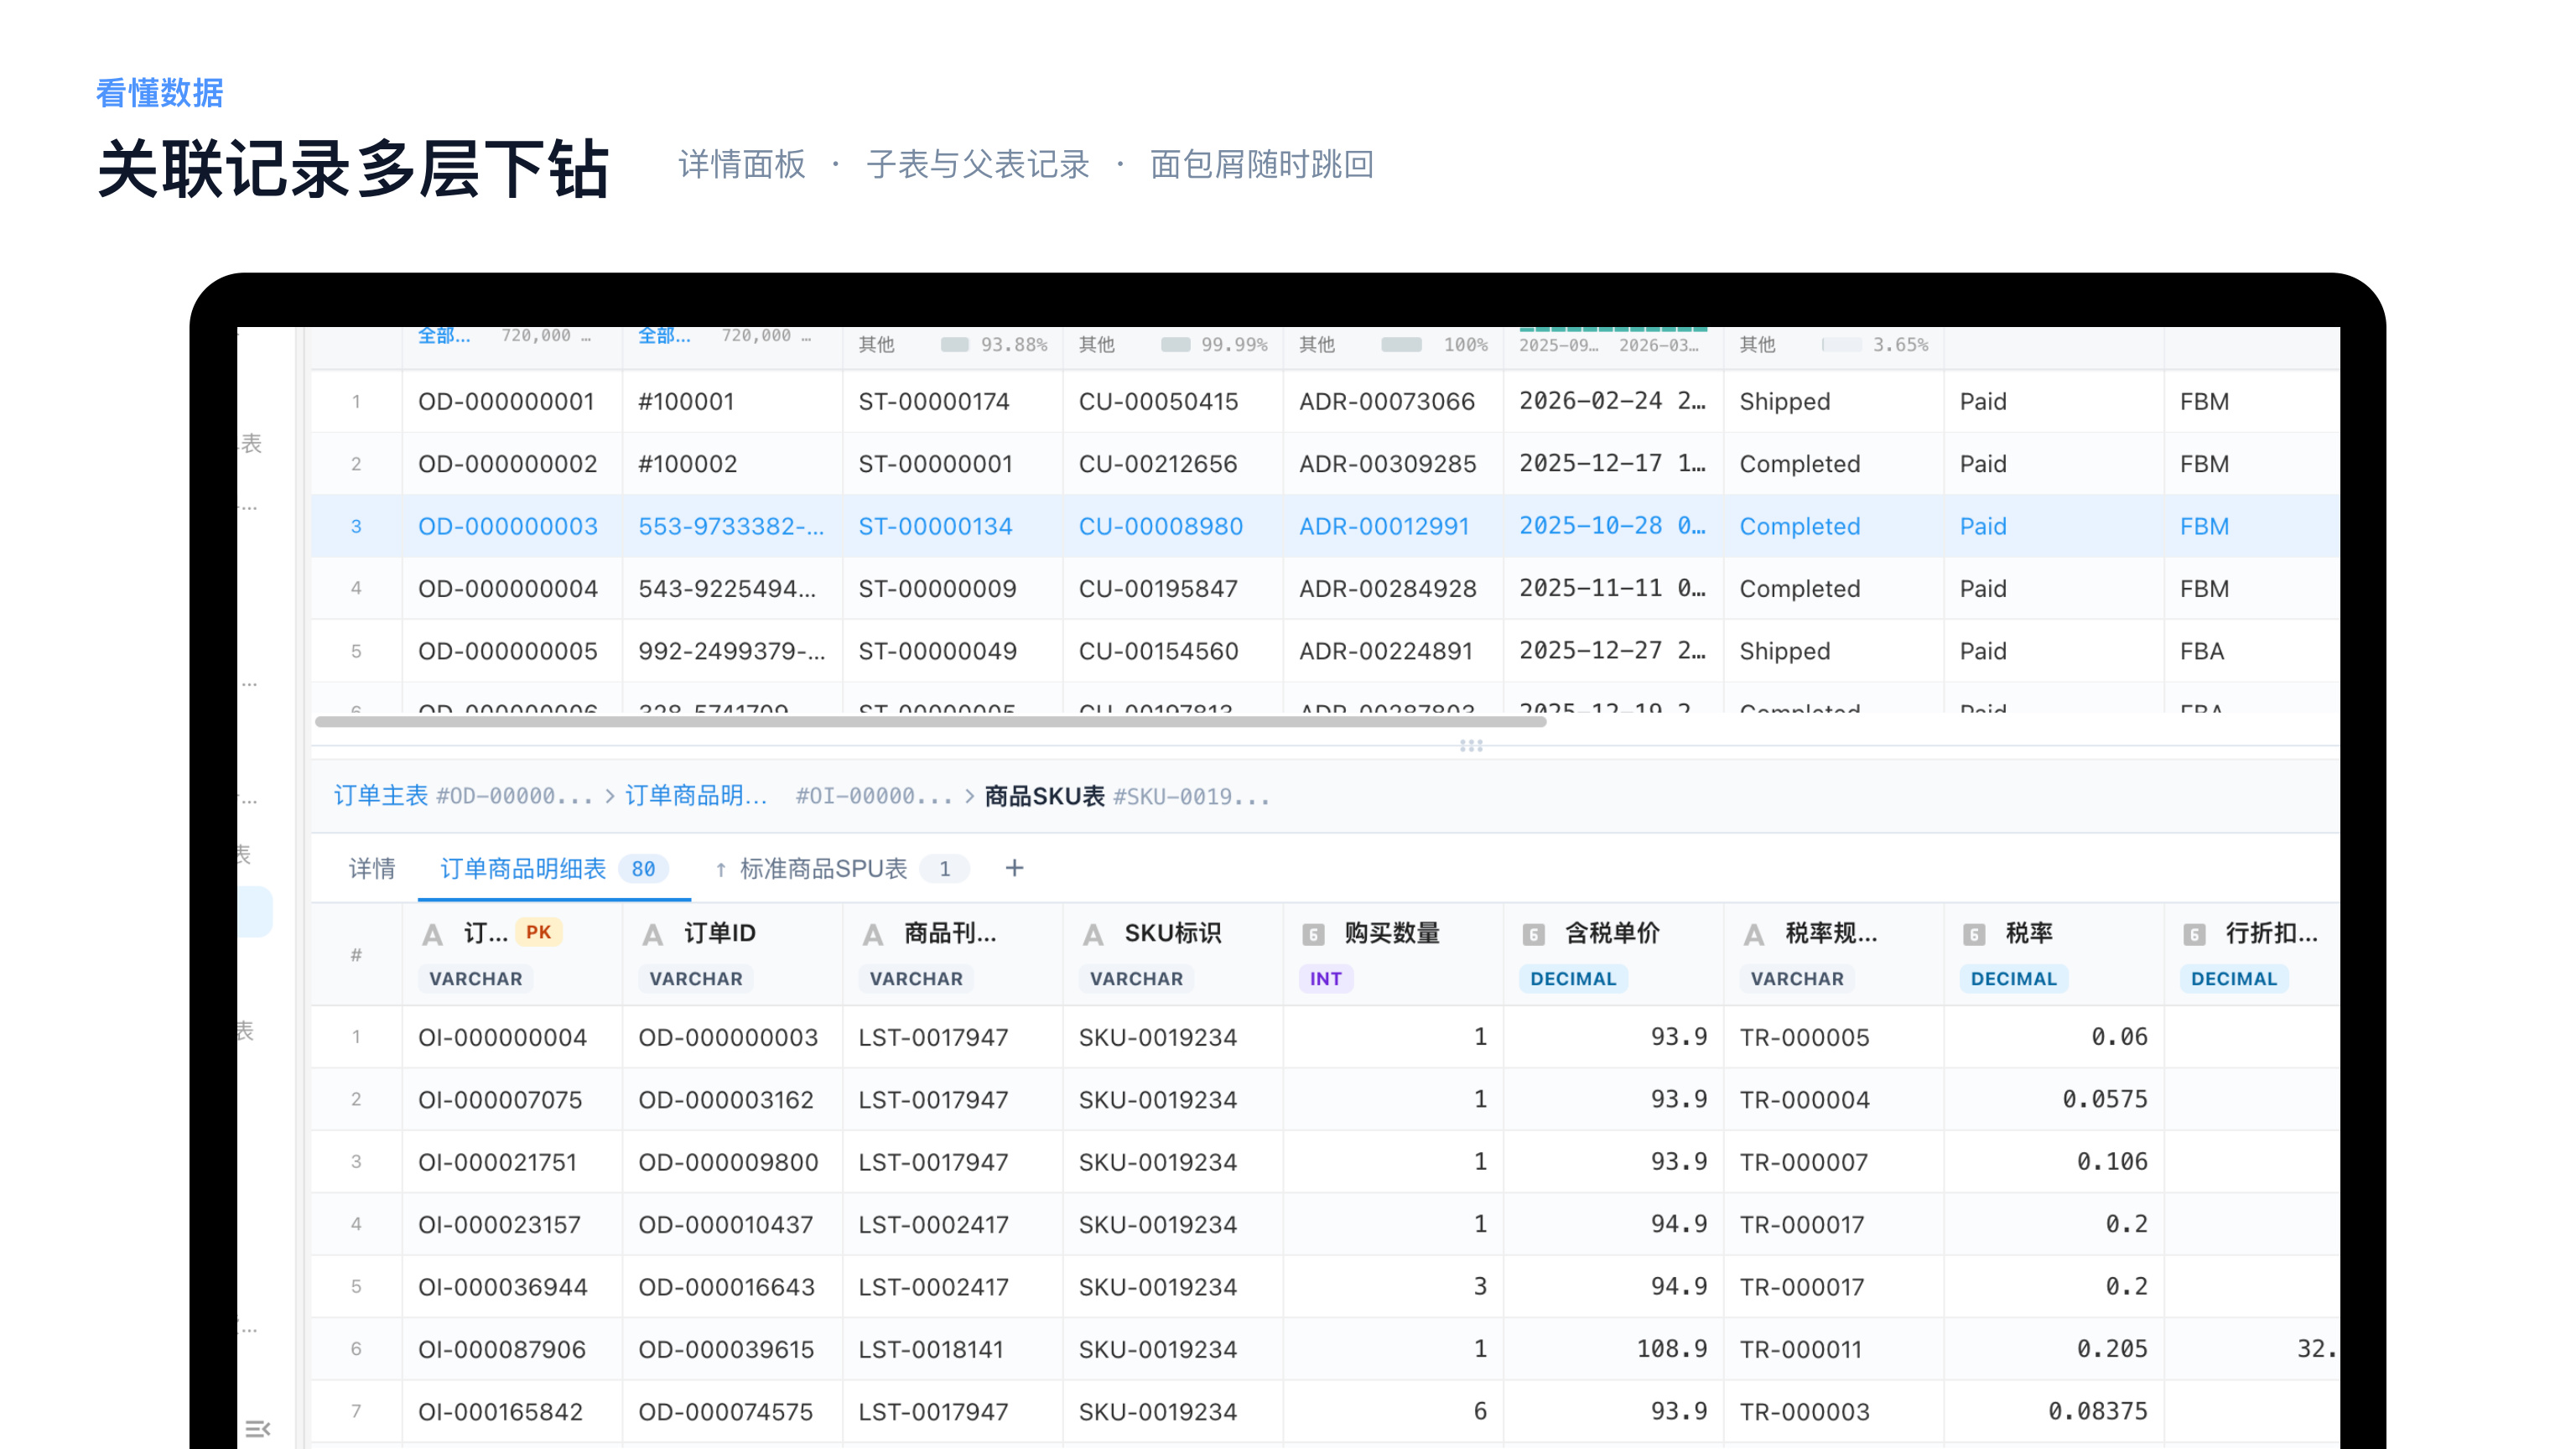
- 看数方式直连数据库、自由筛选、数据分布预览;关联下钻使用详情面板、子表与父表记录及面包屑。
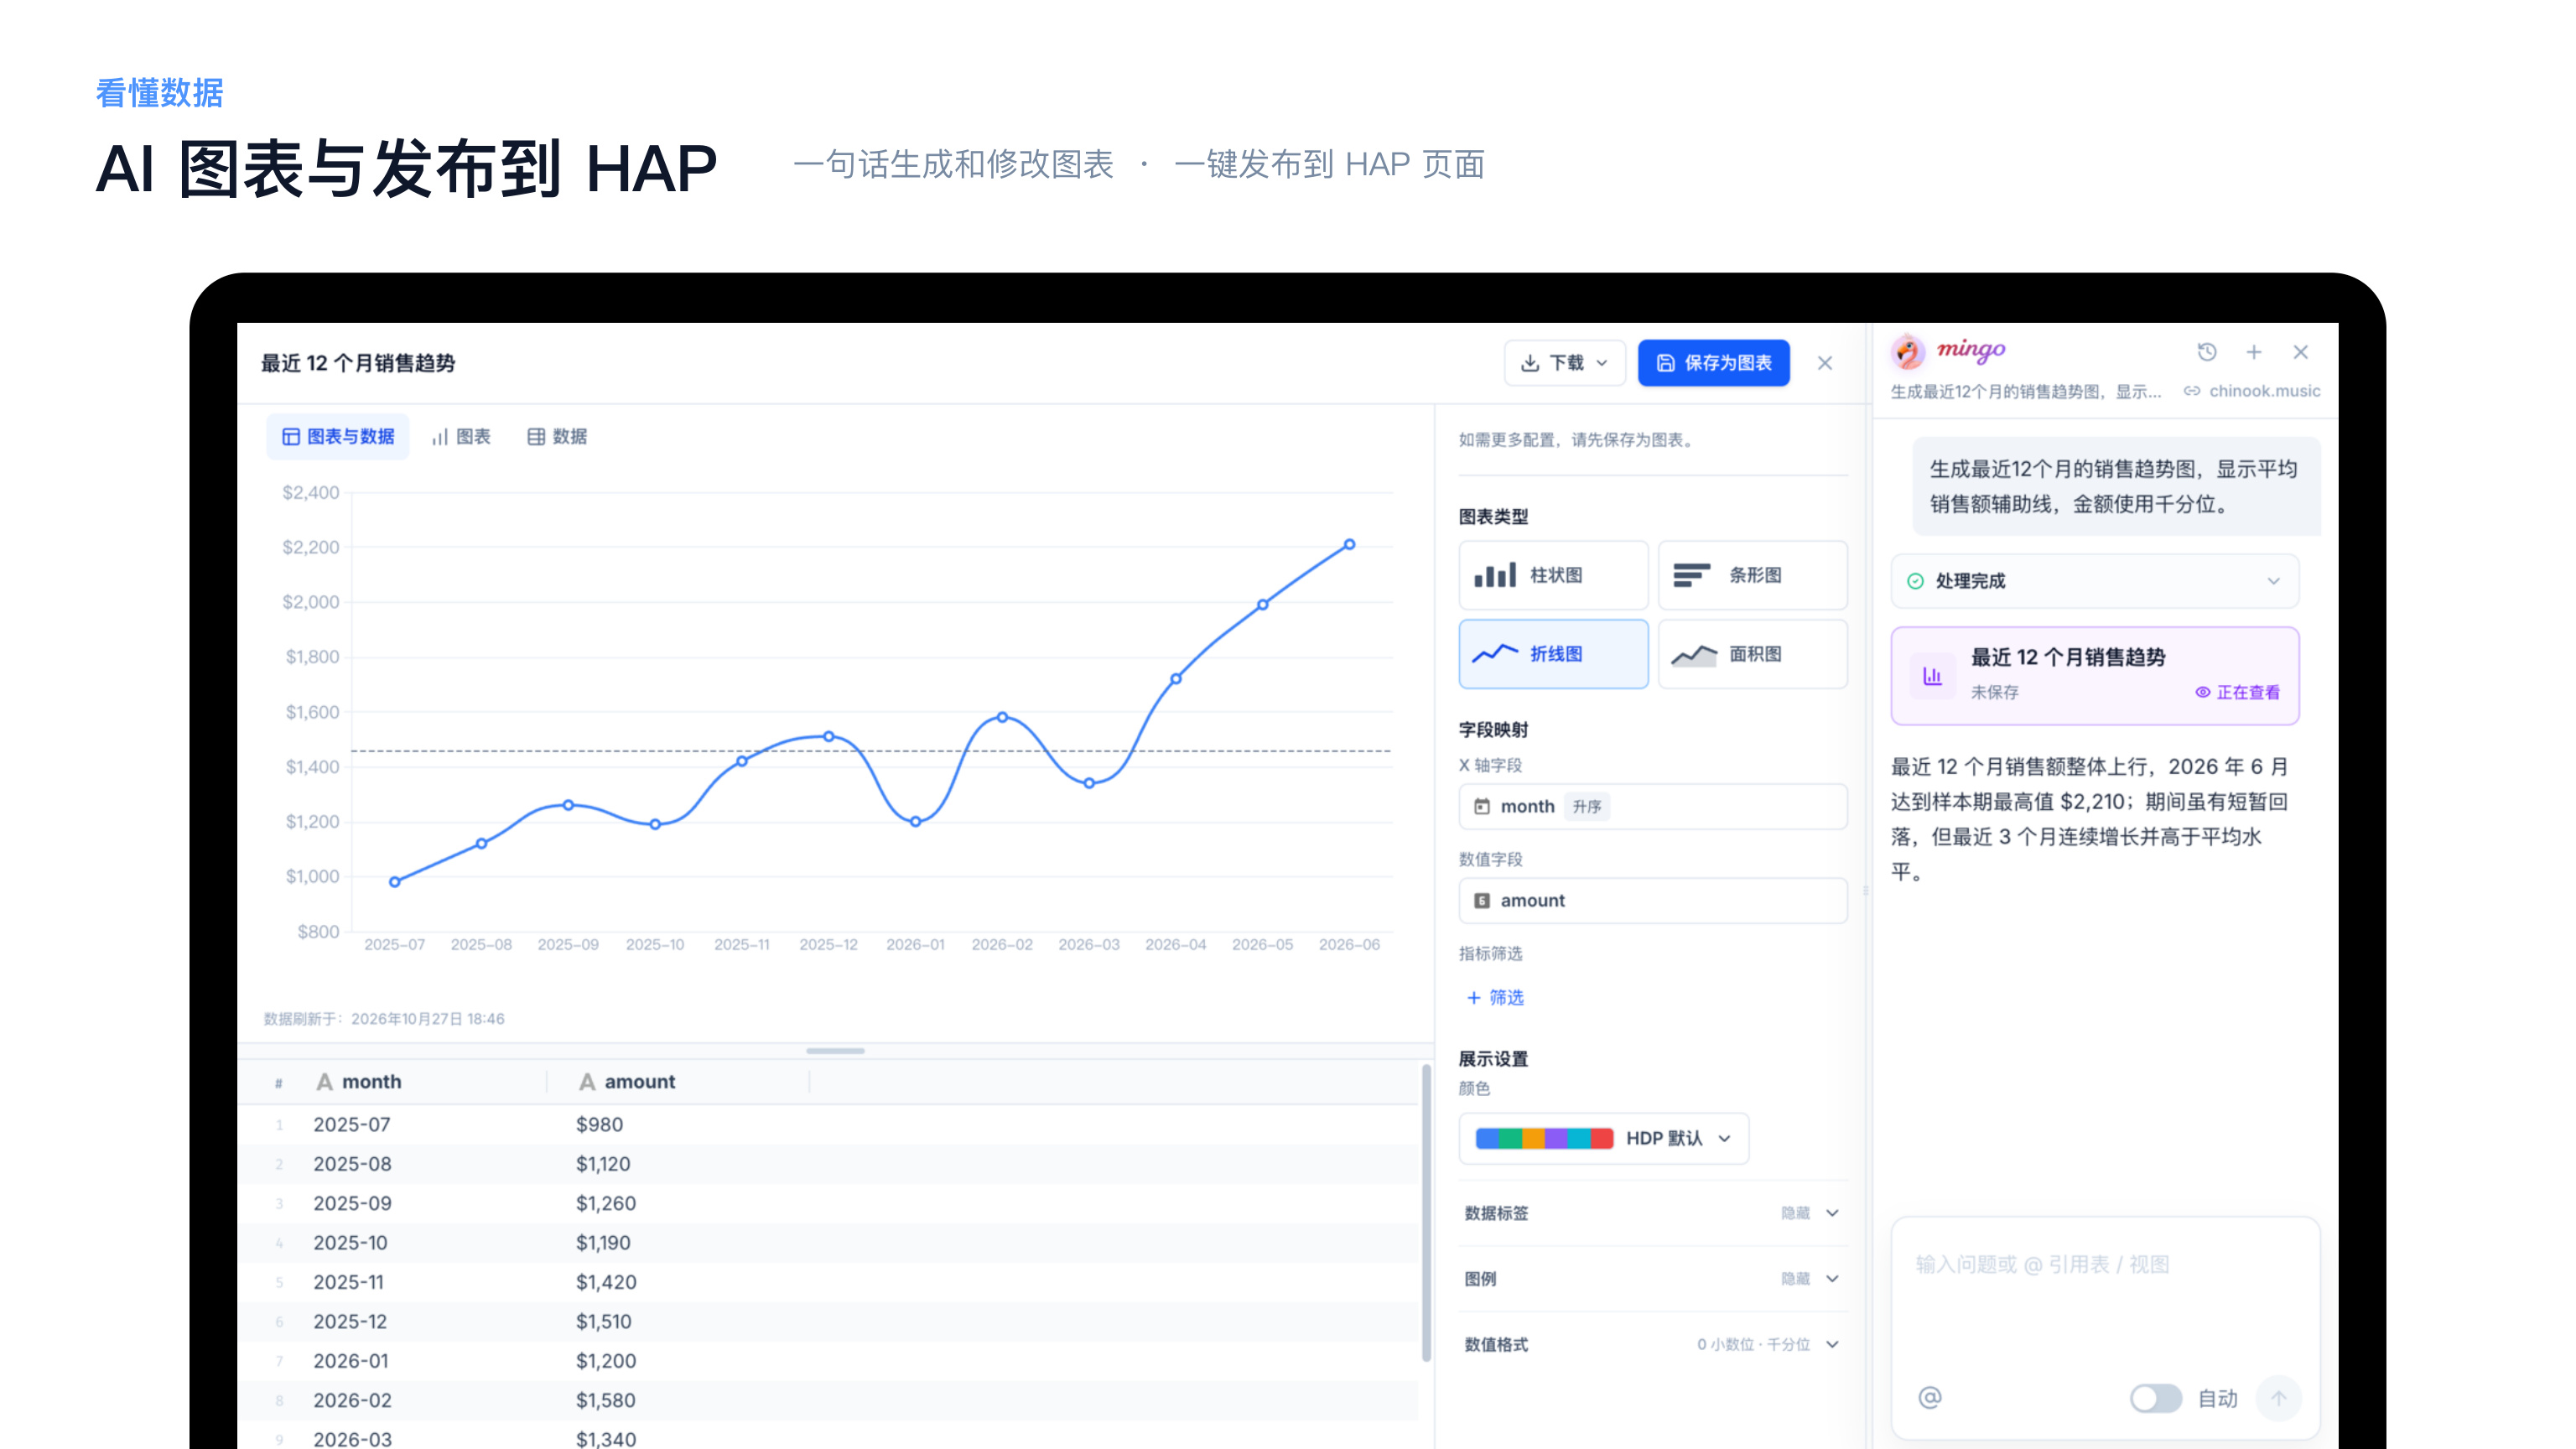
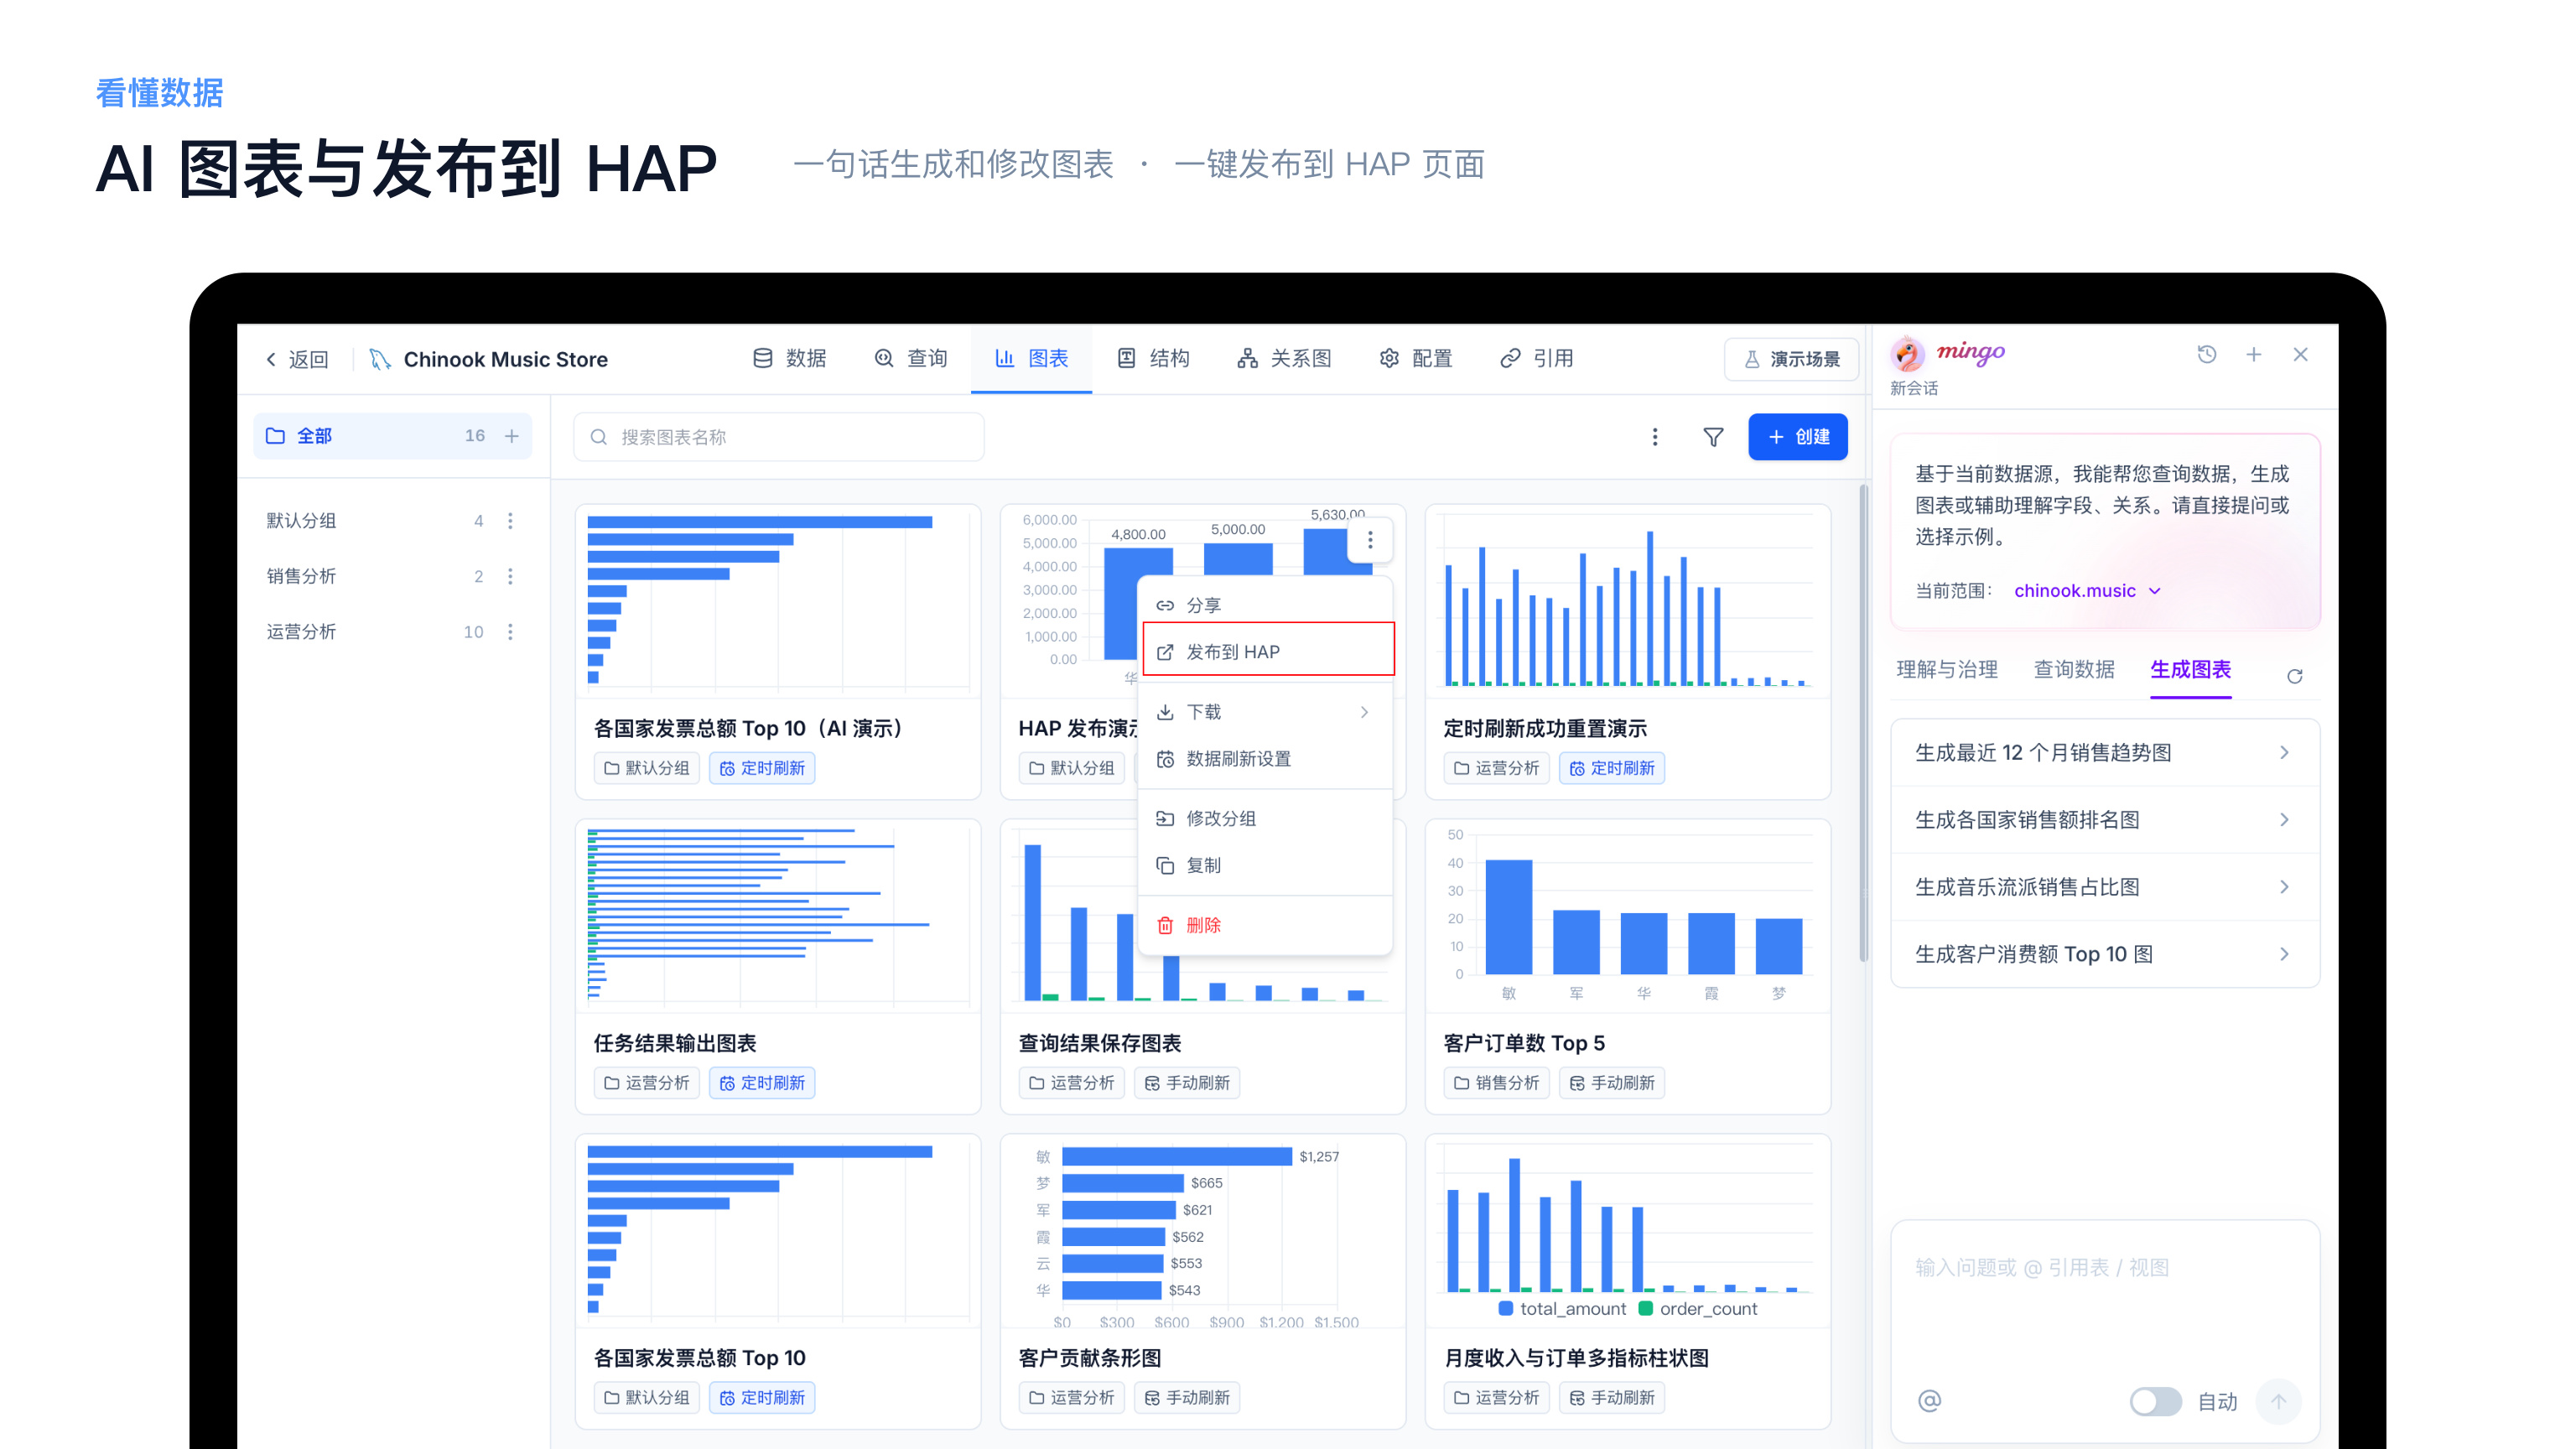
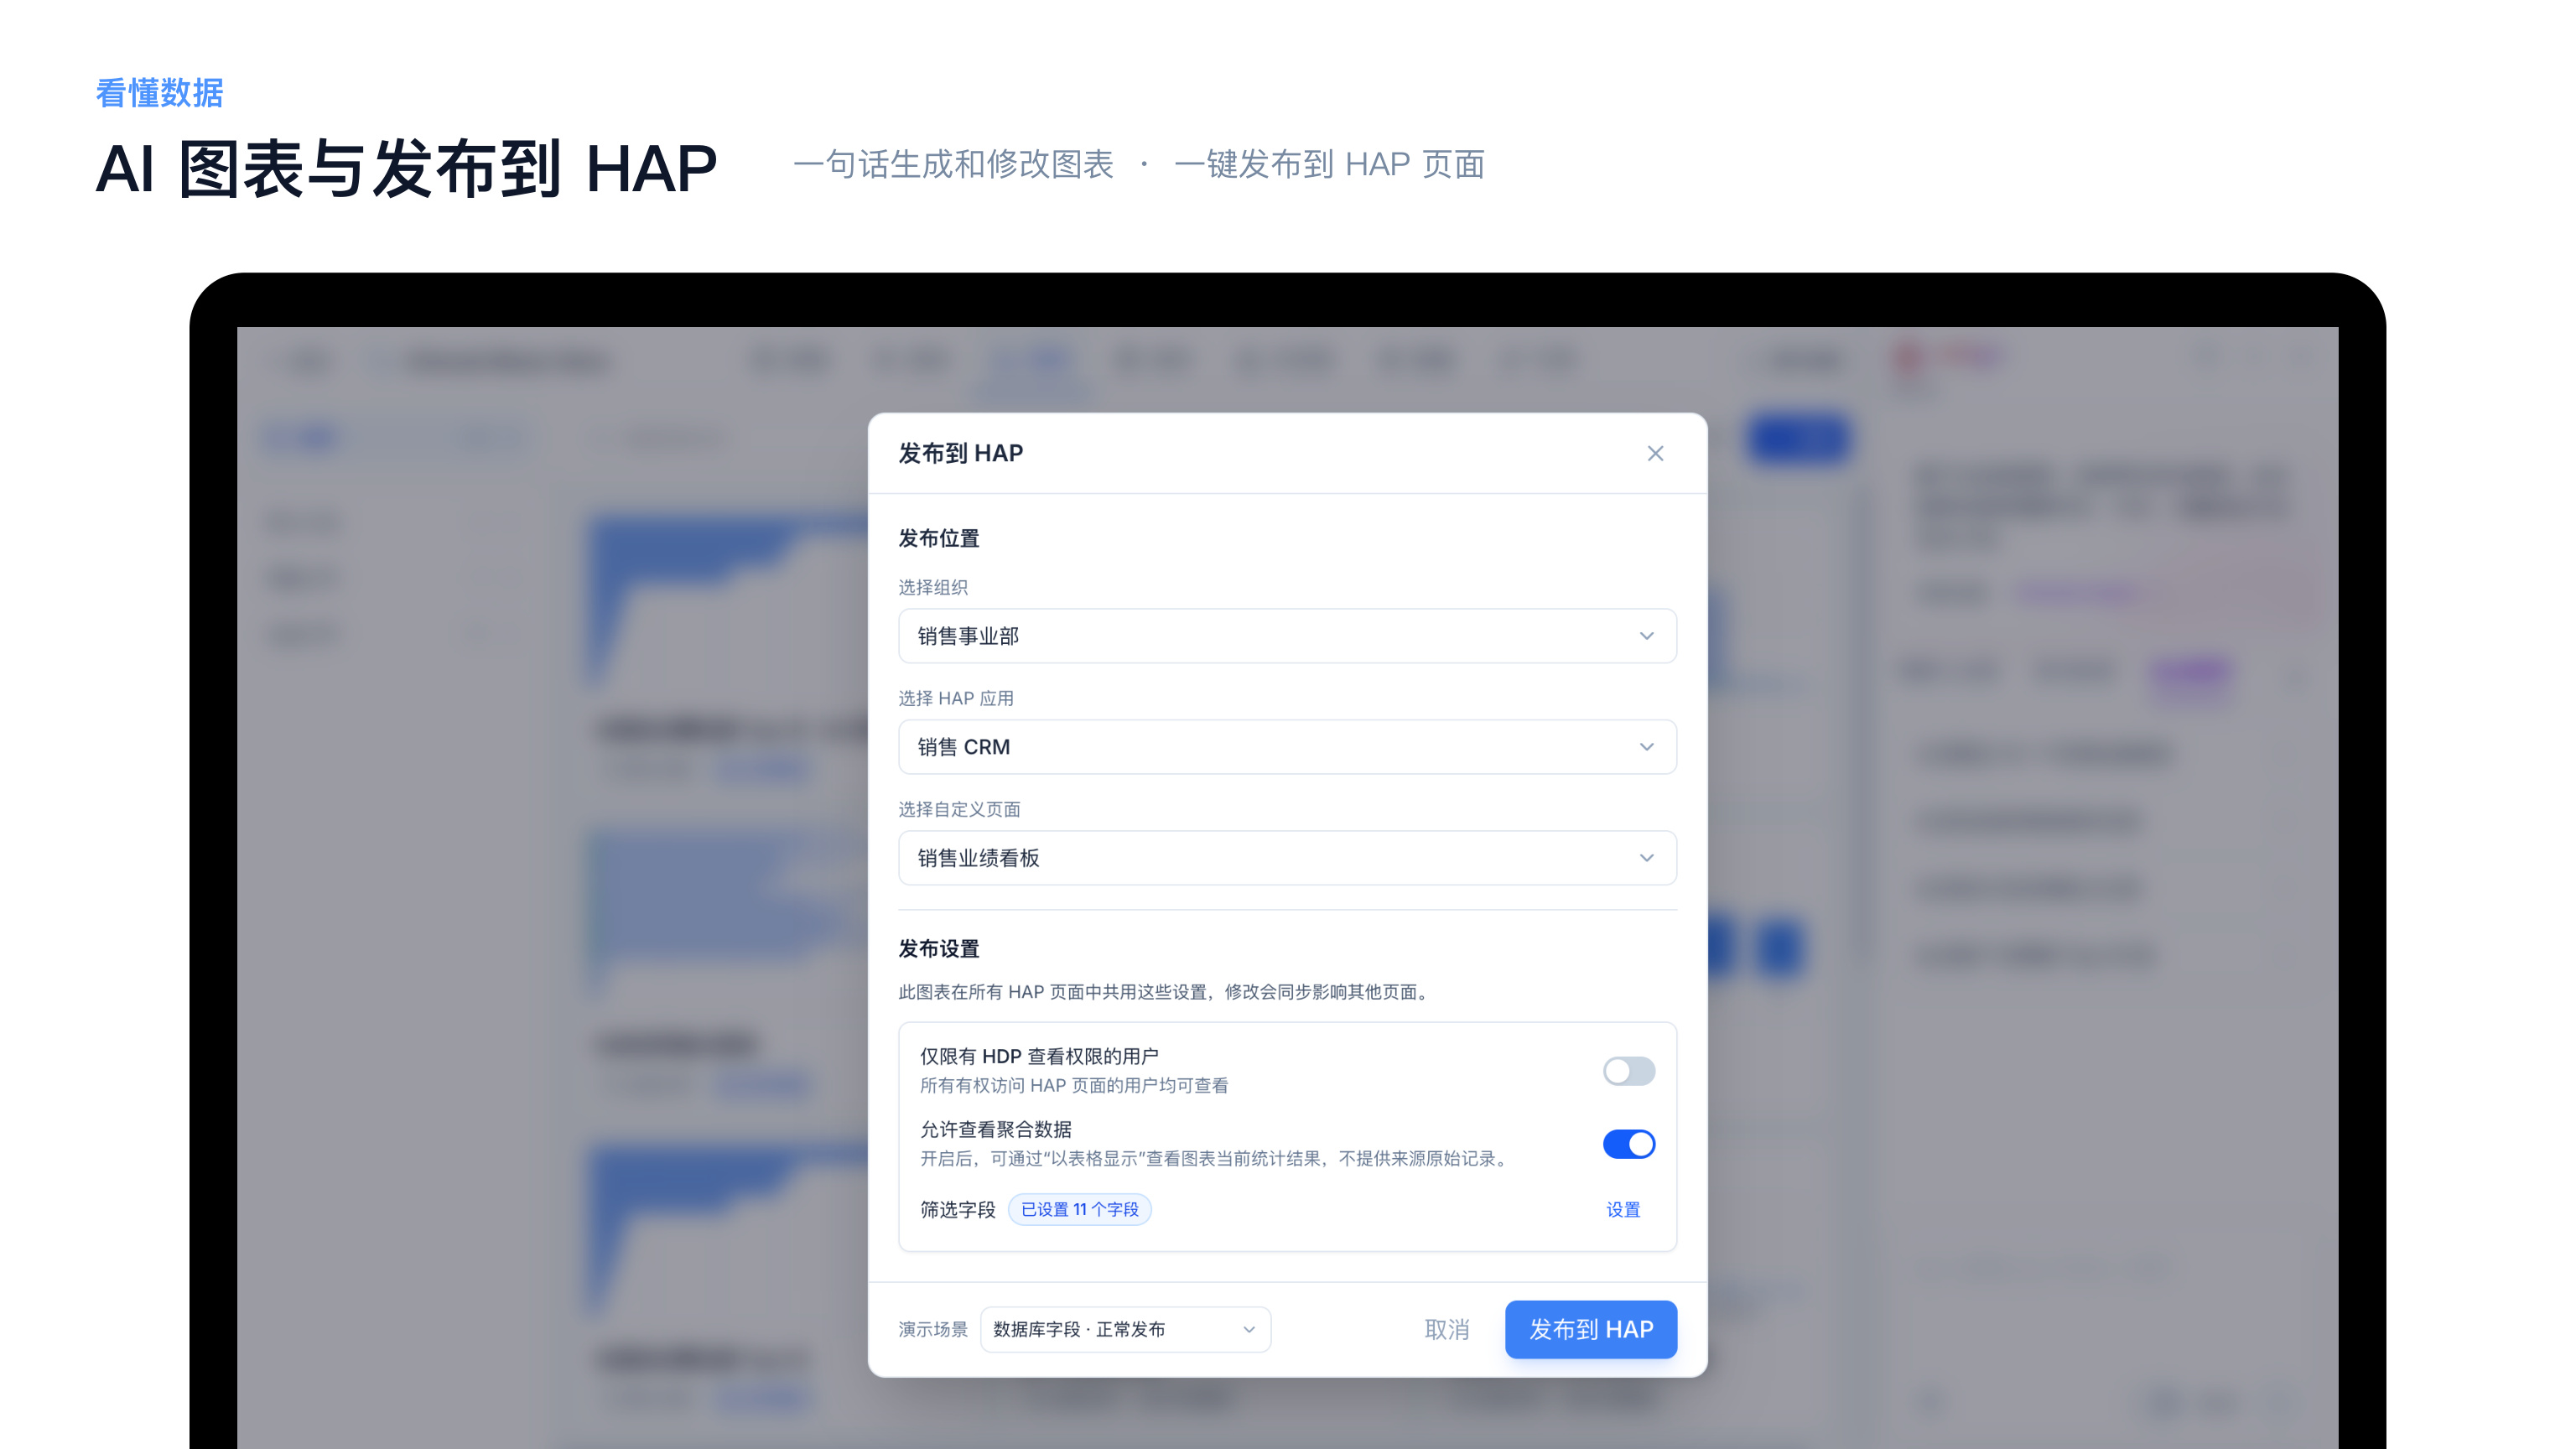
- 出图与发布一句话生成和修改图表,并可一键发布到 HAP 页面。
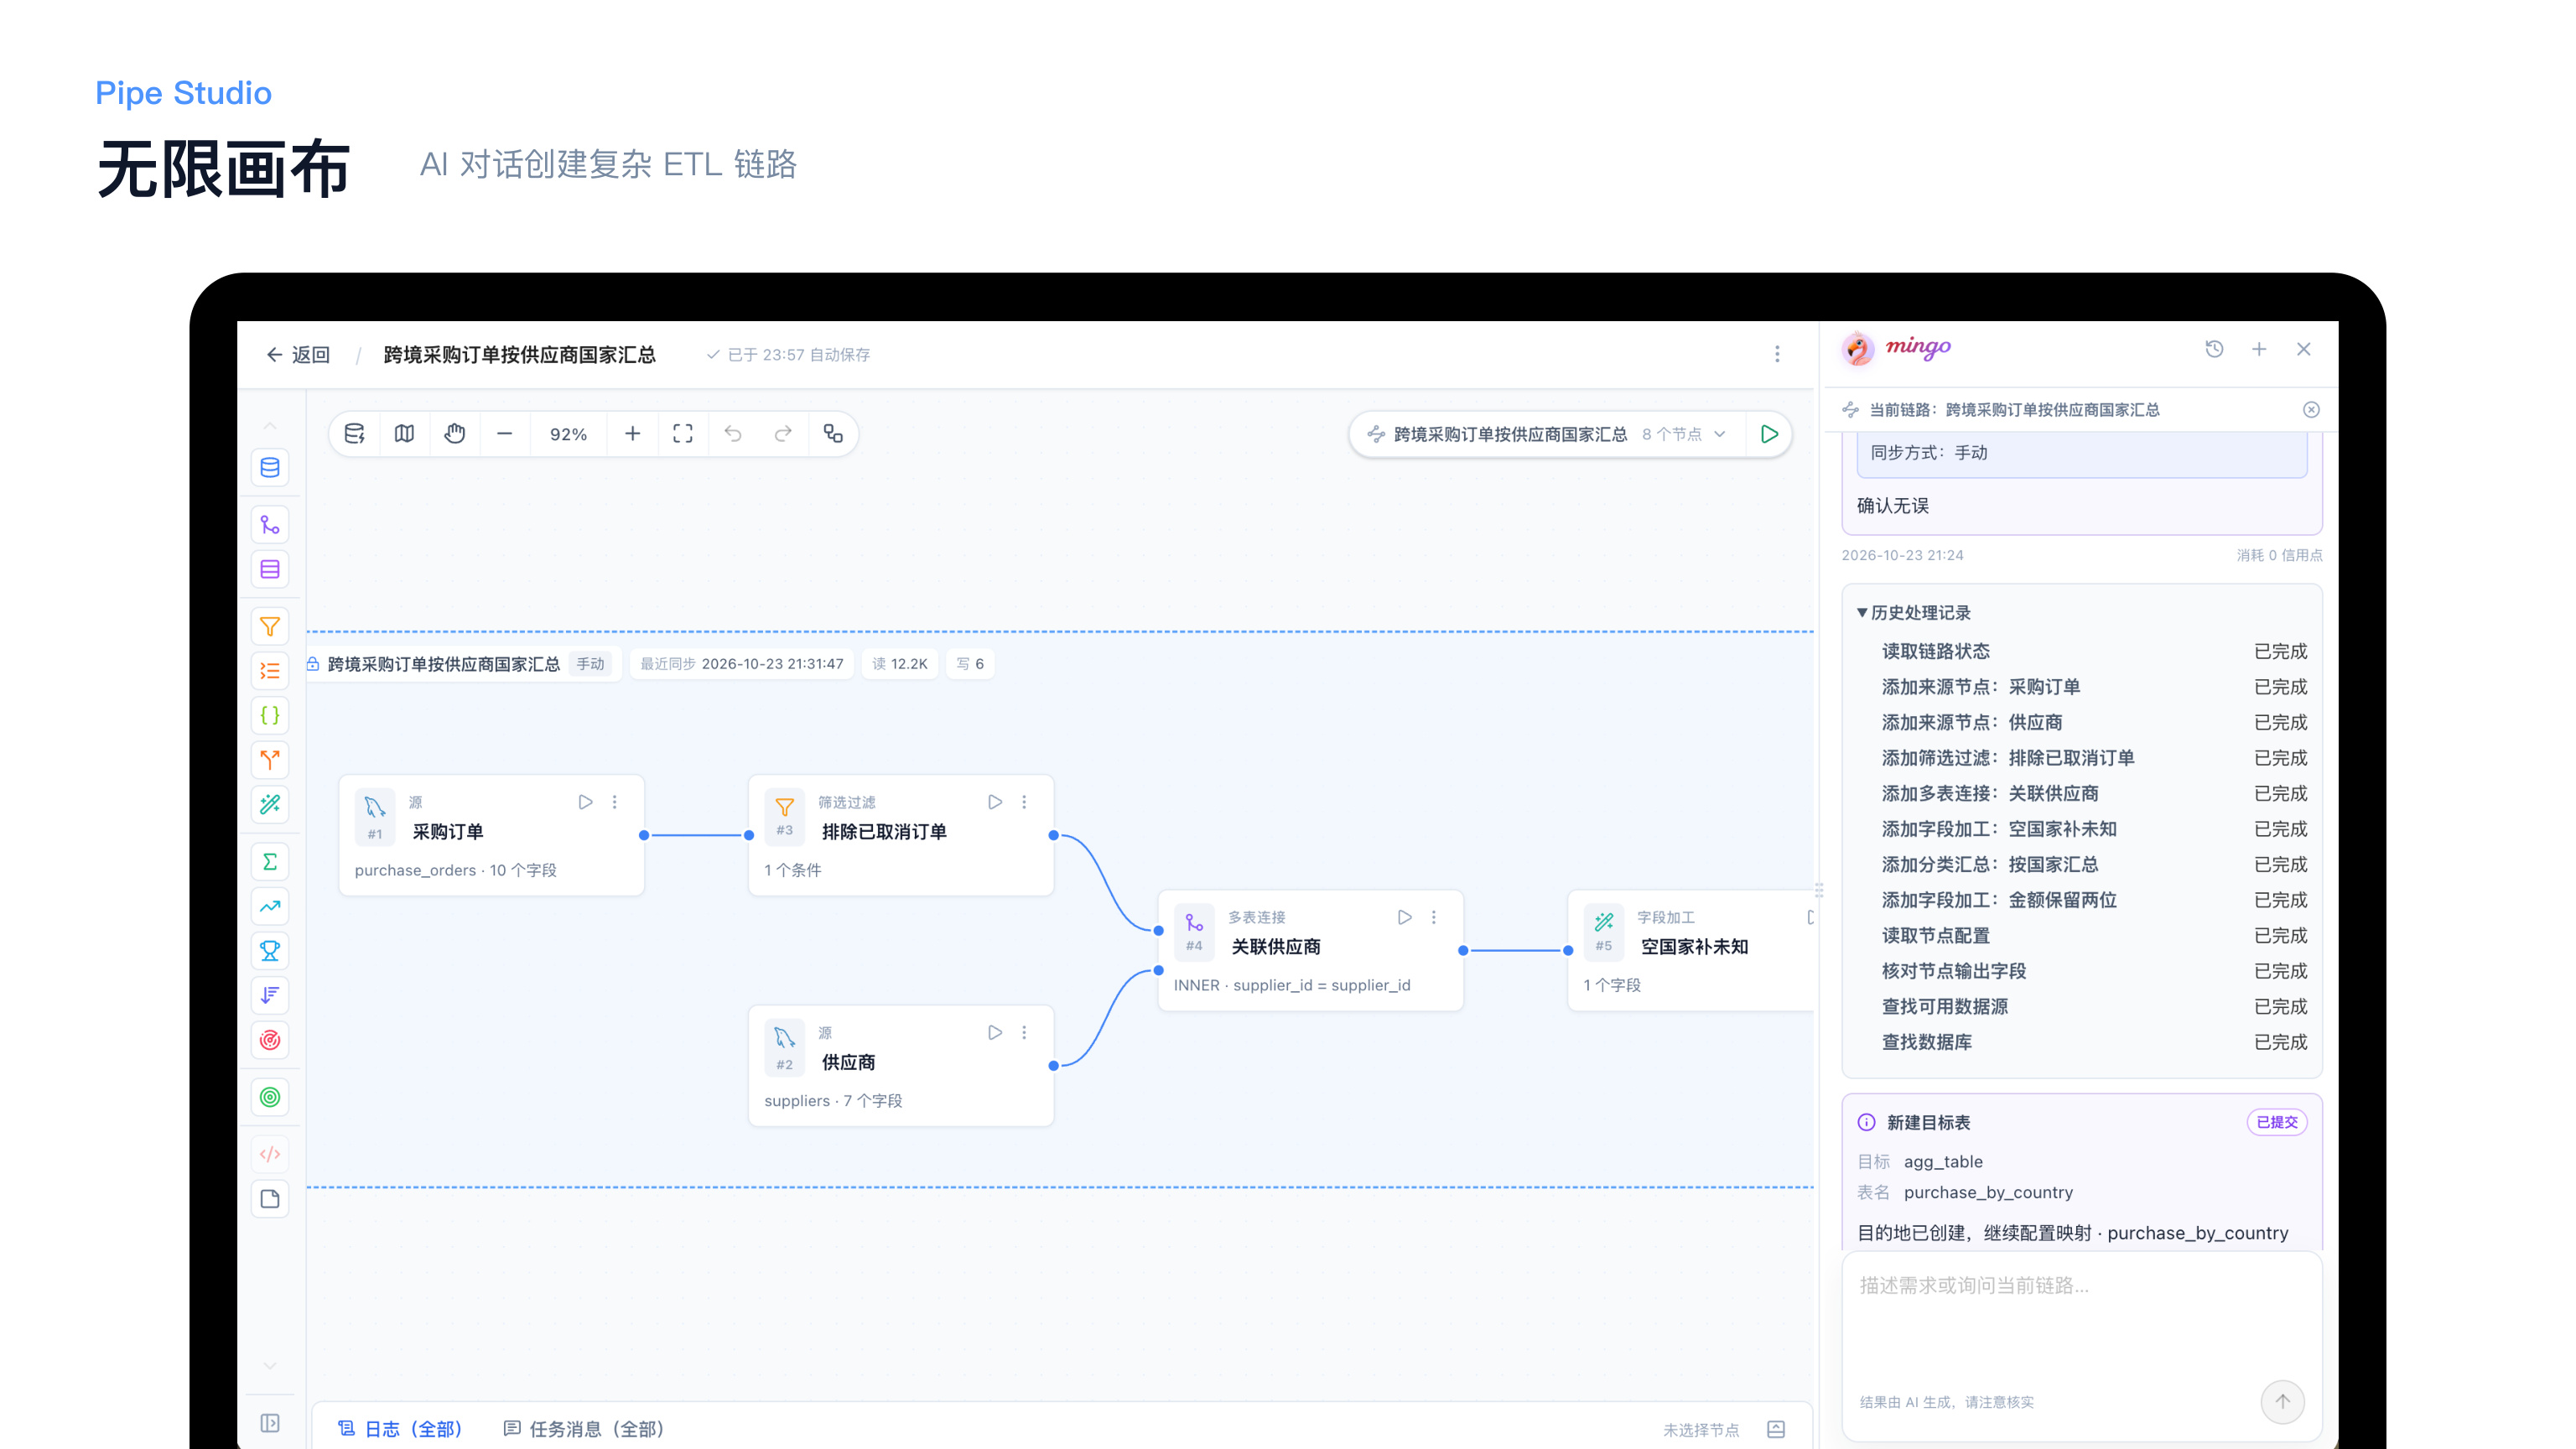
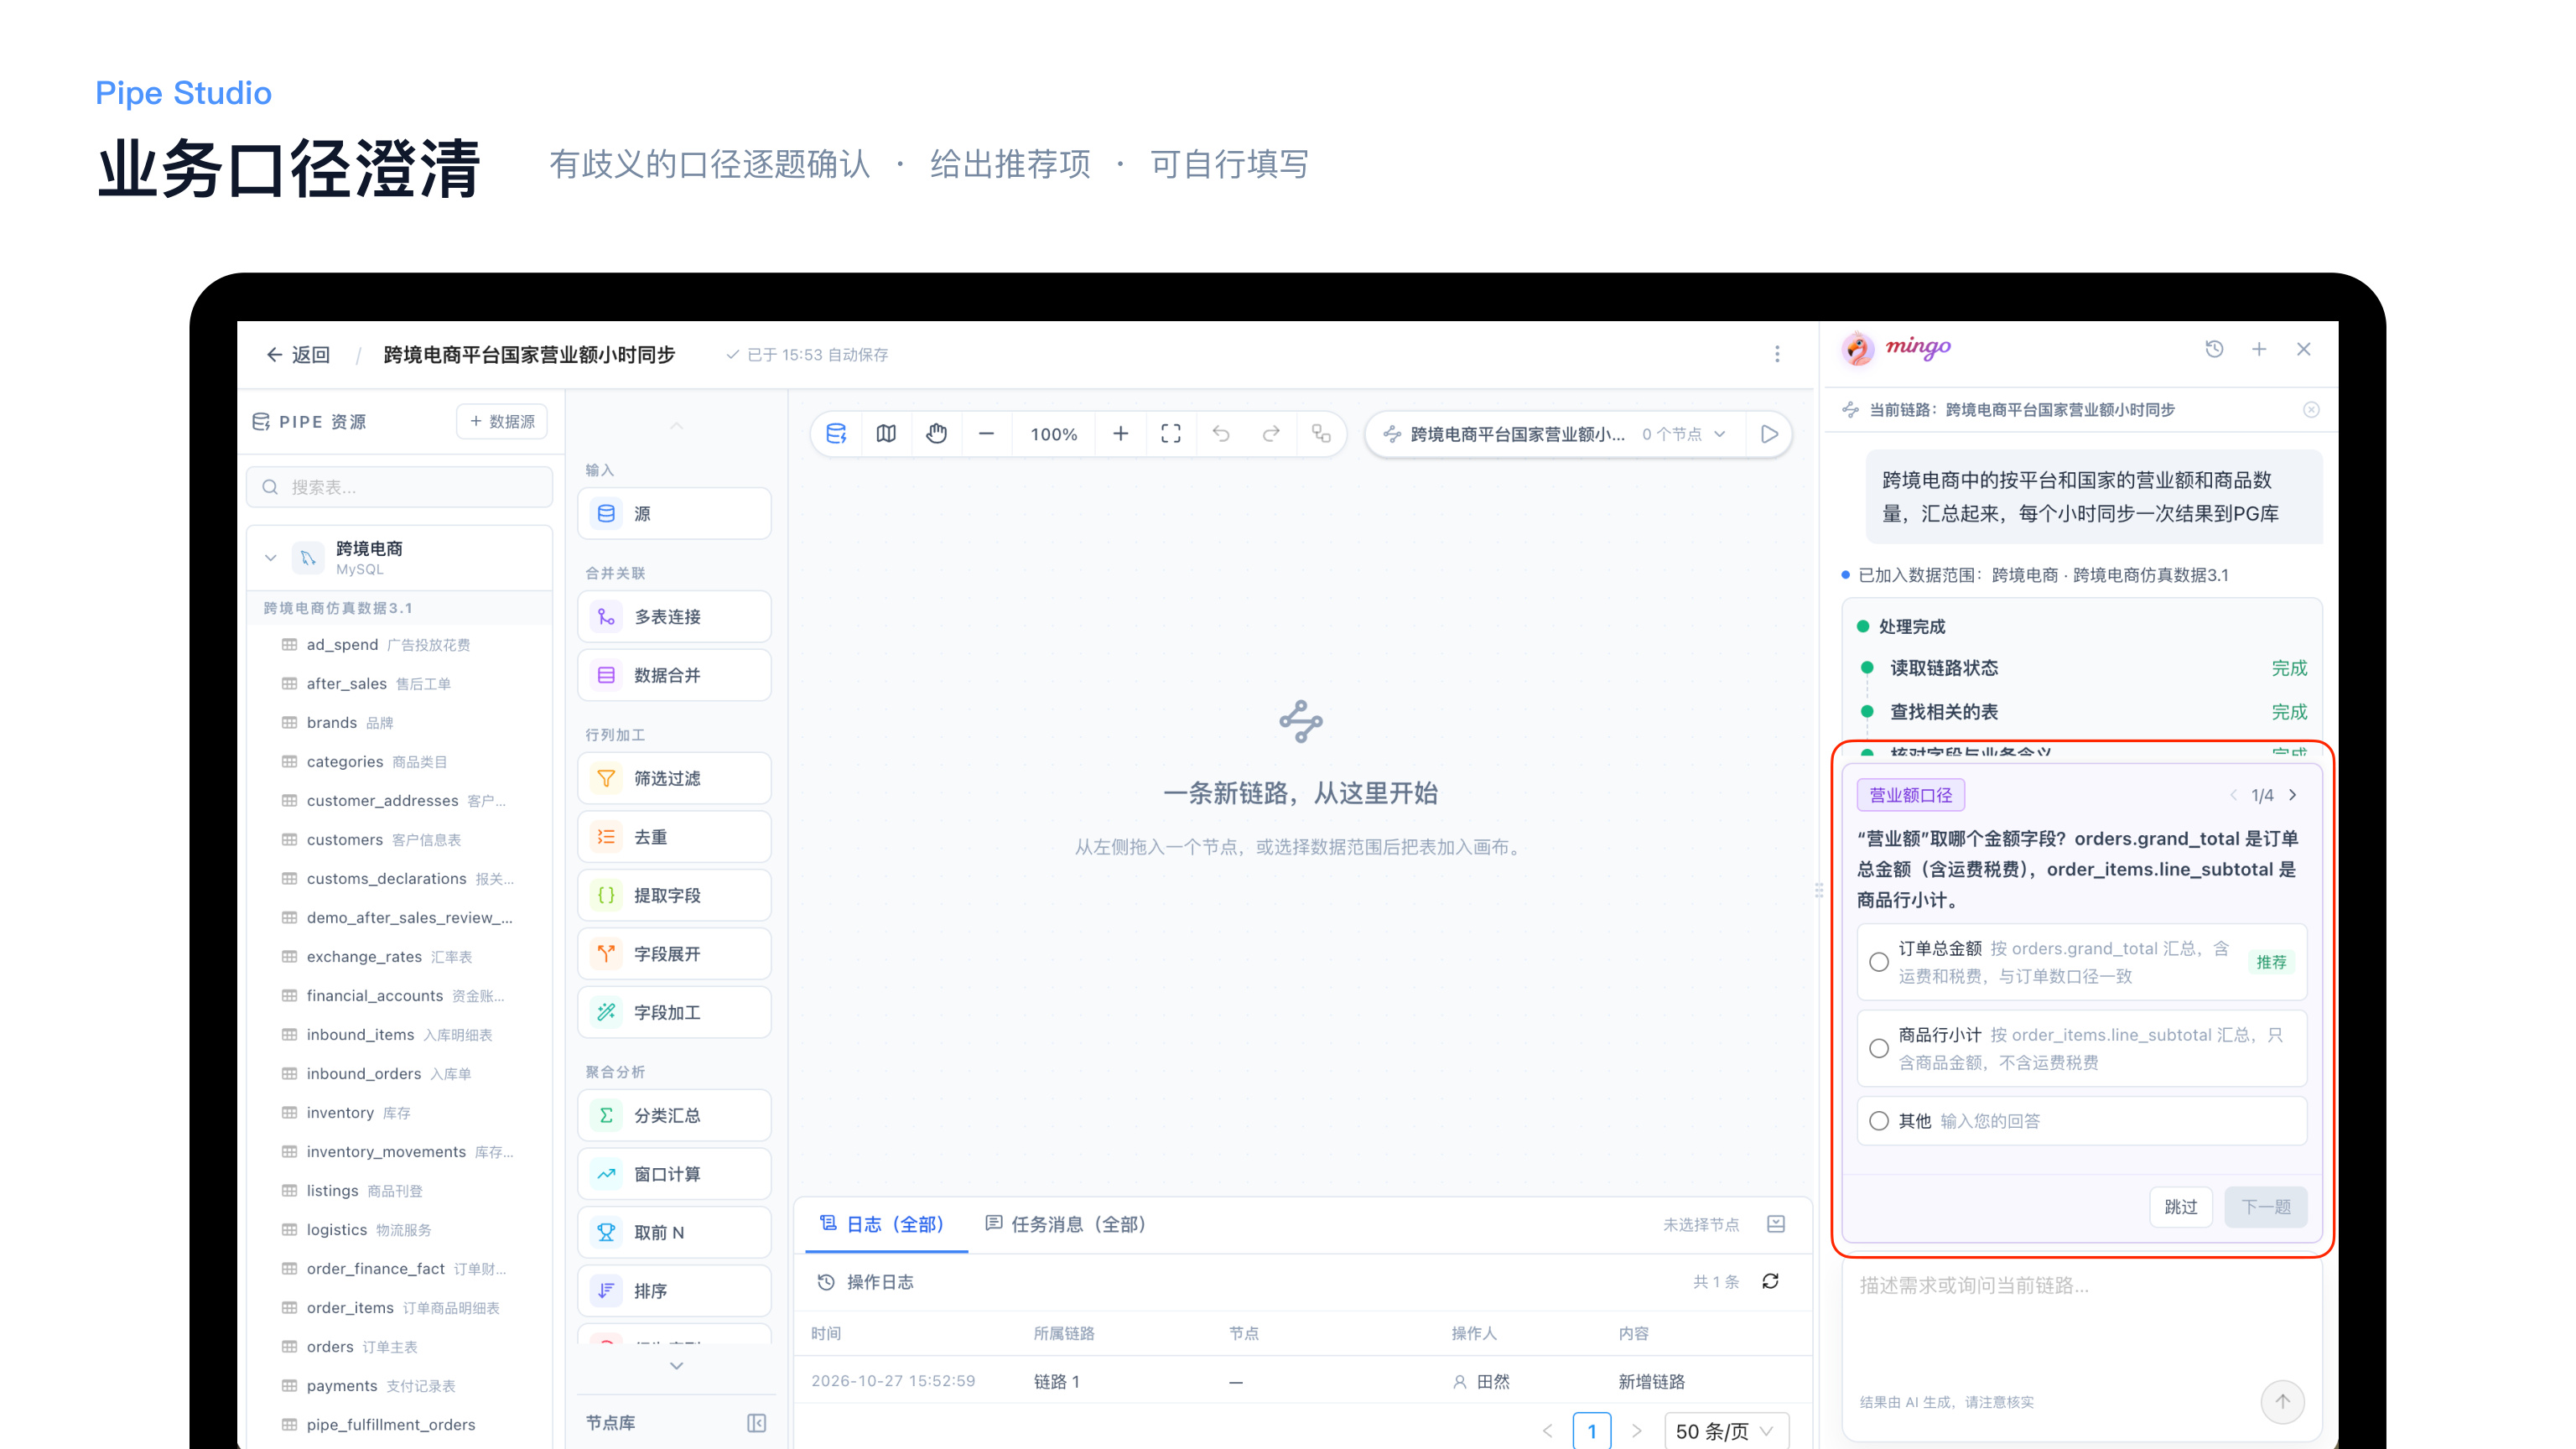
- Pipe StudioAI 对话创建 ETL 链路;对有歧义的业务口径逐题确认,给出推荐项,也可自行填写。
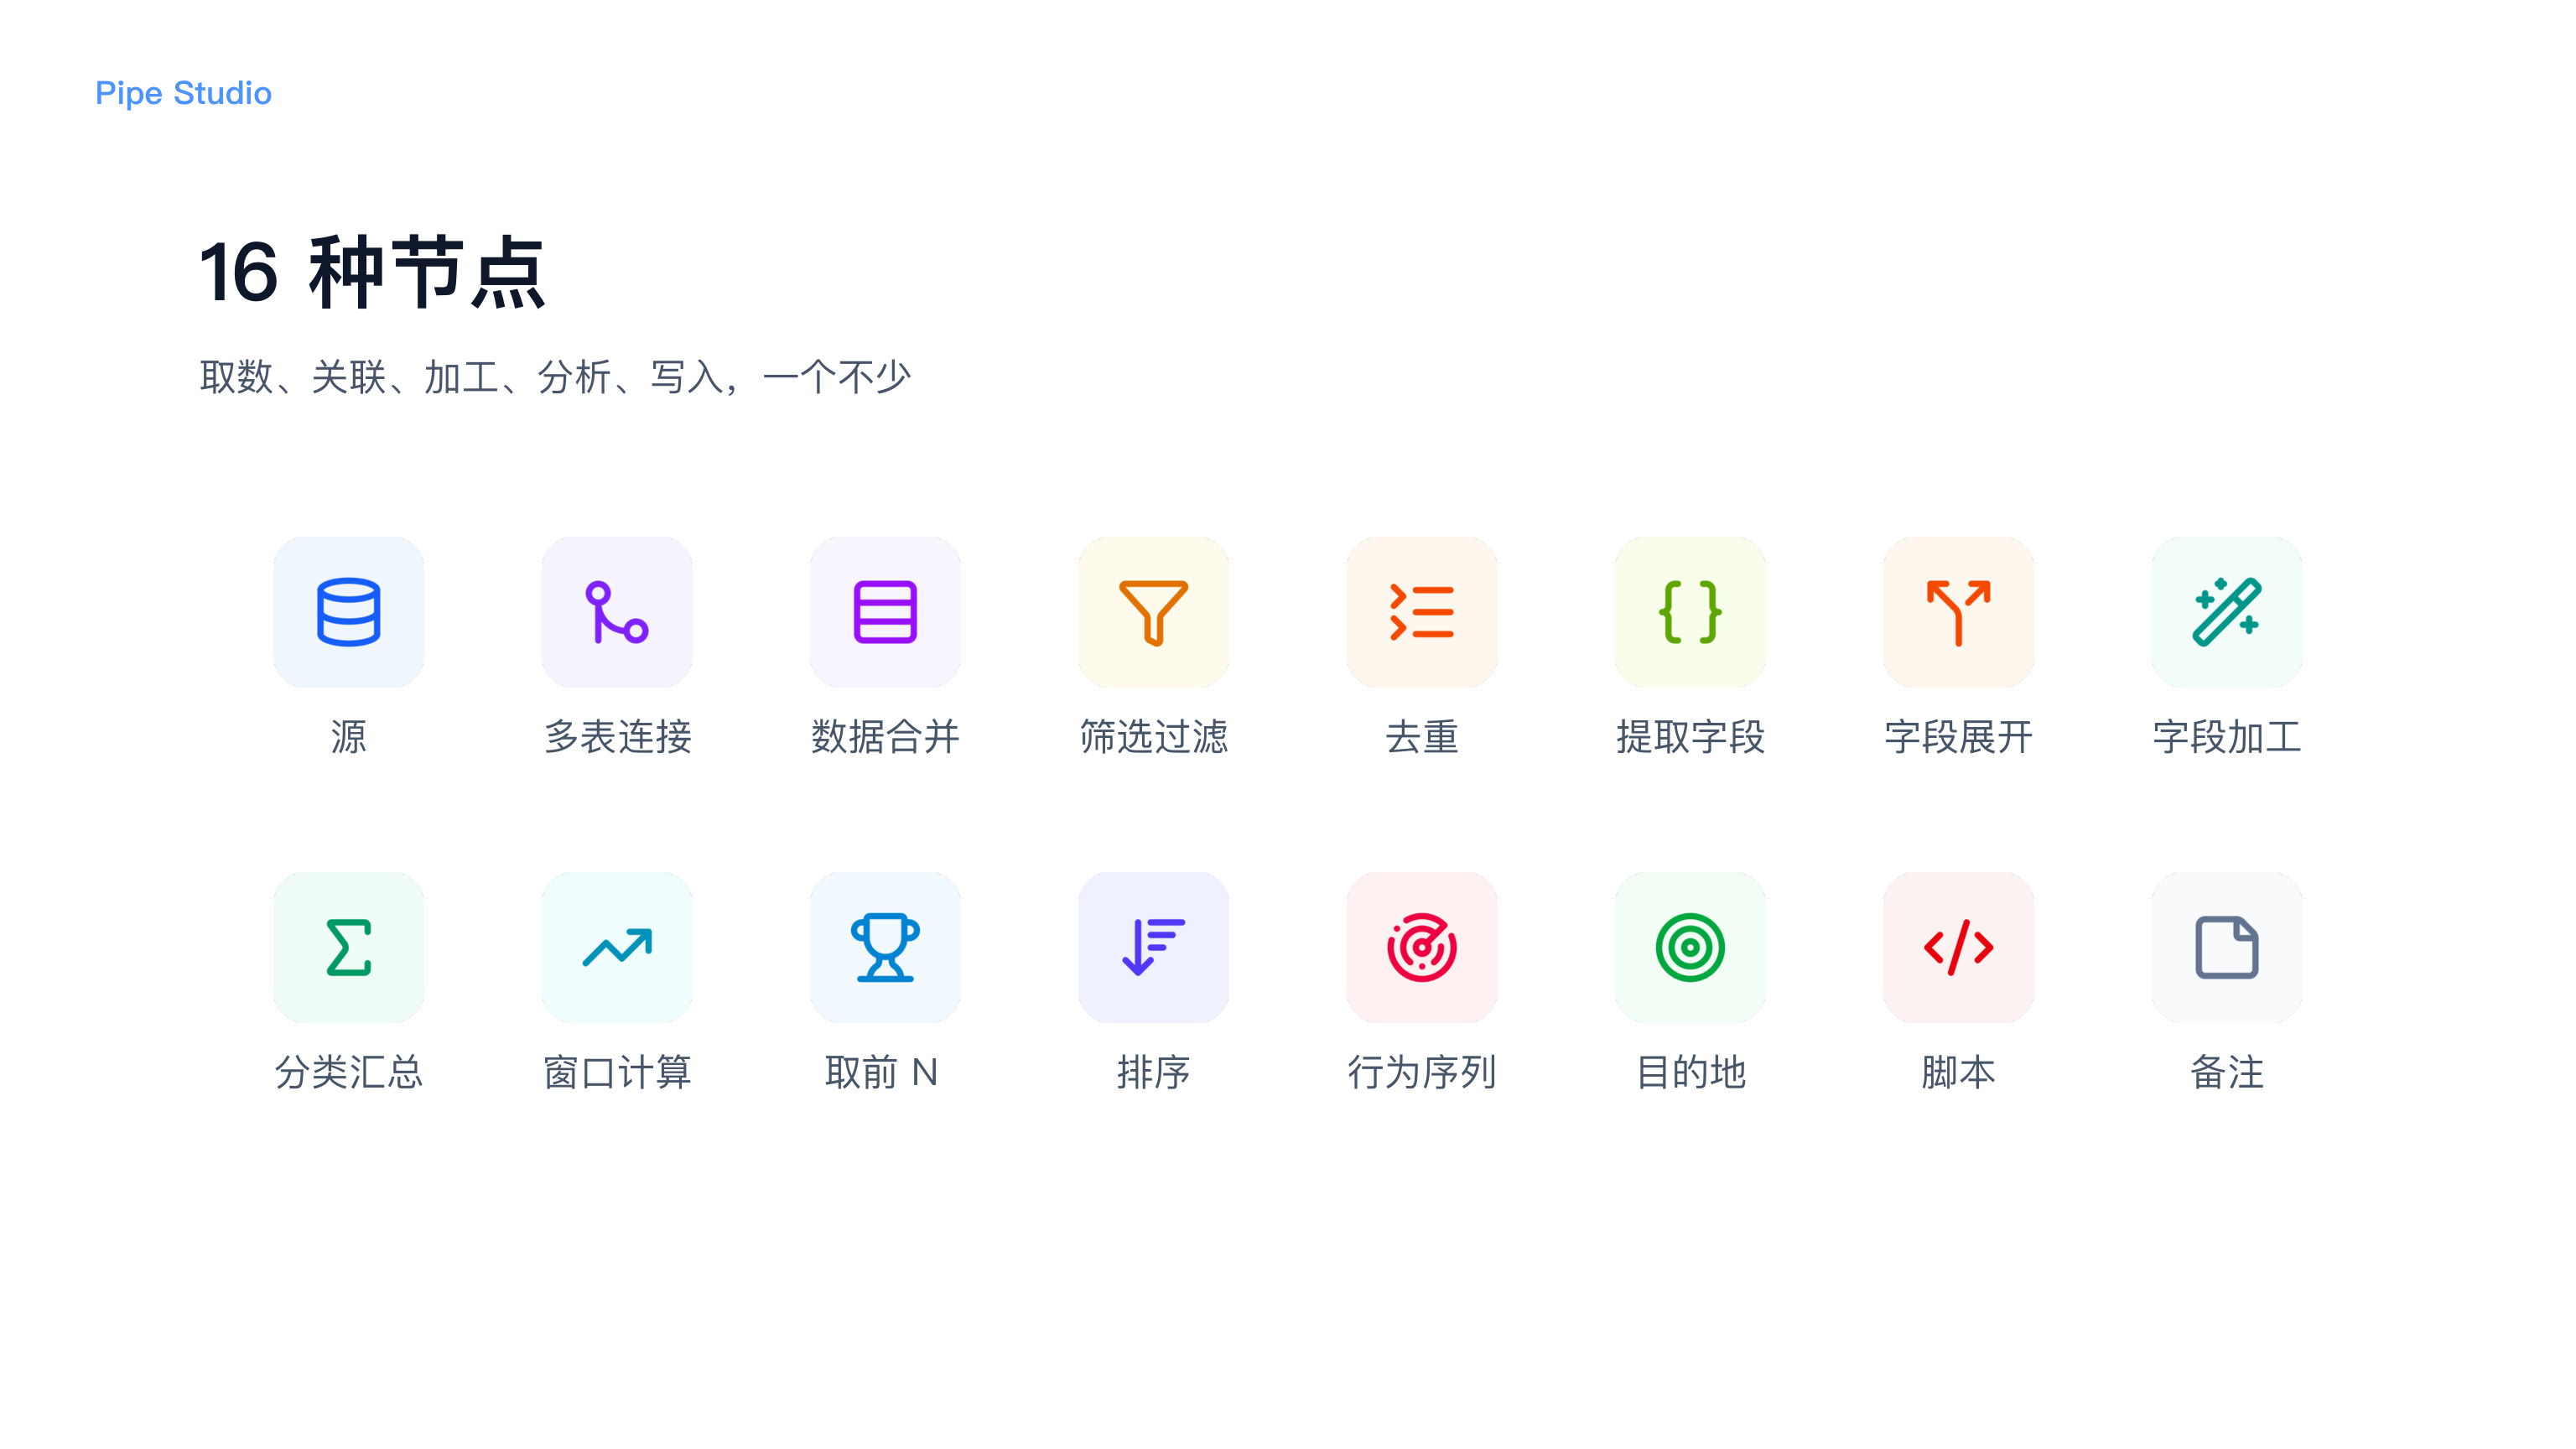
- 16 种节点源、多表连接、数据合并、筛选过滤、去重、提取字段、字段展开、字段加工、分类汇总、窗口计算、取前 N、排序、行为序列、目的地、脚本、备注。
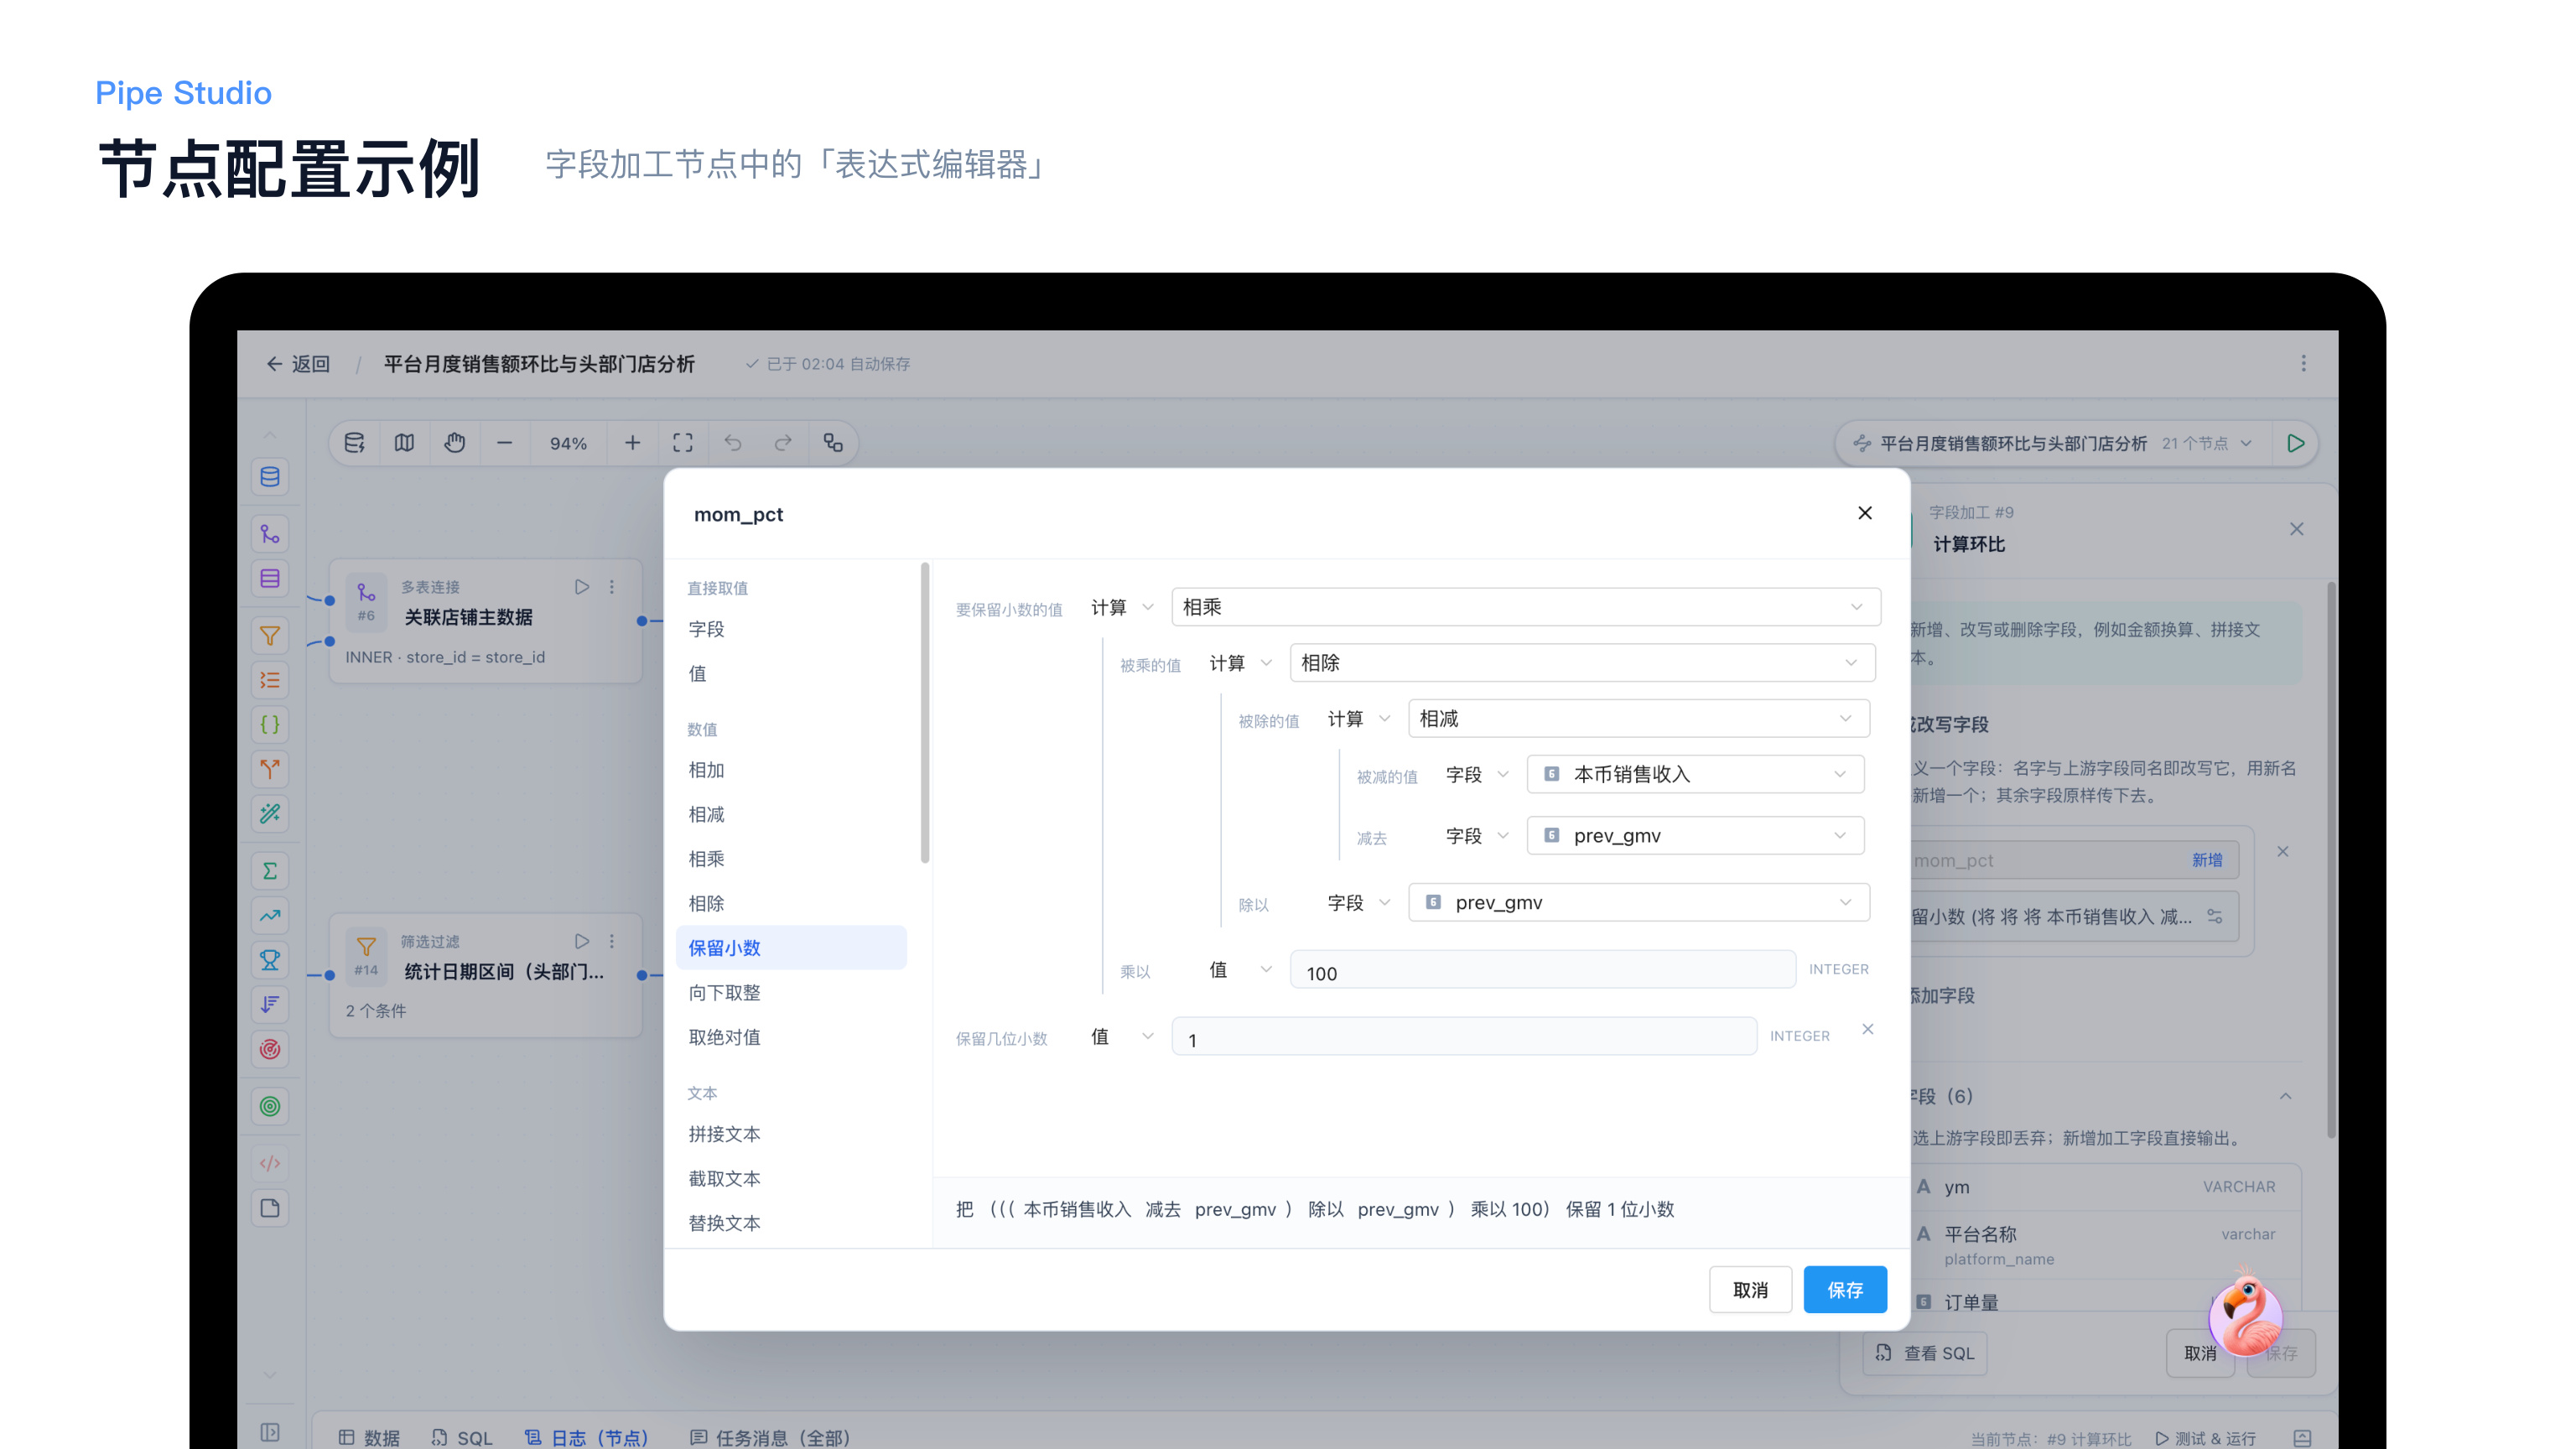
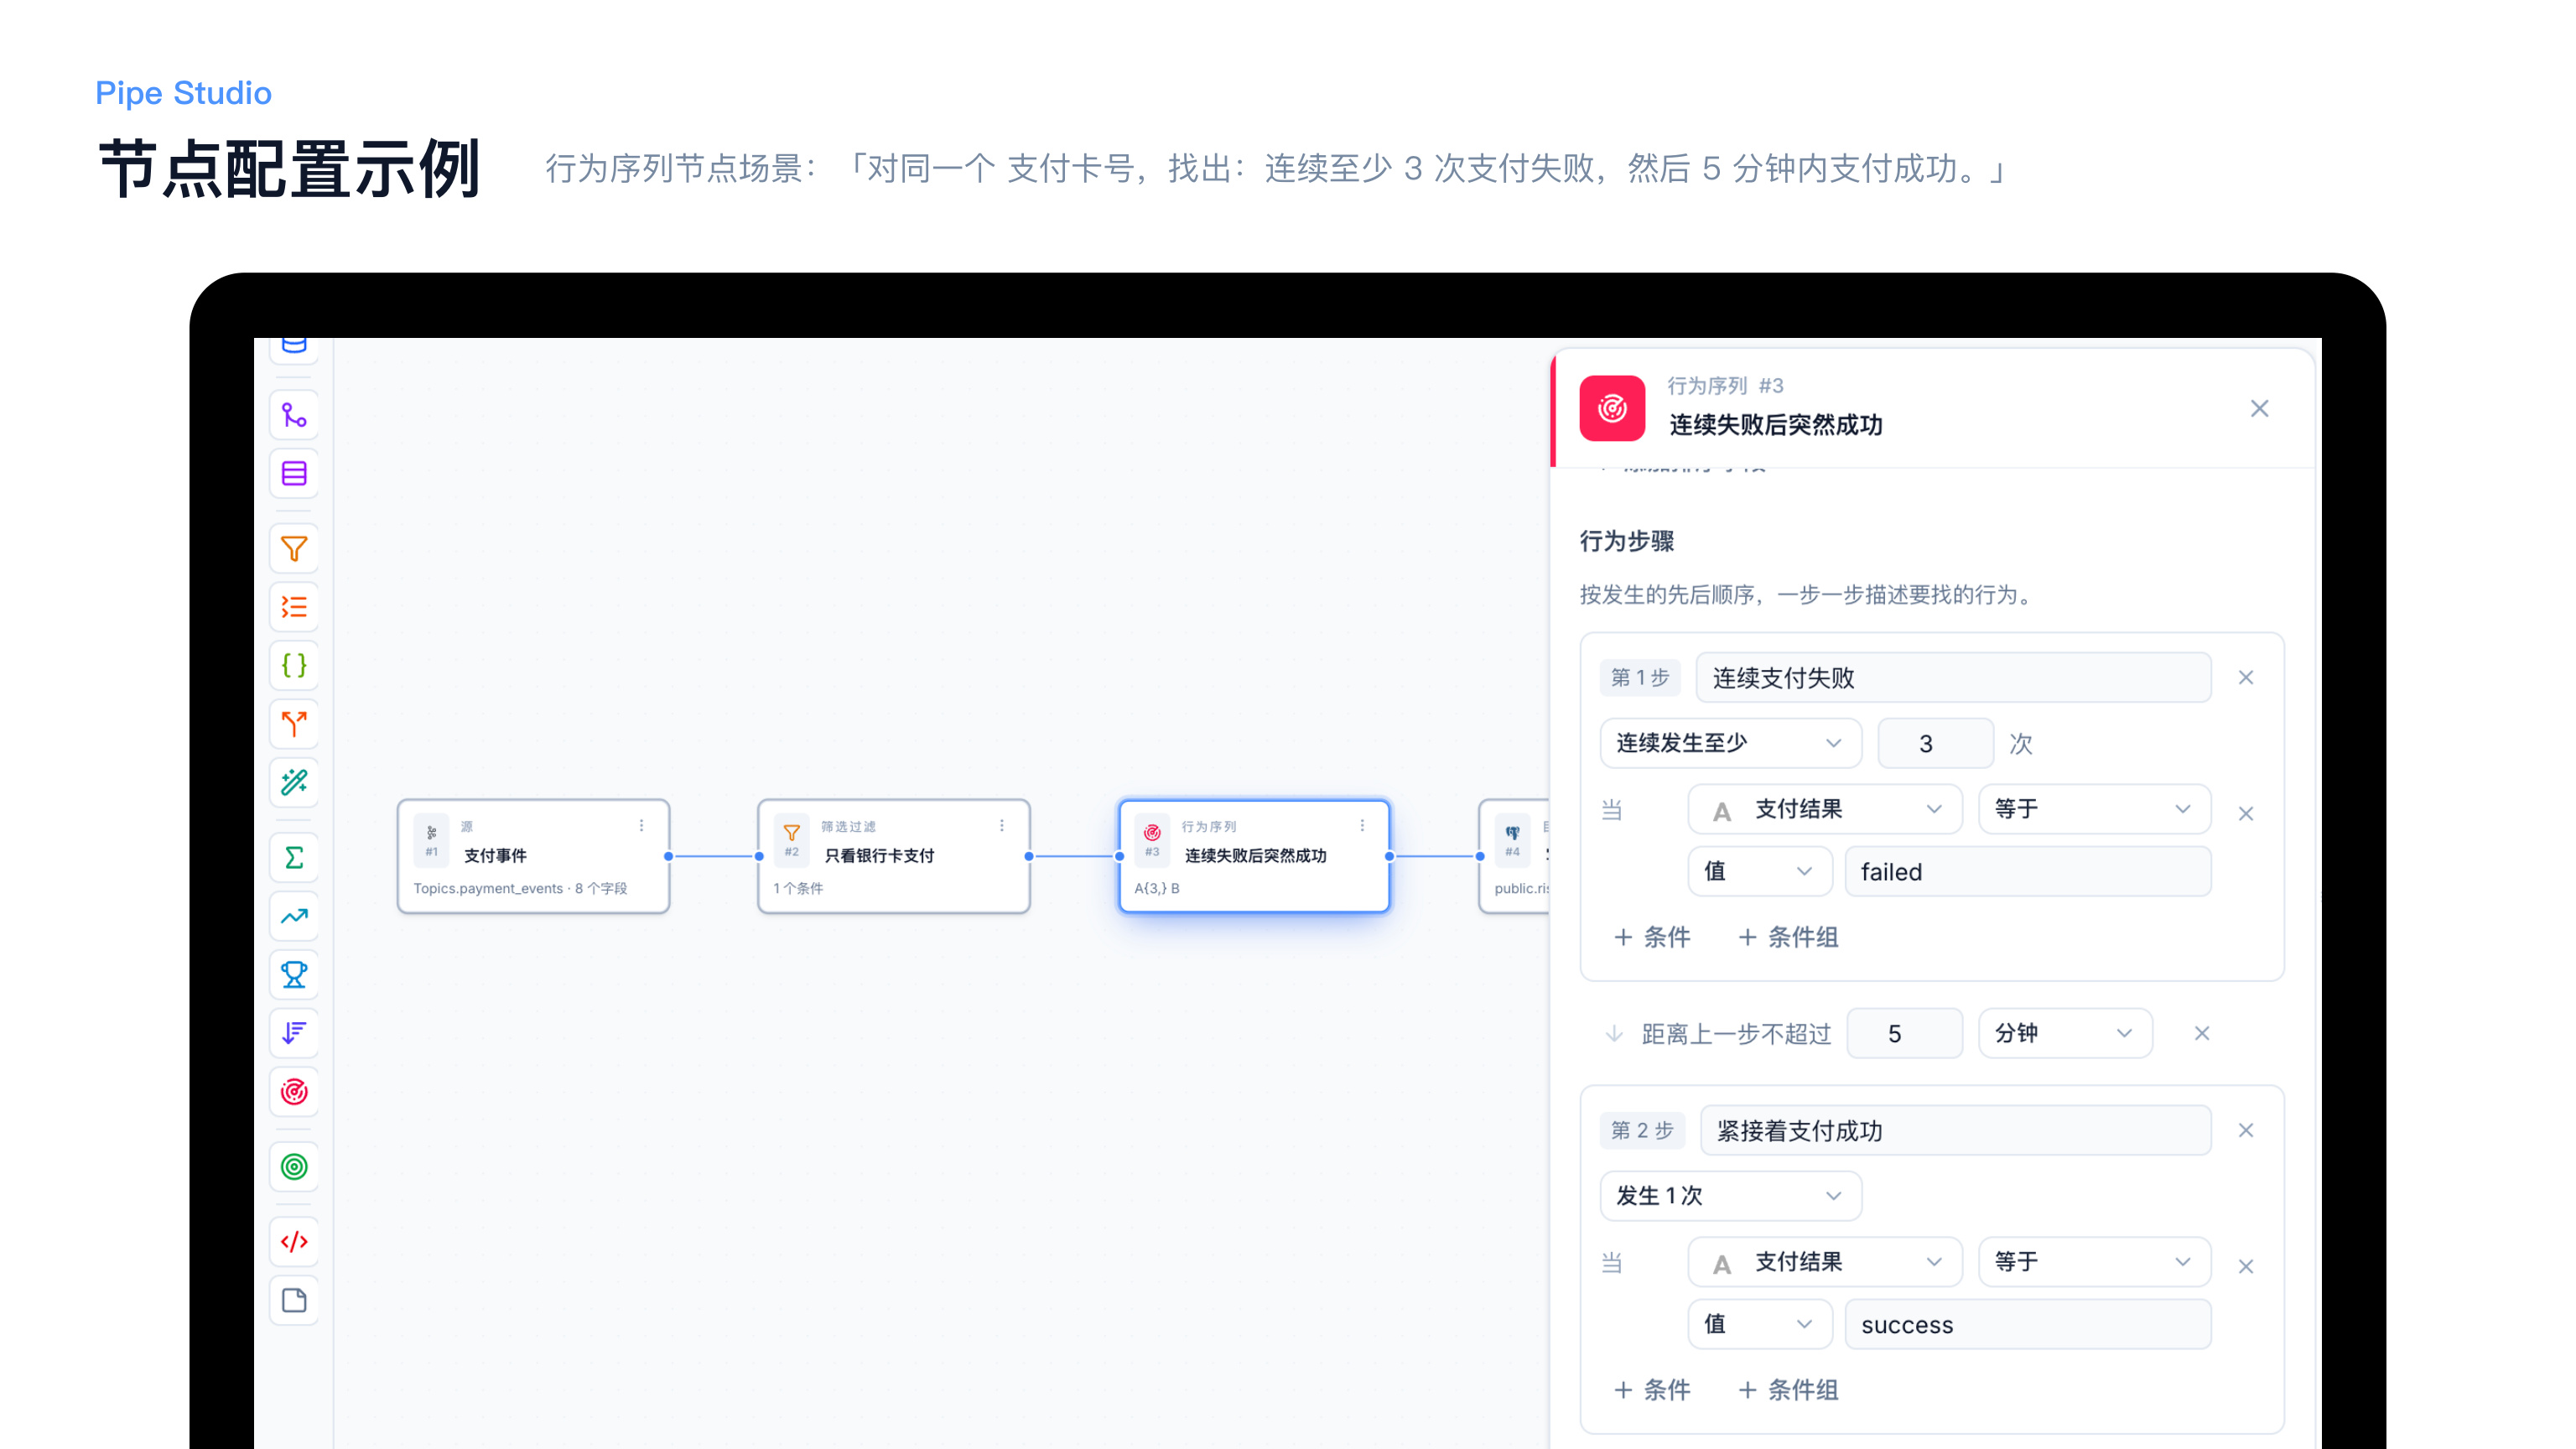
- 节点示例字段加工使用表达式编辑器;行为序列示例为「对同一个支付卡号,找出连续至少 3 次支付失败,然后 5 分钟内支付成功」。
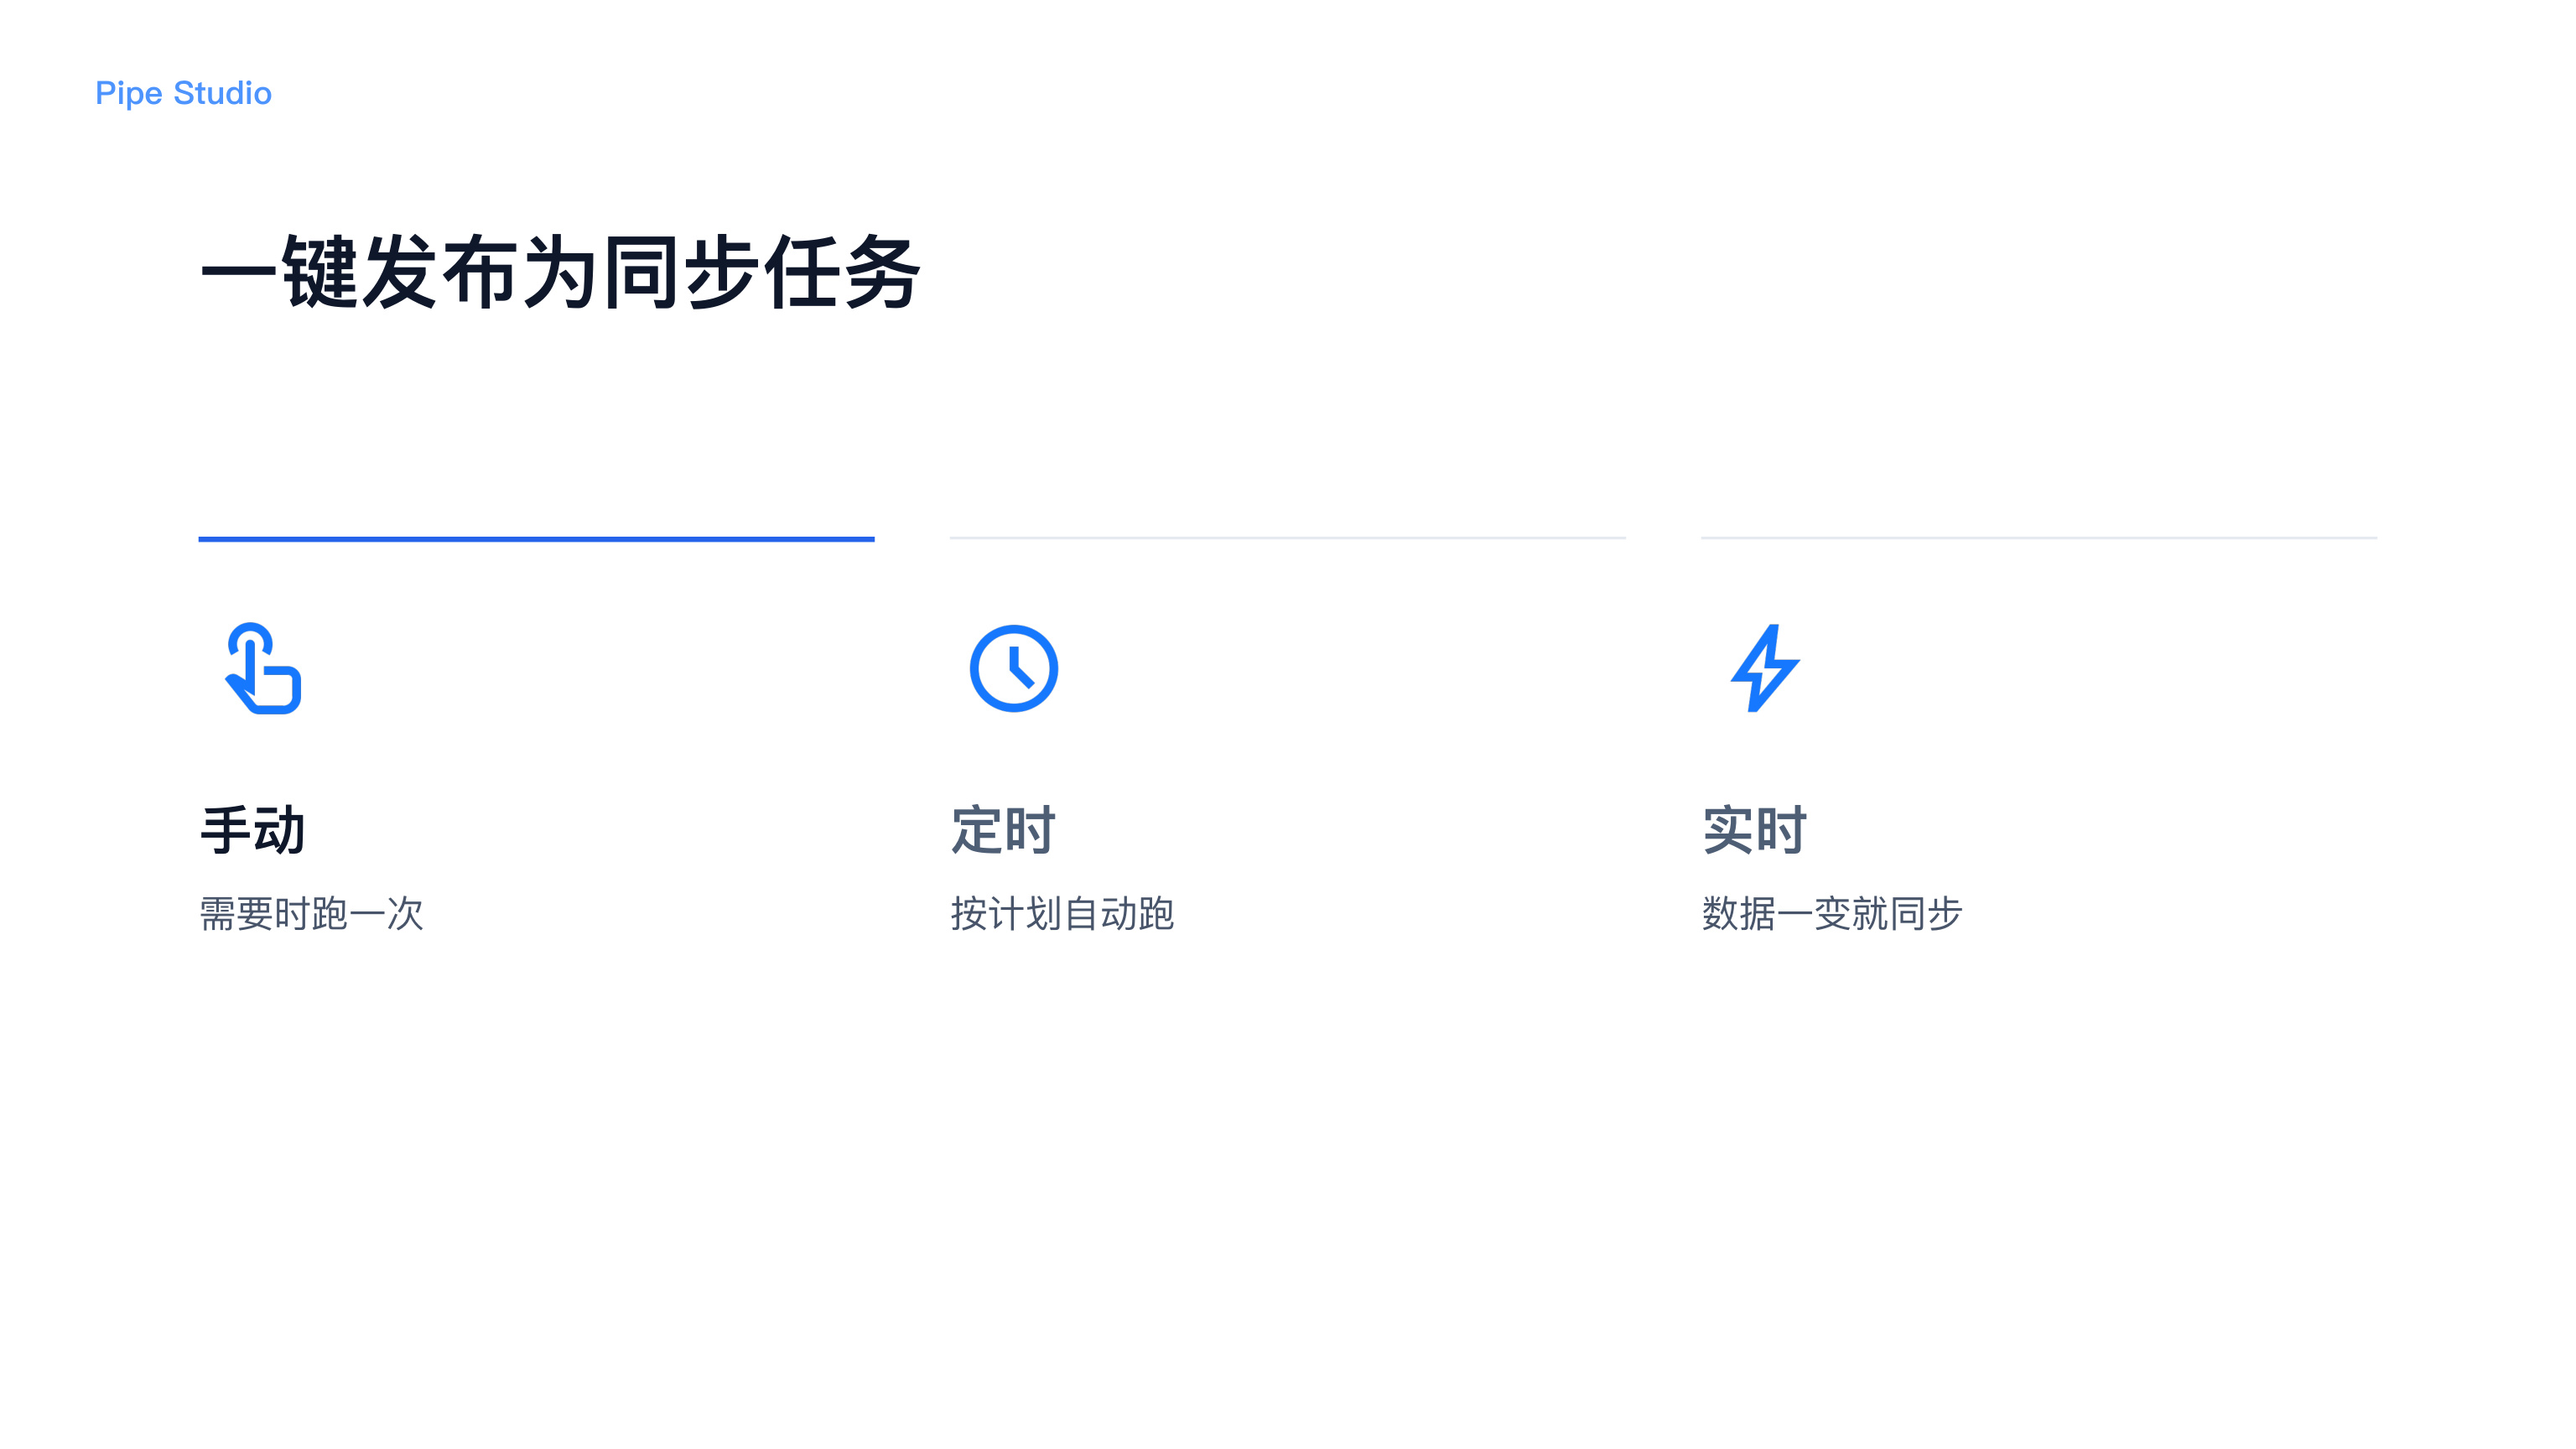
- 任务发布手动(需要时跑一次)、定时(按计划自动跑)、实时(数据一变就同步)。上述为产品能力说明,不是某一客户同步量统计。
演讲资料
演讲视频
演讲文字整理稿
产品开篇
资料封面为 MPC 2026、HDP V3.0「看懂数据,让数据流动」,讲者署名为田然、明道云首席架构师。随后进入 API 数据源。
四步接入 API 数据源
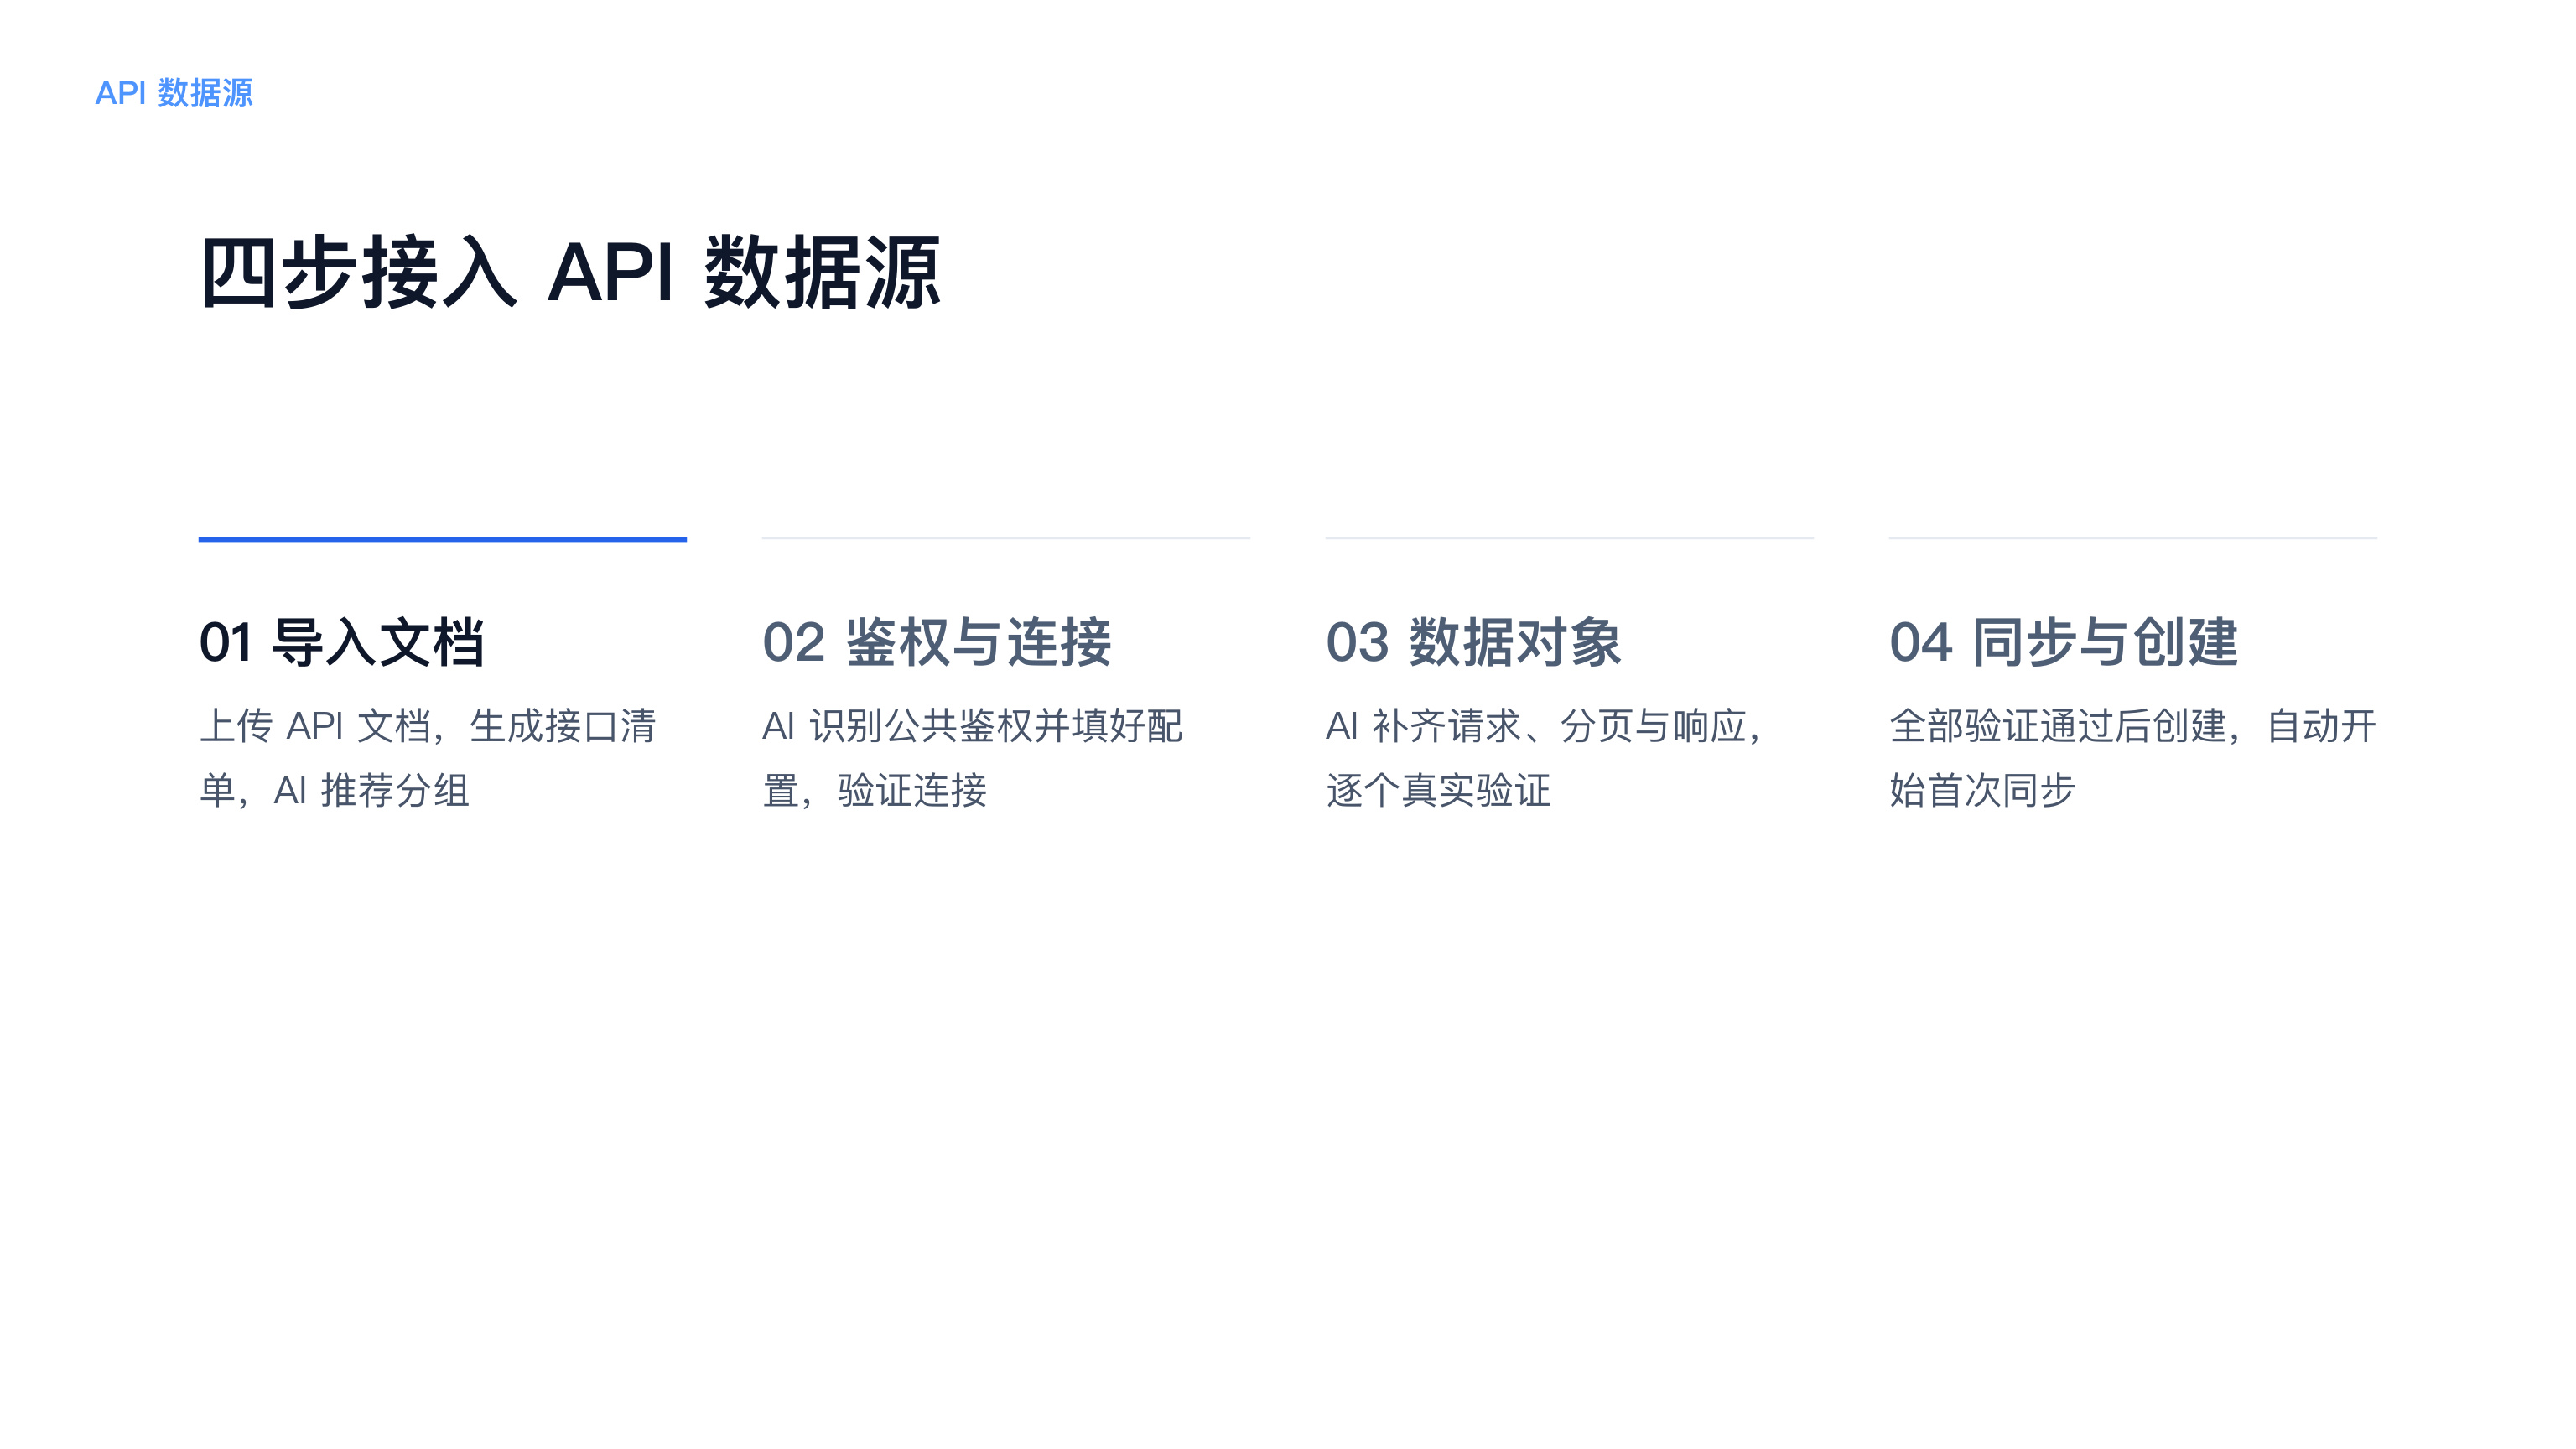
接入分成四步。第一步导入文档:上传 API 文档,生成接口清单,并由 AI 推荐分组。第二步鉴权与连接:AI 识别公共鉴权并填好配置,再验证连接。第三步数据对象:AI 补齐请求、分页与响应,逐个做真实验证。第四步同步与创建:全部验证通过后创建,并自动开始首次同步。四步把“能连上”和“能同步”分开,未验证通过不进入创建。
文档解析、鉴权与接口关系
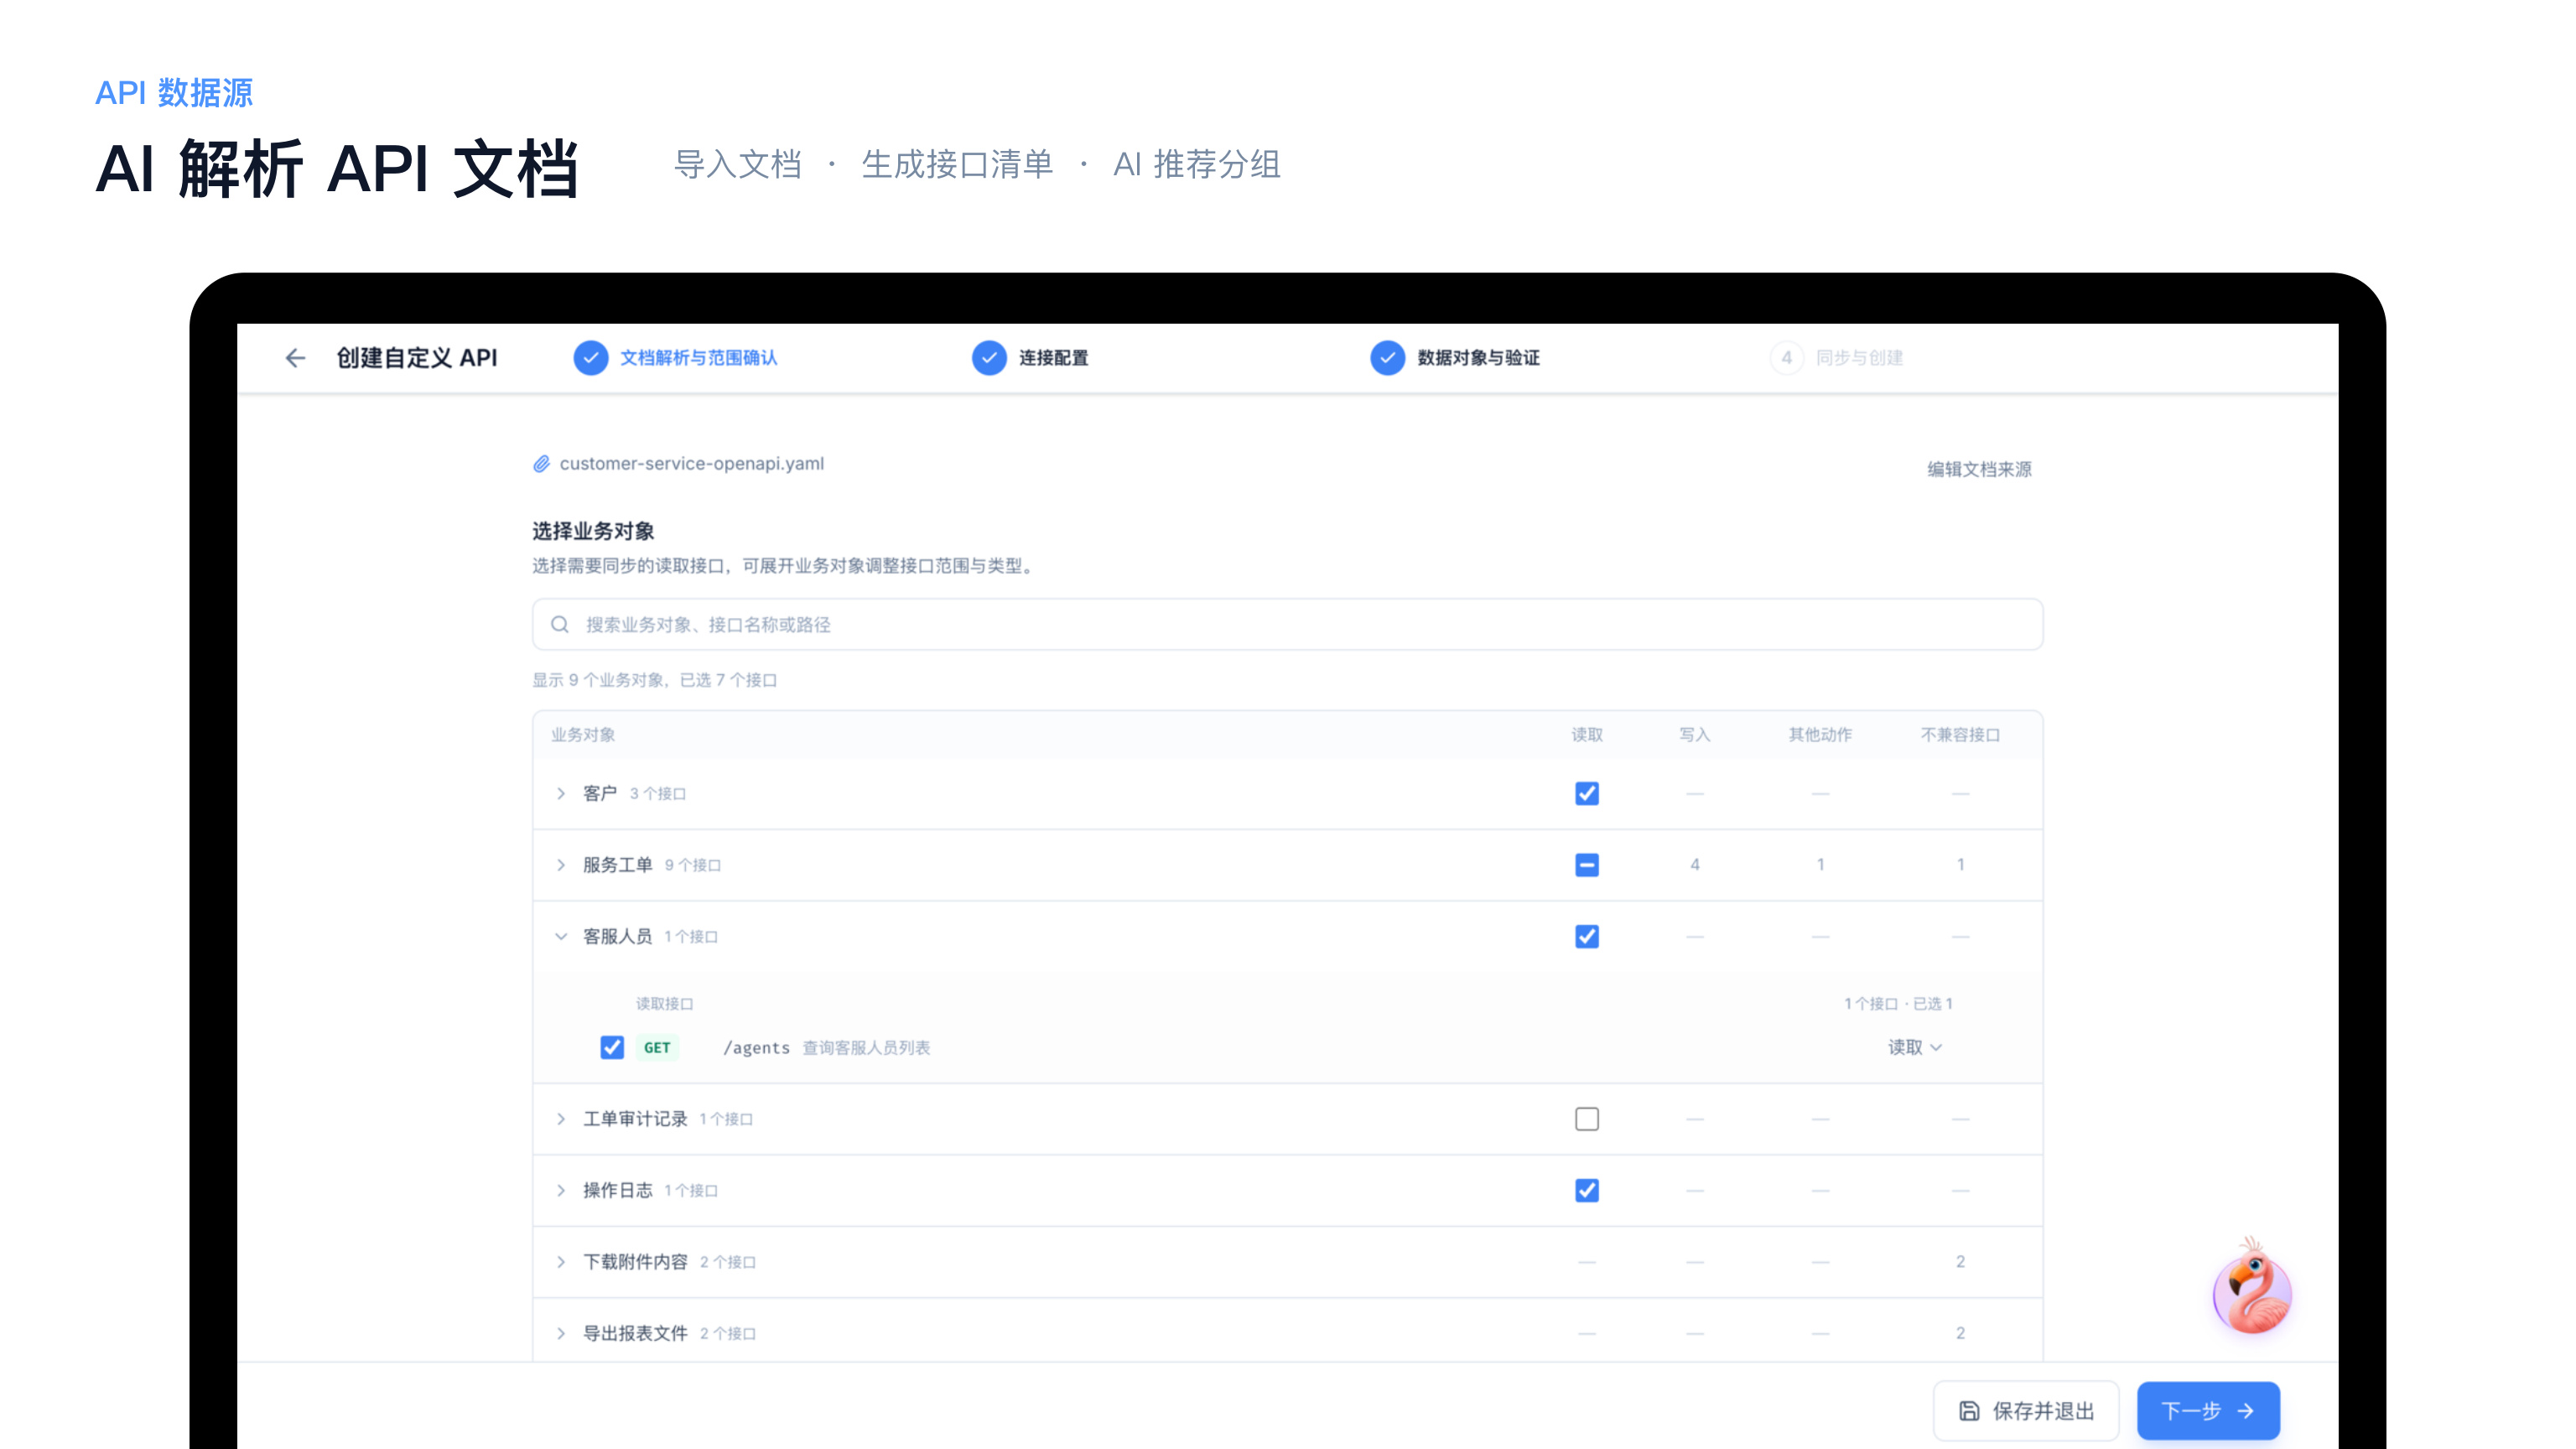
后续页分别展开:导入文档后生成接口清单并推荐分组;鉴权自动识别公共配置并用真实请求验证连接;接口配置补齐请求、分页与响应,分析接口依赖,再逐个真实验证。依赖分析用于处理接口之间的调用顺序,不代替对返回数据业务含义的确认。
Data Explorer 五项能力
数据源浏览器(Data Explorer)给出五项核心能力:关联记录可顺着关联追查;ER 关系图展示表间关系;结构语义化把字段换成业务语言;AI 查询在 SQL 出错时自动修复;AI 图表支持一句话生成和修改。资料将“看懂数据”落实为查关系、用业务语言理解字段、以及用 AI 辅助查询和出图。
直连查看与多层下钻
数据查看强调直连数据库、自由筛选和数据分布预览。关联记录多层下钻使用详情面板查看子表与父表记录,并用面包屑跳回。连续多页重复同一组要点,用于演示下钻路径,并不额外增加新的统计指标。
ER 图、语义化与修 SQL
ER 关系图自动生成表间关系,标出关联字段与对应关系,并在问答时高亮。结构语义化提供中文友好名称、业务说明,并识别表间关系。AI 查询给出查询计划,生成并执行 SQL,出错可一键修复。修复是查询辅助,执行结果仍取决于源库权限与语句是否符合口径。
AI 图表发布到 HAP
AI 图表页写明一句话生成和修改图表,并可一键发布到 HAP 页面。发布对象是 HAP 页面上的图表,不是自动改写源系统报表权限。
Pipe Studio:画布与口径
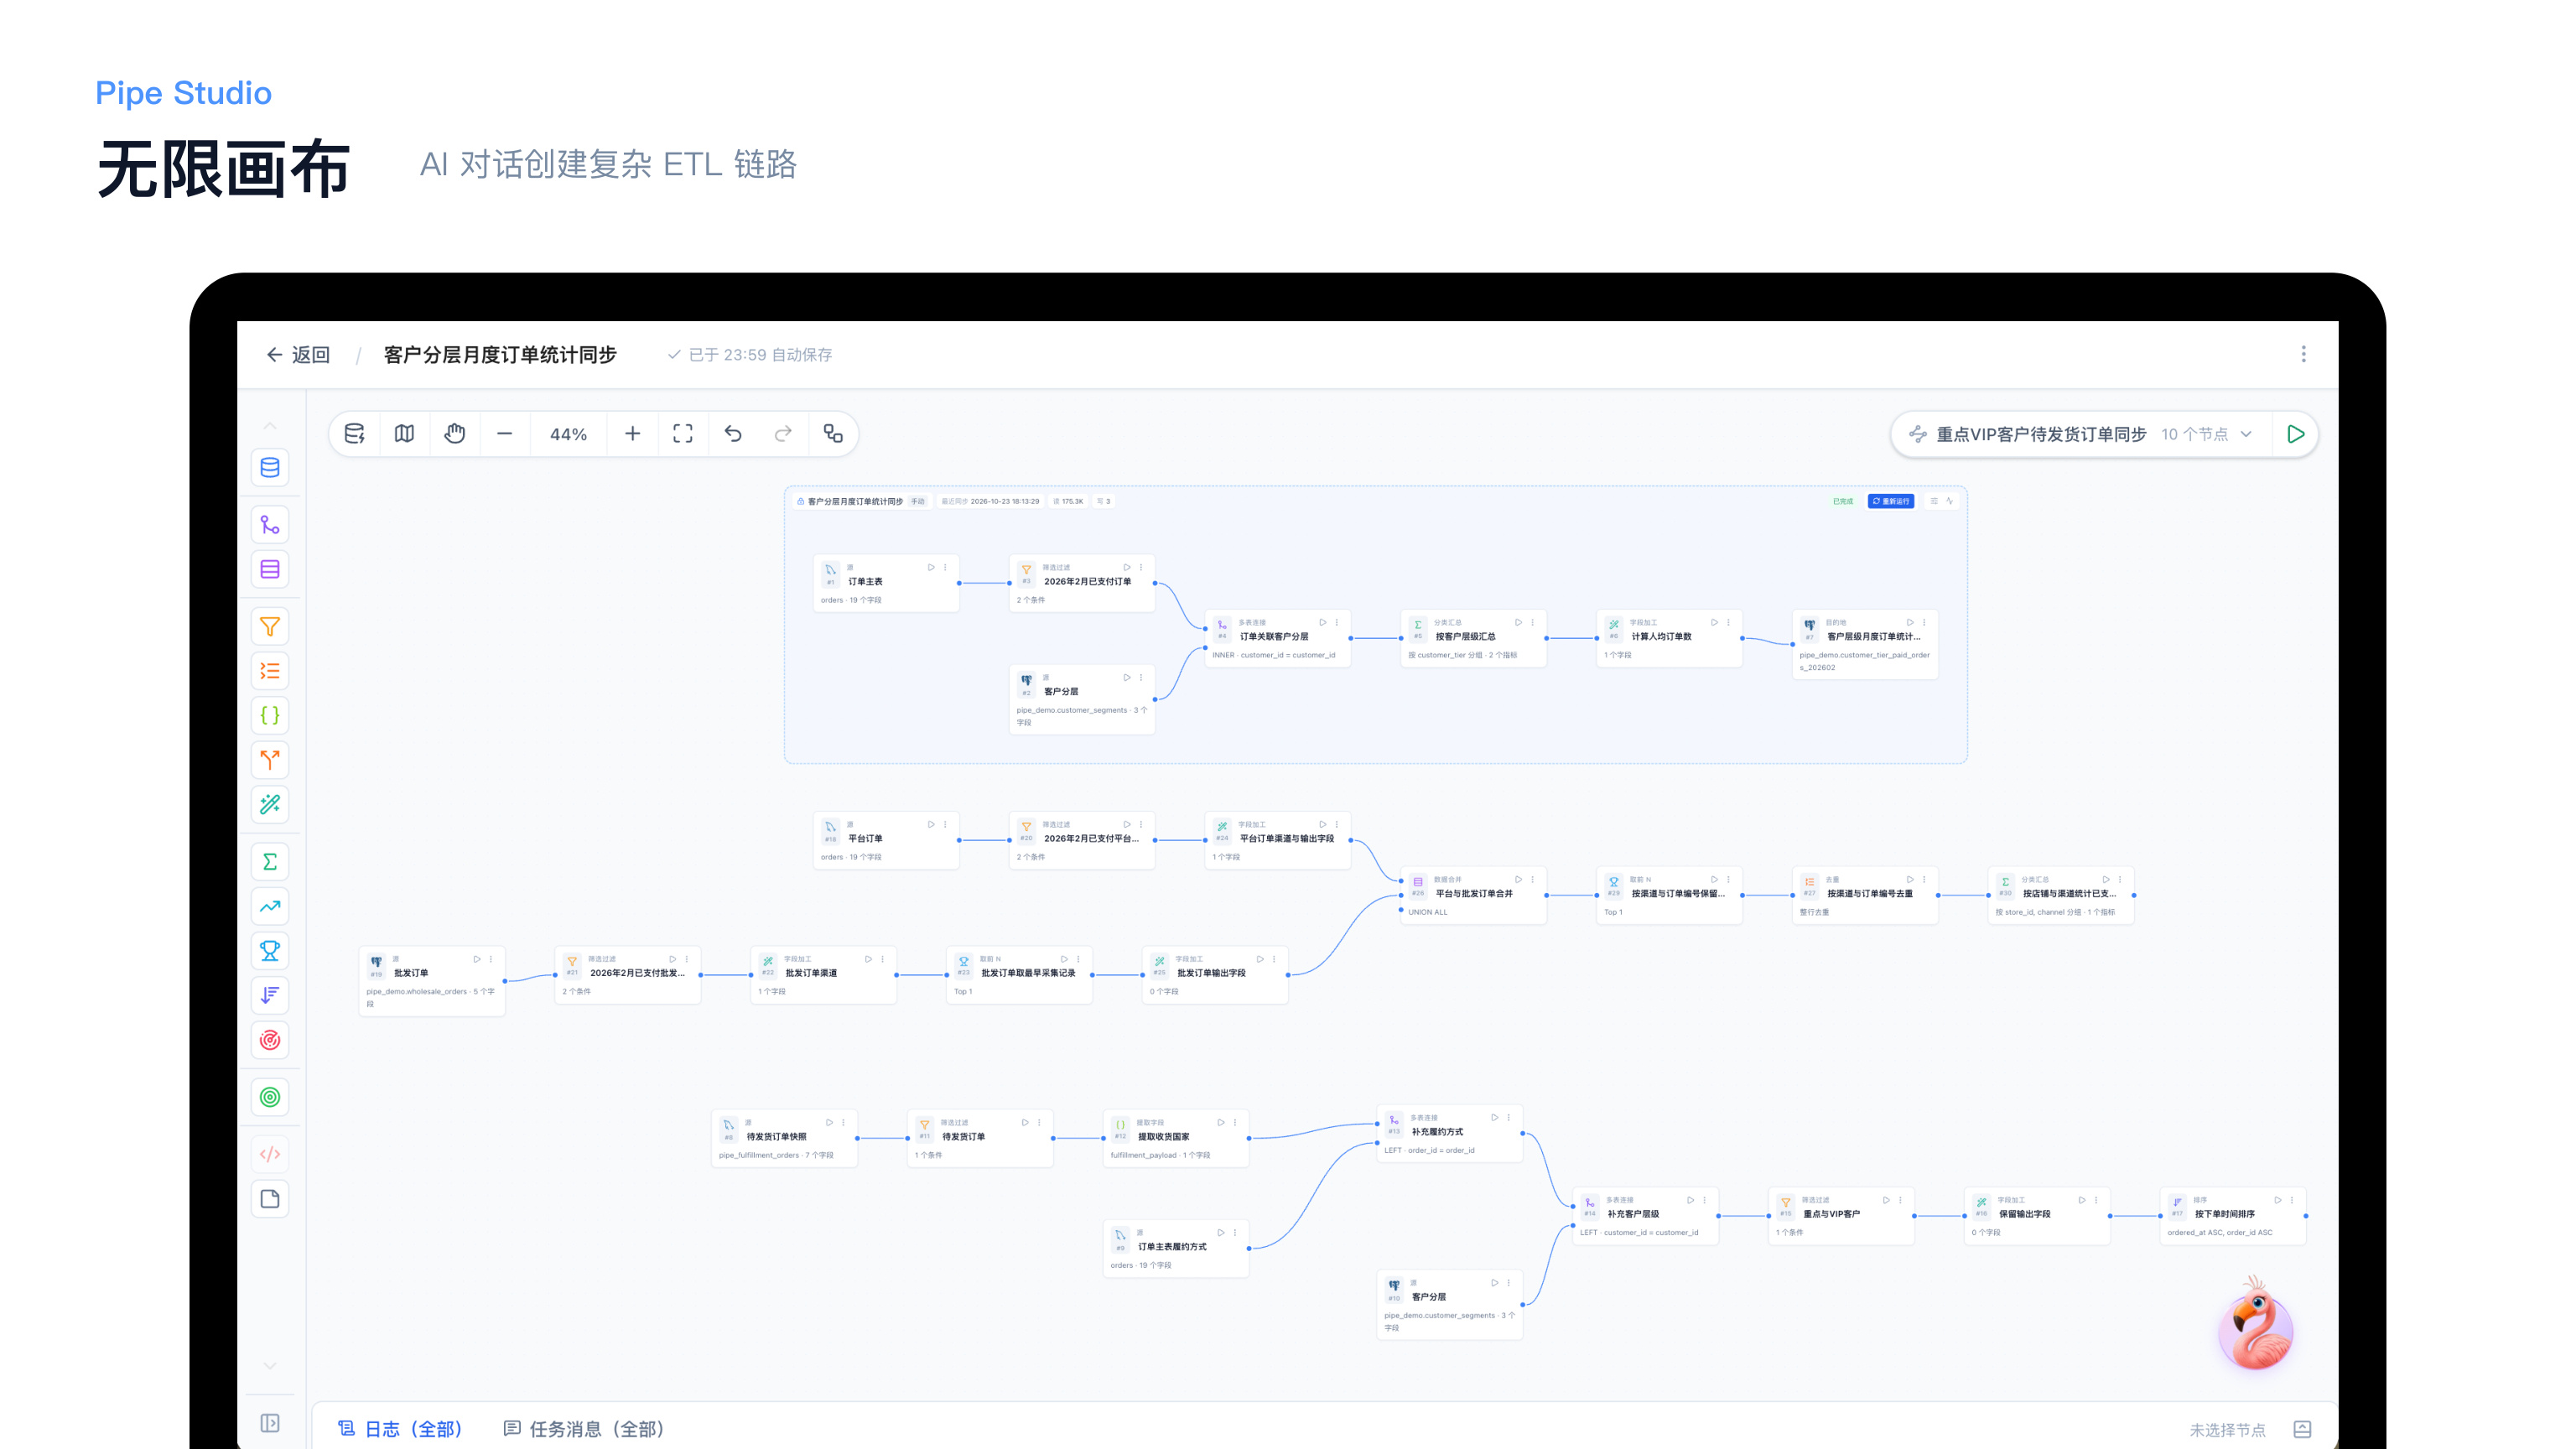
Pipe Studio 以无限画布承载 AI 对话创建的复杂 ETL 链路。业务口径澄清页说明:有歧义的口径会逐题确认,给出推荐项,也可以自行填写。口径确认被放在画布建链之前或同时,避免未定义指标直接写入下游。
16 种节点与配置示例
节点清单覆盖取数、关联、加工、分析、写入:源、多表连接、数据合并、筛选过滤、去重、提取字段、字段展开、字段加工、分类汇总、窗口计算、取前 N、排序、行为序列、目的地、脚本、备注。字段加工节点以表达式编辑器为例。行为序列节点的场景示例是:对同一个支付卡号,找出连续至少 3 次支付失败,然后 5 分钟内支付成功。该示例用于说明节点能表达的时序条件,不是某家支付机构的真实风控报告。
发布为同步任务
最后一页将链路一键发布为同步任务,三种运行方式为:手动,需要时跑一次;定时,按计划自动跑;实时,数据一变就同步。运行方式是产品选项,具体采用哪一种由任务配置决定。
HDP V3.0 想先解决数据的哪一类问题?
根据田然这场的公开幻灯片,顺序是先把 API 变成可验证、可同步的数据源,再在浏览器里看清表关系和数据,最后用管道把加工结果按任务跑起来。标题里的“看懂”和“流动”对应 Explorer 与 Pipe Studio,而不是只提供一个只读查询框。
API 接入为什么要四步,而不是导入后立刻同步?
根据资料,导入只生成清单和分组;连接要经过鉴权识别和真实请求;每个数据对象还要补齐分页与响应并验证;全部通过才创建并做首次同步。步骤用来降低把未验证接口直接写入下游的风险。
Data Explorer 里 AI 查询和 AI 图表各做什么?
根据资料,AI 查询负责生成并执行 SQL,出错时修复;AI 图表负责用自然语言生成或修改图,并可发布到 HAP 页面。前者对着源数据提问,后者把结果变成可放进页面的可视化,两者都不能替代源系统里的权限设置。
业务口径不清楚时,管道怎么处理?
根据资料,Pipe Studio 会把有歧义的口径拆成问题,给出推荐项,也允许自行填写。口径确认之后,再用 16 种节点在画布上完成取数、加工和写入。
16 种节点是否意味着任意复杂规则都能自动生成?
根据资料,节点覆盖常见取数、关联、过滤、汇总和写入,并可用脚本、表达式和行为序列表达更细的条件。能力清单说明平台提供这些积木;具体链路仍要按业务规则配置和验证,不能把节点种类直接写成已经替企业完成全部 ETL。