CygnusX BioOps:让生命科学计算形成可回查、可复现的交付。
内容摘要
CygnusX BioOps 面向生命科学研究中跨步骤、跨工具和长周期的计算任务,强调受控计算与可信交付。平台将科学问题拆解、标准分析、Agent 编排和证据归档连接起来,以领域技能与标准管线承担确定性计算,并保存项目上下文、环境、参数、版本和结果,支持后续回查与复现。路演将通用 Agent 的灵活探索与标准计算职责分开,同时展示任务提交、运行监控和报告查看等使用环节。现阶段重点是形成可核验的科研流程,垂直领域模型训练则属于后续探索方向。
关键事实
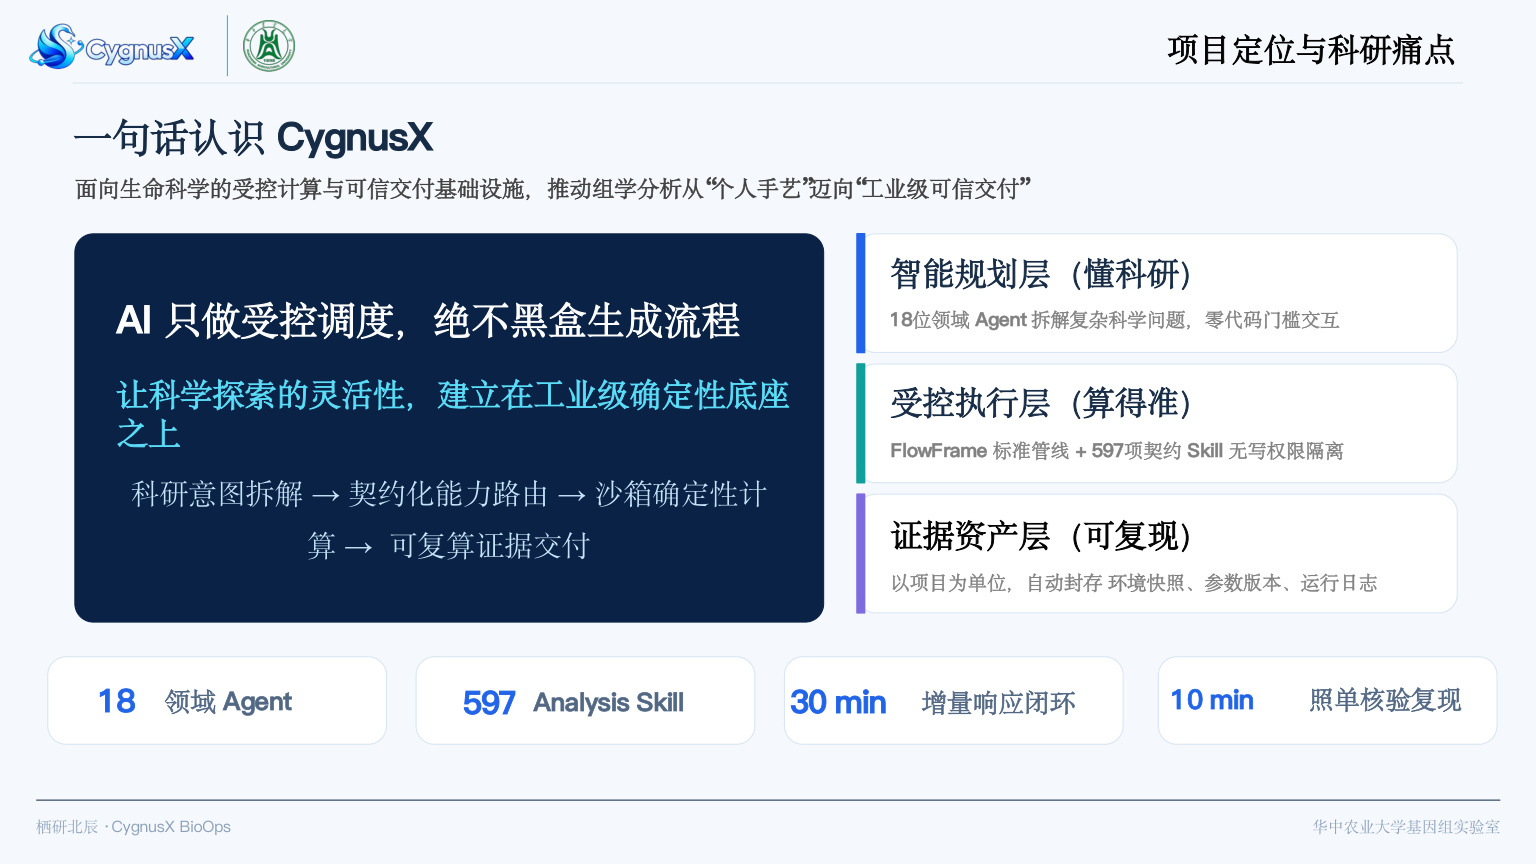
- 平台结构智能规划、受控执行与证据资产相结合,现场介绍18位领域Agent和597项生命科学分析Skill。
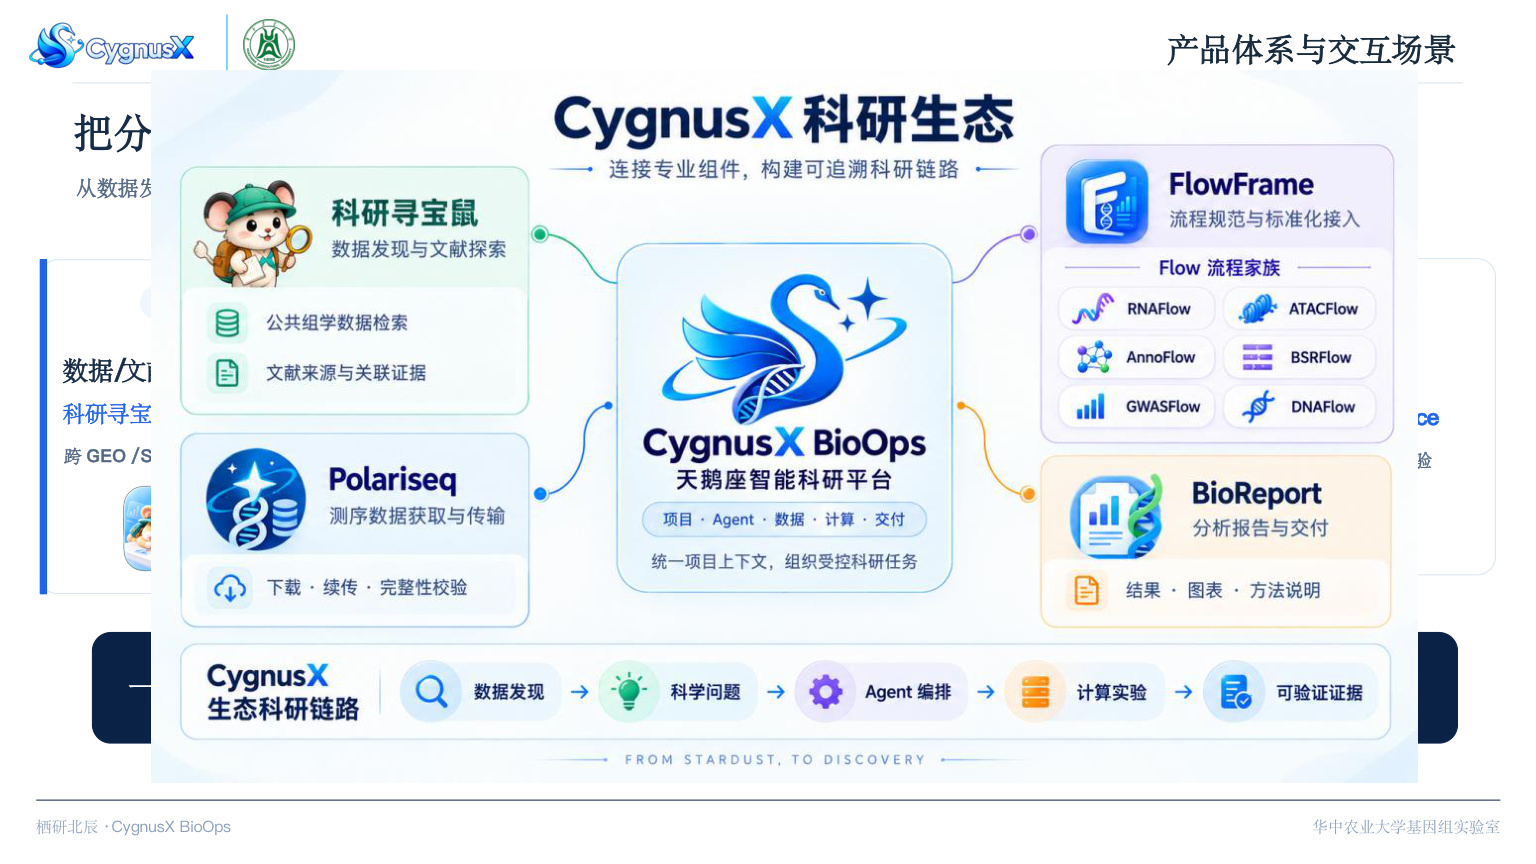
- 标准管线现场PPT标明FlowFrame框架,配合数据发现、获取、任务编排及报告归档。
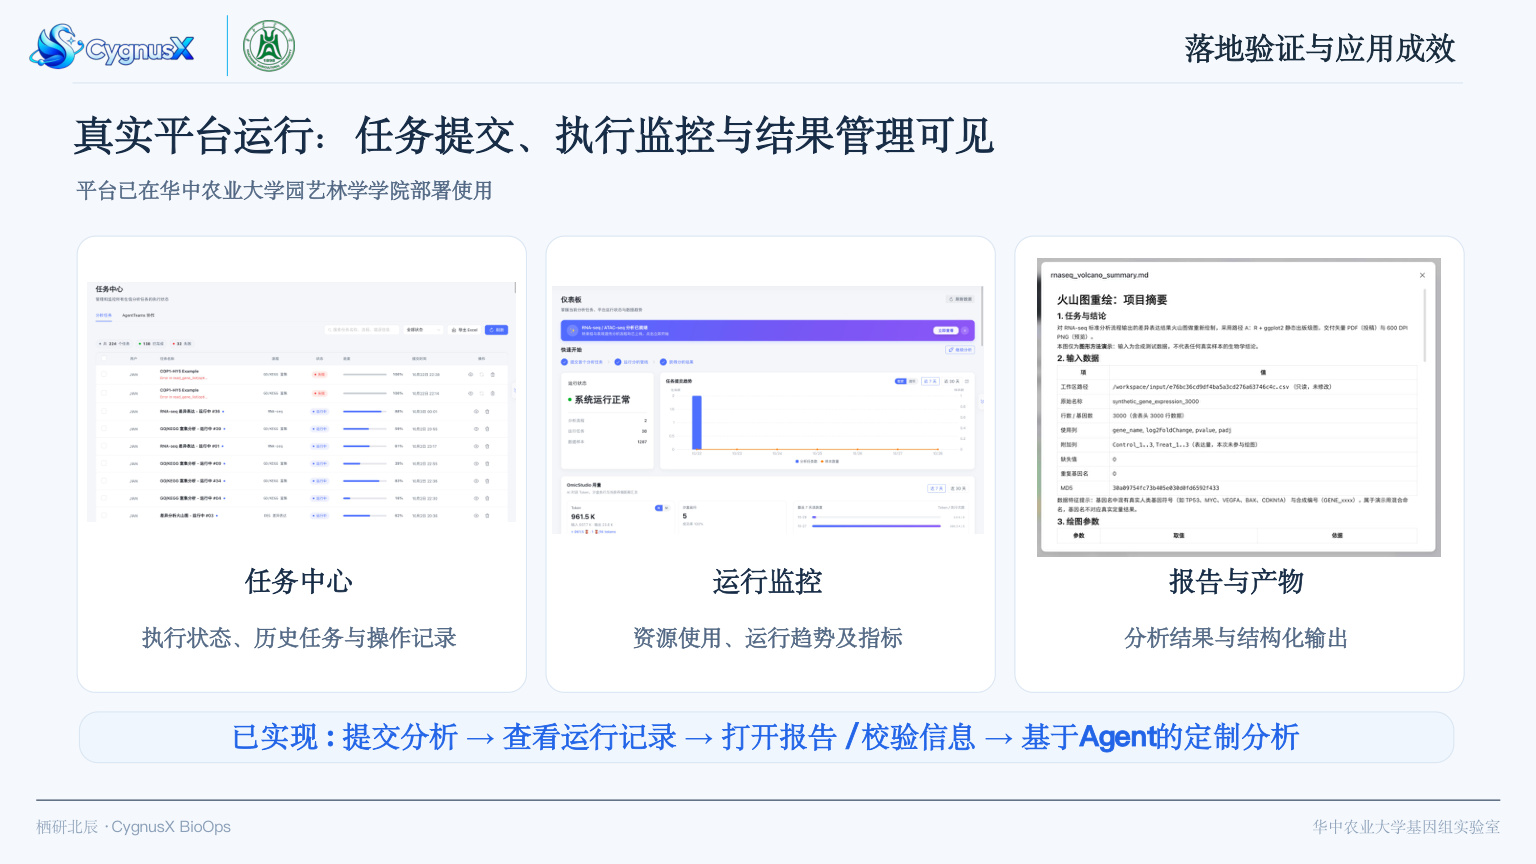
- 部署披露张建介绍平台已在华中农业大学园艺相关实验室部署,展示任务提交、运行状态及报告查看。
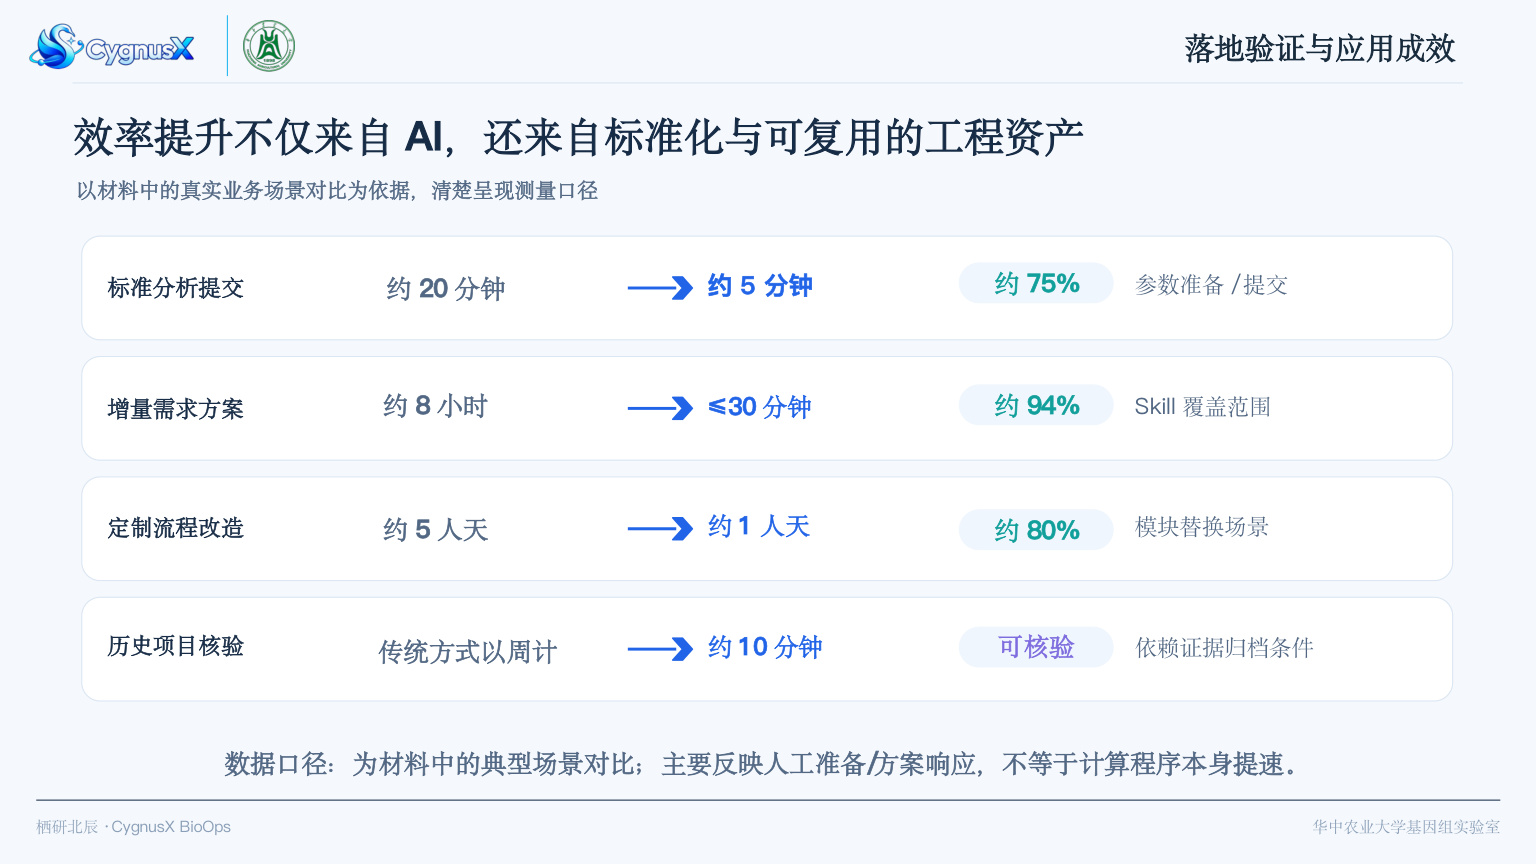
- 效率口径现场材料将标准分析提交、增量方案与定制流程作为对比对象,反映人工准备和方案响应,不等于计算程序本身提速。
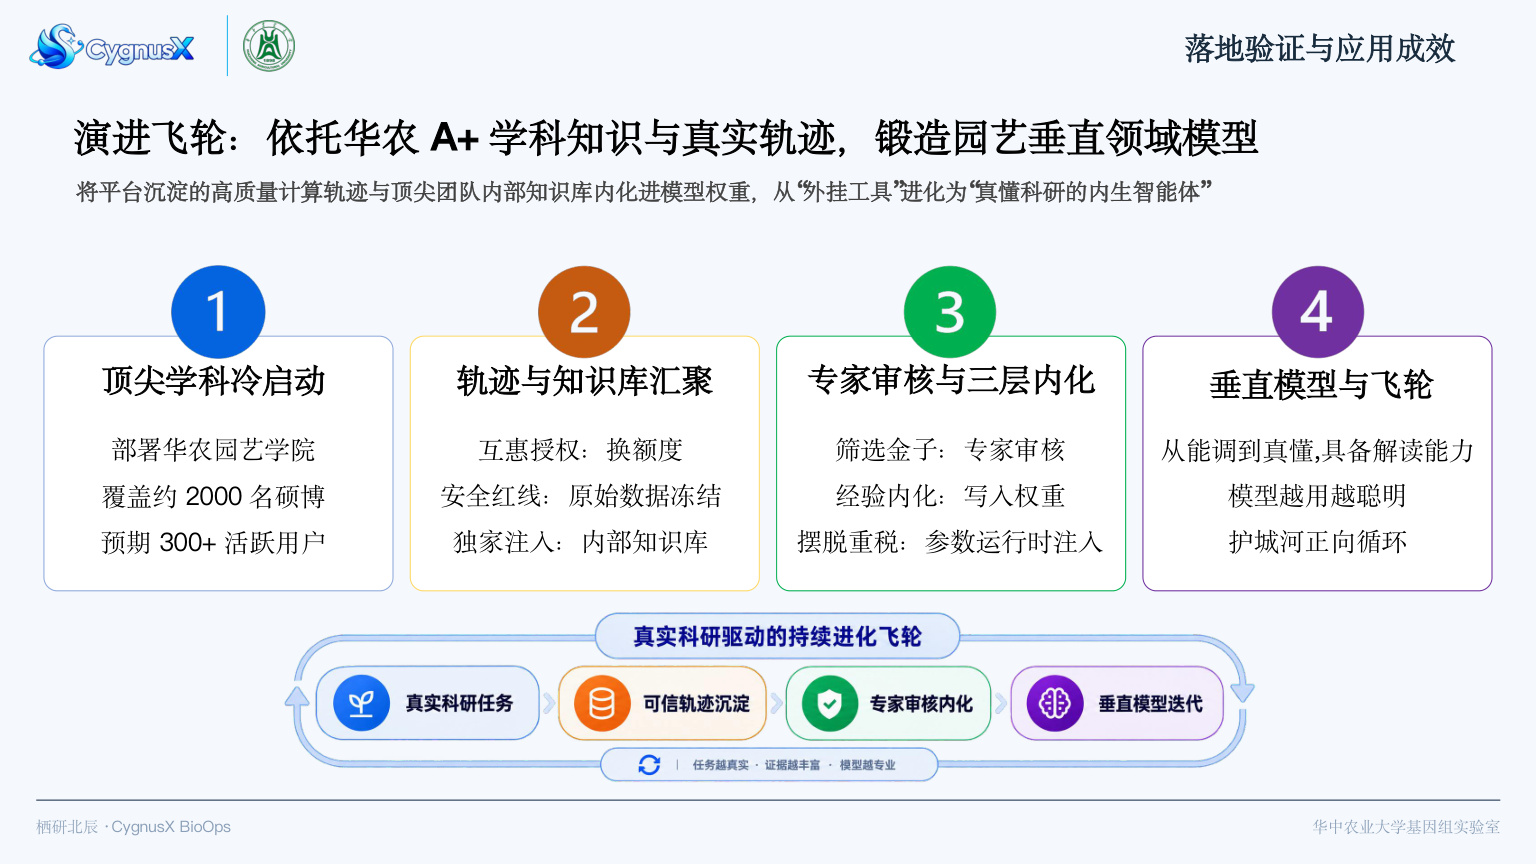
- 后续方向在平台使用中沉淀高质量数据,结合园艺等学科探索训练垂直领域模型。
演讲资料
演讲视频
生命科学任务对可信计算的要求
大家好,今天我介绍我们团队做的一个项目。我们的项目和上面的同行不一样,主要面向科研领域,就是生命科学,同时面向农业和医学研发领域。目标是做一个面向生命科学领域的受控计算实验与可信交付基础设施。
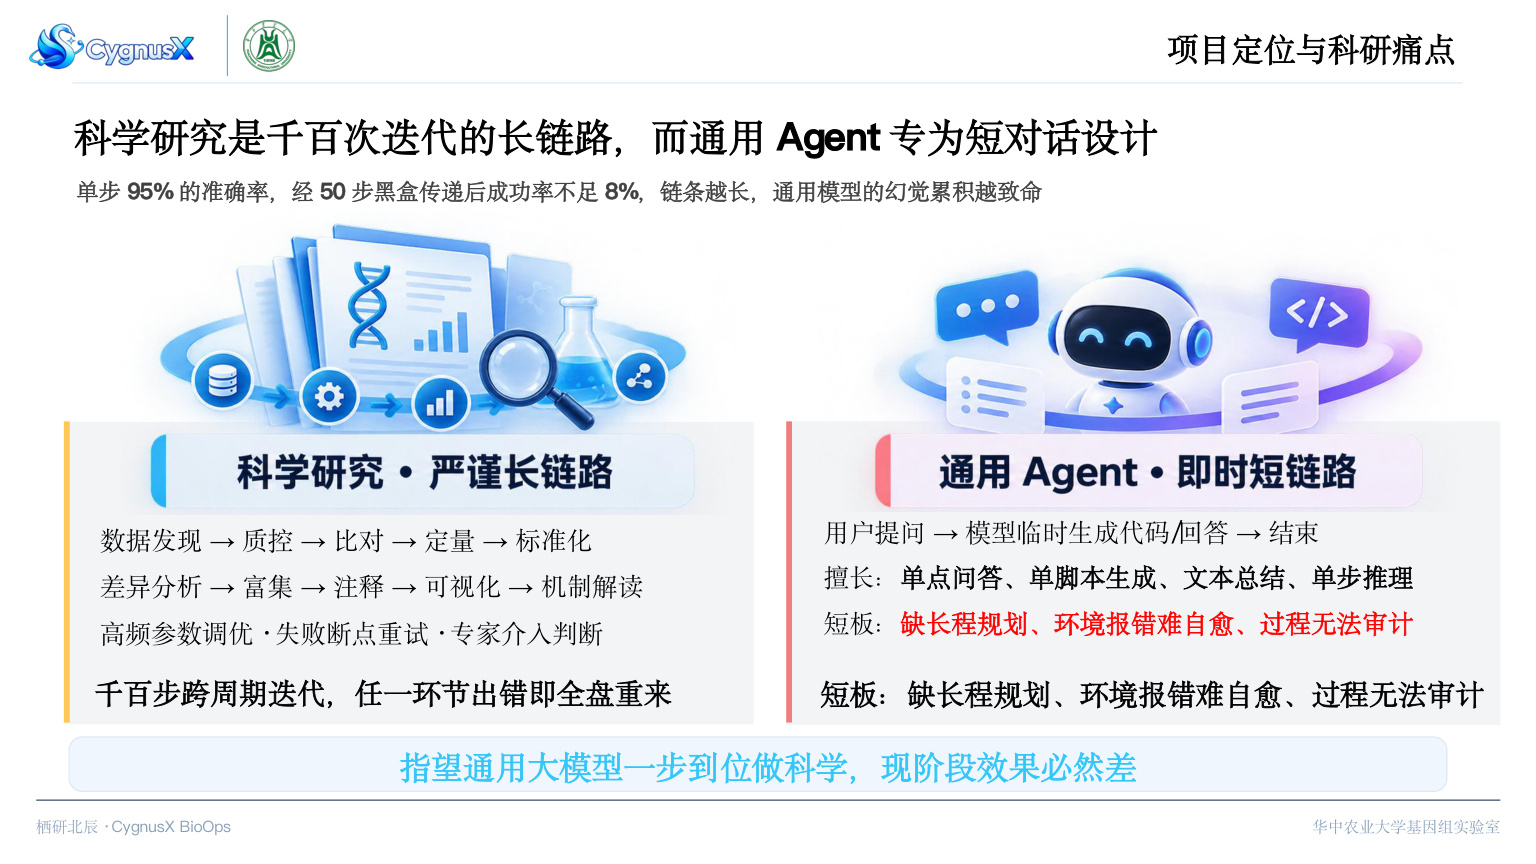
这个 PPT 可能有点晚了,其实是新的 PPT。不知道大家有没有用通用 Agent,比如 Kimi、豆包,它现阶段已经进入生命科学领域了。但是对于涉及上千步、甚至横跨数年的项目,通用 Agent 缺乏长期规划能力,重要节点出问题会导致环境报错。现阶段还有个最大问题:结果无法复现,不能保证结果可复现、可信。所以指望通用大模型或通用 Agent 一步做到生命科学领域,现阶段结果并不会很好。
长链路、上下文与试错成本
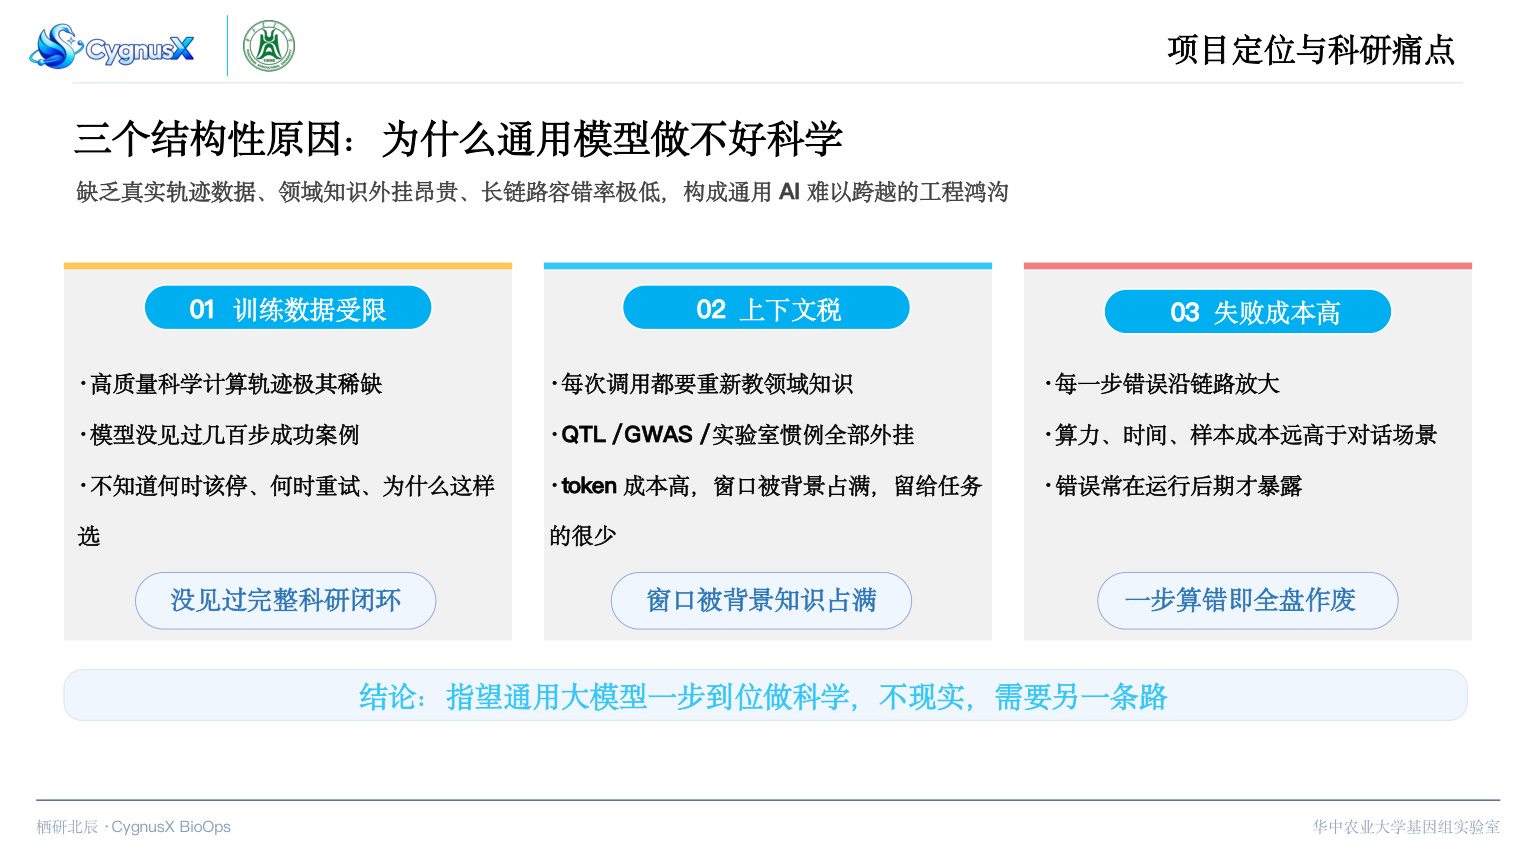
通用 Agent 使用的底层模型,由于预训练数据的原因,像 Kimi、千问,很缺少高质量生命科学领域的研究实例,这些数据很稀缺。生命科学涉及上千步骤,可能有文献搜索、找很多数据、做很多分析,有很严重的上下文问题,会导致重要结果在上下文里被稀释,注意力被稀释。
还有一个问题,生命科学领域的材料,比计算成本和 Token 消耗贵得多。一旦通用 Agent 某一步出问题,算力、时间和样本成本远高于用通用 Agent 的成本。
规划、受控执行与证据归档
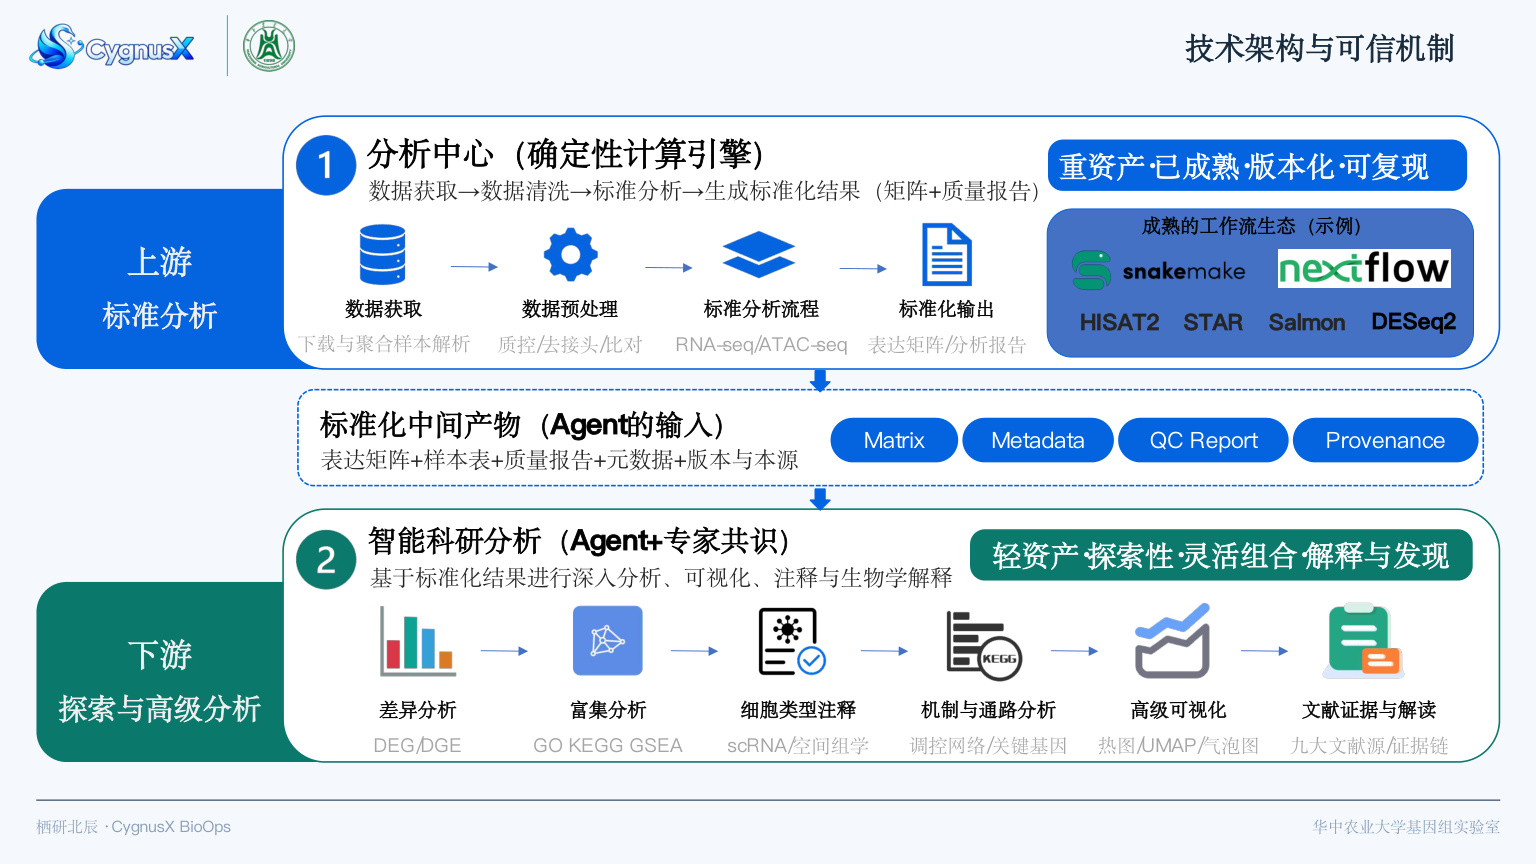
平台主要通过三个框架解决问题。智能规划层,通过18位领域 Agent 拆解复杂科学问题。通过自研 FlowFrame 标准框架和实验室沉淀的597项生命科学领域 Skill,解决算得准的问题。同时用自研 BioReporter 框架,把环境快照、参数自动封存,解决可复现的问题。现阶段主要基于现有大模型,解决算得准和可复现。
从数据发现到项目报告
这个是旧的 PPT。现阶段我们已搭好链路。生命科学领域一般需要找文献、找公共数据,下载数据后分析。如果用 Kimi、豆包,参数或者软件版本错误,就会导致前面几乎重推。我们通过专家审核的 FlowFrame 框架,提供可追溯、可复现的标准分析。
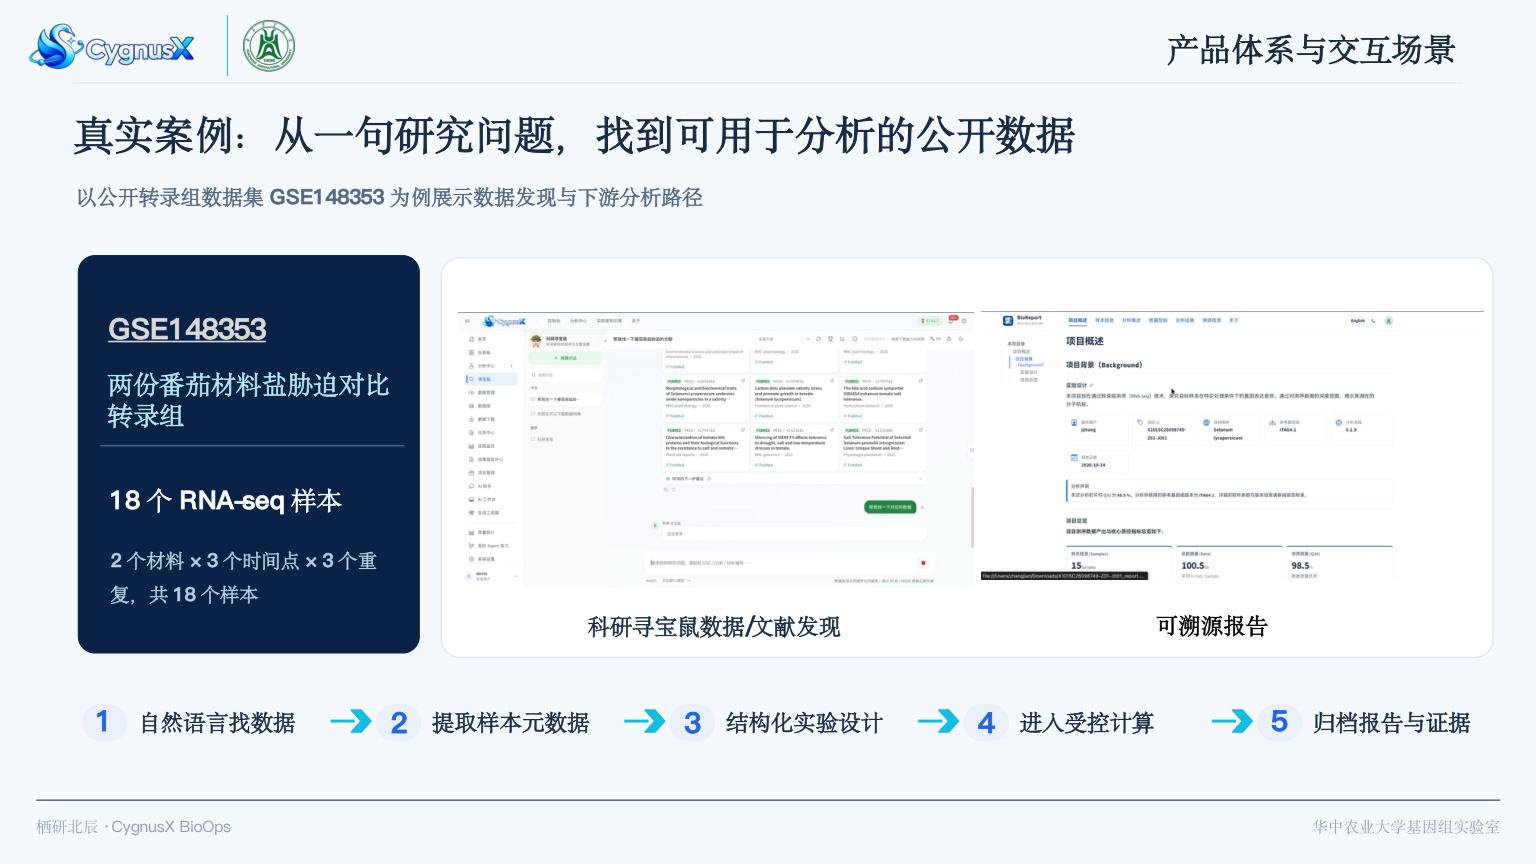
比如寻宝鼠、数据下载和标准分析,都在 Agent 平台下。平台会进行编排,一步步怎么来。最后用 BioReporter 对上下文、样本信息、标准管线、参数和版本,以及智能编排如何排布,沉淀报告,汇总后交给用户。这样把用户提出的科研问题,转换成一份可追溯、可复现的项目报告。
用户入口与确定性计算
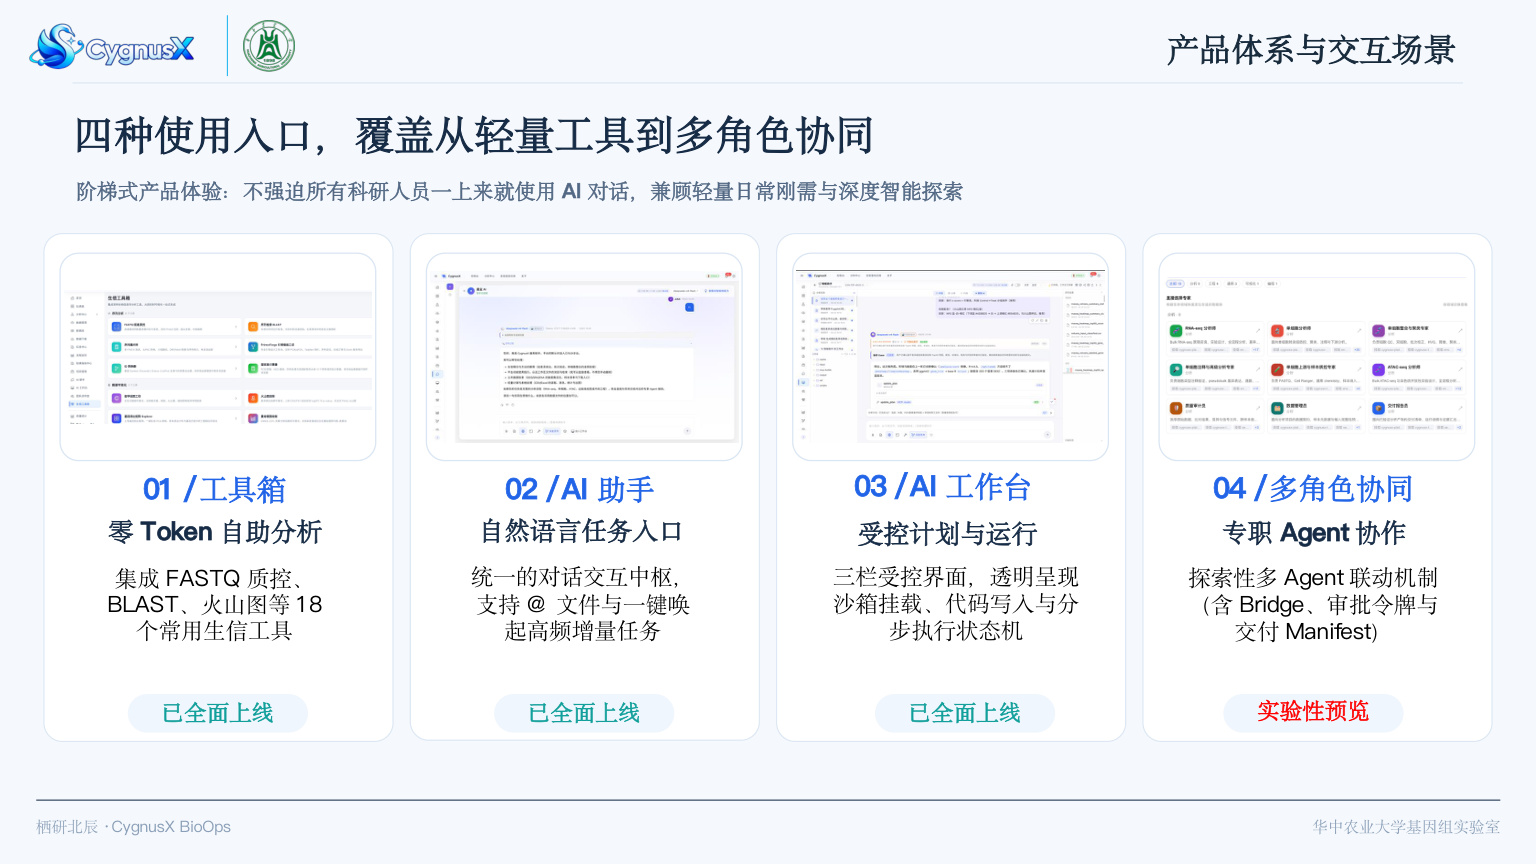
基于平台,我们已构建出生态,实现从数据发现、科学问题解释、Agent 编排、计算实验到可验证证据的完整链路。我们提供四种使用方式:零 Token 消耗的生信工具箱,像 Kimi 一样常见的 AI 交互助手,比较灵活、赋予用户更多权限的 AI 工作台。第四种现在也在探索,将多个 Agent 进行角色编排,看看能否解决更复杂的问题。
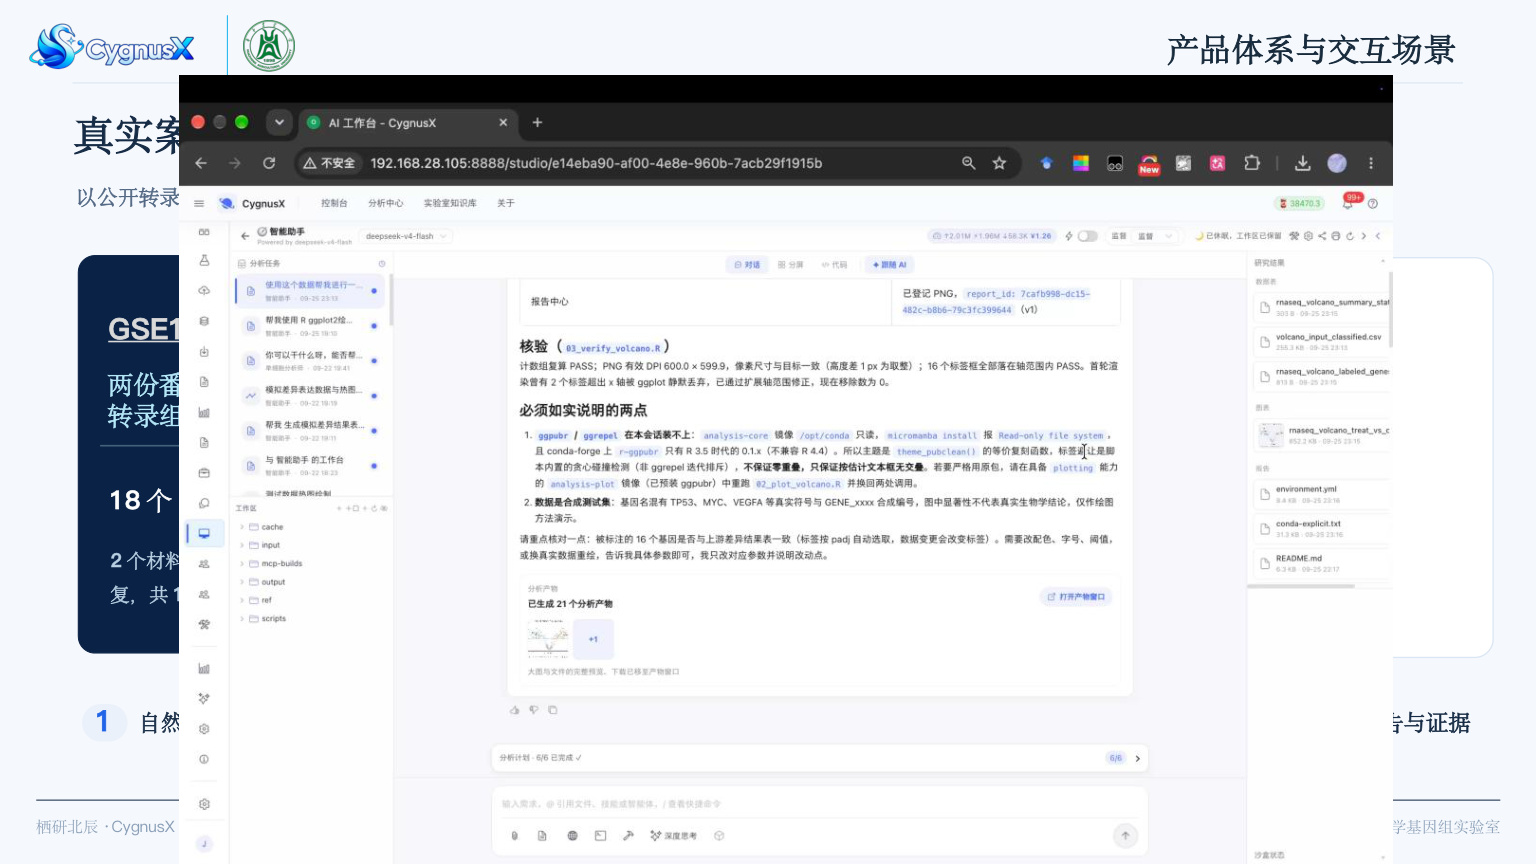
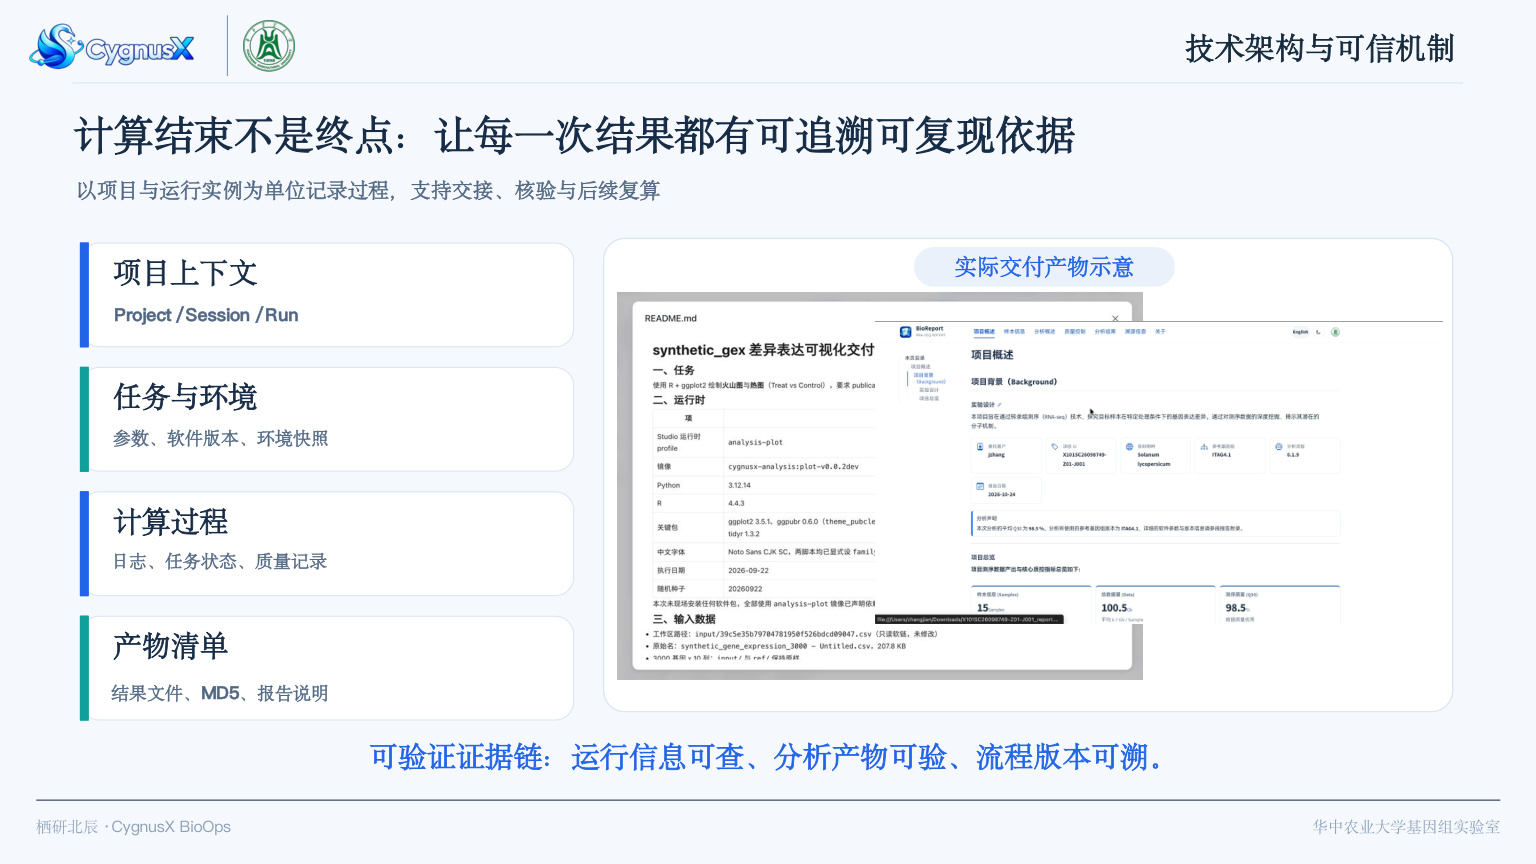
这是一个实例,时间快到了,我就很快过了。已经实现从数据发现到可追溯报告的完整交付,报告最后形成完整校验,相关信息汇总其中,实现可追溯。项目交付后,用户有新需求,可以通过 AI 工作台输入,比如调整某个图、某个代码,平台很快分析,回复可追溯报告。
这个也是旧版本。我们把上游、下游分开:上游是重资产的成熟体系,只负责计算,在平台 Agent 调度下,把表达矩阵、样本信息、样本质量情况和原始数据给 Agent。Agent 在597项生命科学 Skill 基础上进行灵活科研探索。科研探索包括确定性计算和灵活探索两步,这样才能推动科研领域向前进。
部署、效率与后续学科方向
如何实现可追溯?我们对项目上下文、任务和环境、计算过程、产物清单做详细汇总。现阶段已在华中农业大学园艺相关学院部署,实现提交任务、查看运行状态、打开报告和验证报告,同时基于沉淀的 Skill、Agent 进行定制分析。
对于提效,标准分析流程可以从20分钟压缩到5分钟,增量需求从8小时压缩到30分钟。定制化流程之前需要生信专家,或者熟悉领域的人定制,可以从五天压缩到一天。跨项目、跨长时间、跨多人员的历史项目,可以用十分钟完成可追溯、可核验报告的追踪。
上面仅仅解决生命科学领域可复现、可信的问题。不知道大家听没听耿同学的,耿同学最近可能曝了生命科学领域的一些问题嘛。我们主要解决可信、可追溯。和华中农业大学合作,是想基于平台使用,沉淀一系列高质量数据。真正生命科学领域高质量数据很少,我们想结合华中农业大学的 A+ 学科园艺学,训练高质量园艺垂直领域模型。基于这个模型,真正实现让 AI 推动科学发展。还会和作物等其他学科合作。
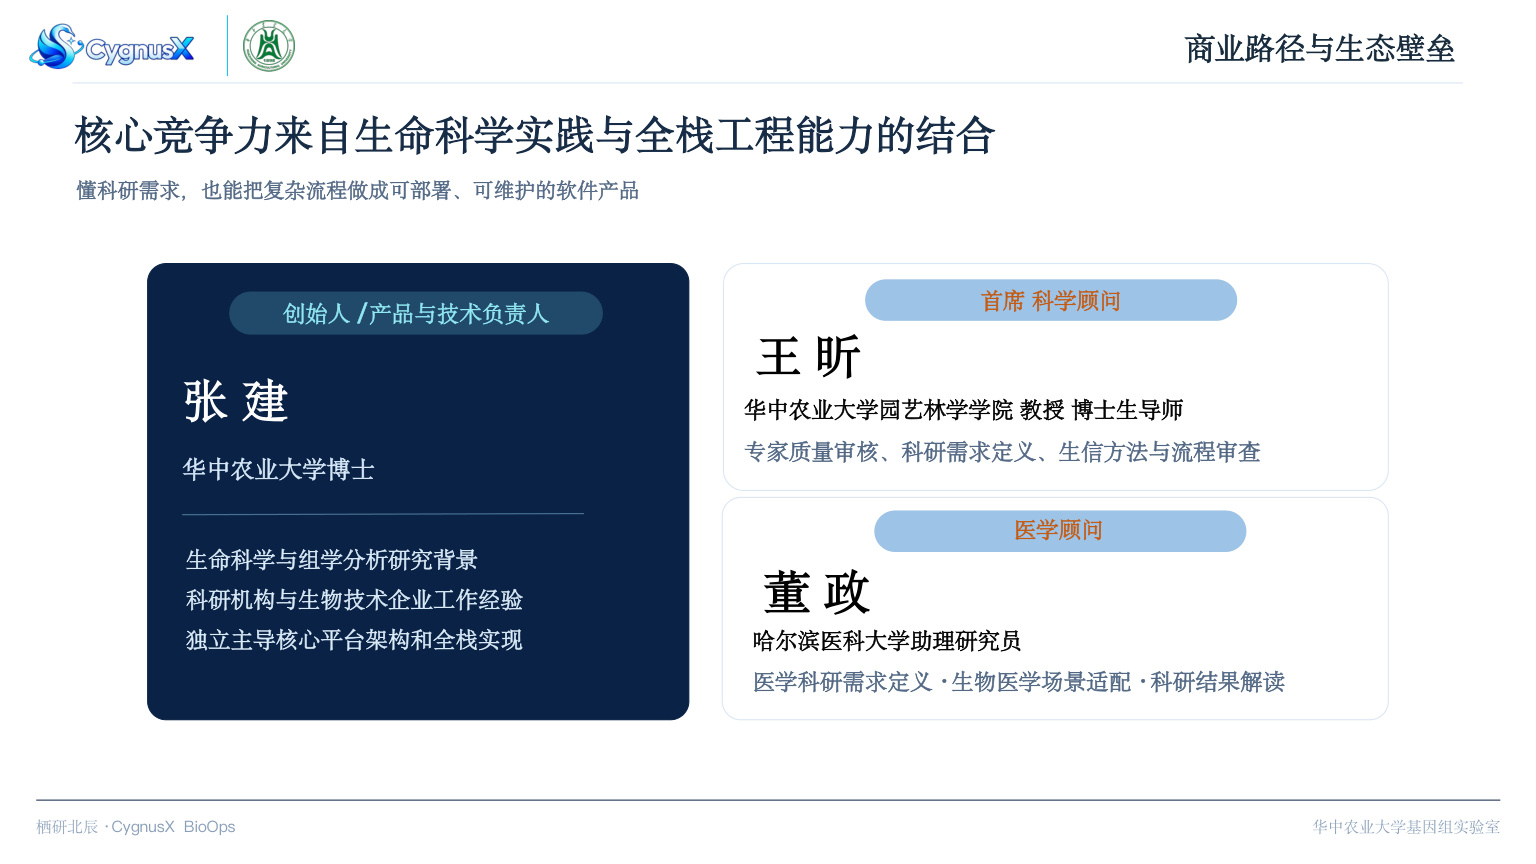
下面是团队为什么能做这件事。我们团队是生命科学领域和工程能力的复合型团队。最后感谢各位观众,感谢各位评委老师。
为什么生命科学流程需要额外强调复现?
根据张建的演讲,科研任务可能涉及上千步骤和较长周期,参数、软件版本或关键节点出错,会带来时间、算力及样本成本。通用Agent还可能遇到长期规划和上下文稀释问题。平台因此将标准计算与环境、参数、版本封存结合,把结果与其产生过程放在同一个项目记录中。
标准计算与科研探索如何分工?
根据张建的演讲,平台将上下游分开,成熟的上游负责计算,向Agent提供表达矩阵、样本信息及质量等数据;Agent在沉淀的领域Skill基础上开展灵活探索。确定性的计算与需要调整的问题探索各有职责,目的在于让灵活性建立在受控、可回查的计算基础上。
当前交付与后续模型计划有什么区别?
根据张建的演讲,当前平台已展示任务提交、执行监控、报告核验及定制分析链路,重点解决可复现和可追溯。团队希望随着平台使用积累高质量生命科学数据,再结合园艺等学科训练垂直领域模型。这一模型训练与拓展方向应作为计划理解,不能写成已经完成的新模型成果。